
C++で解く二分木の「ノードと祖先の最大差」アルゴリズム
二分木のルートが与えられたとき、異なる2つのノードAとB(AはBの祖先)が存在し、V = |Aの値 − Bの値| となるような最大値Vを求める問題を考えてみましょう。
例えば、次のような二分木が与えられた場合を考えます。
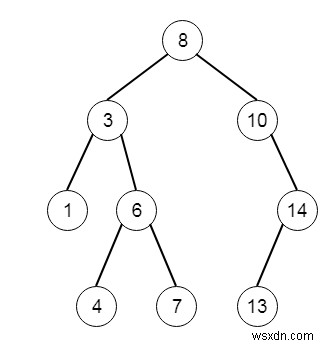
この場合、出力は 7 となります。祖先と子孫のノード間の差は [(8 - 3), (7 - 3), (8 - 1), (10 - 13)] のようになり、その中で最大なのは (8 - 1) = 7 だからです。
解法のアプローチ
この問題を解くには、以下の手順に従います。
- まず、答えを格納する変数 ans を 0 で初期化します。
- solve() というメソッドを定義します。このメソッドは、ツリーのノード、現在の最小値 currMin、現在の最大値 currMax を引数に取ります。
- ノードが null の場合は何もせずに return します。
- ans を、「ans」「|ノードの値 - currMin|」「|ノードの値 - currMax|」の中の最大値で更新します。
- 左の子ノードに対して solve(左の子, min(ノードの値, currMin), max(ノードの値, currMax)) を再帰的に呼び出します。
- 右の子ノードに対しても同様に solve(右の子, min(ノードの値, currMin), max(ノードの値, currMax)) を呼び出します。
ポイントは、木を辿りながら各経路における最小値と最大値を同時に追跡することです。こうすることで、任意の祖先・子孫ペアの差の最大値を効率的に求められます。
実装例
理解を深めるために、以下のC++による実装を見てみましょう。
#include <bits/stdc++.h>
using namespace std;
class TreeNode{
   public:
   int val;
   TreeNode *left, *right;
      TreeNode(int data){
      val = data;
      left = NULL;
      right = NULL;
   }
};
void insert(TreeNode **root, int val){
   queue<TreeNode*> q;
   q.push(*root);
   while(q.size()){
      TreeNode *temp = q.front();
      q.pop();
      if(!temp->left){
         if(val != NULL)
            temp->left = new TreeNode(val);
         else
            temp->left = new TreeNode(0);
         return;
      }else{
         q.push(temp->left);
      }
      if(!temp->right){
         if(val != NULL)
            temp->right = new TreeNode(val);
         else
            temp->right = new TreeNode(0);
         return;
      }else{
         q.push(temp->right);
      }
   }
}
TreeNode *make_tree(vector<int> v){
   TreeNode *root = new TreeNode(v[0]);
   for(int i = 1; i<v.size(); i++){
      insert(&root, v[i]);
   }
   return root;
}
class Solution {
   public:
   int ans;
   void solve(TreeNode* node, int currMin, int currMax){
      if (!node || node->val == 0) return;
      ans = max({ans, abs(node->val - currMin), abs(node->val - currMax)});
      solve(node->left, min(node->val, currMin), max(node->val, currMax));
      solve(node->right, min(node->val, currMin), max(node->val, currMax));
   }
   int maxAncestorDiff(TreeNode* root) {
      ans = 0;
      solve(root, root->val, root->val);
      return ans;
   }
};
main(){
   vector<int> v = {8,3,10,1,6,NULL,14,NULL,NULL,4,7,13};
   TreeNode *root = make_tree(v);
   Solution ob;
   cout << (ob.maxAncestorDiff(root));
}
入力
[8,3,10,1,6,null,14,null,null,4,7,13]
出力
7
計算量について
このアルゴリズムは各ノードを一度だけ訪問するため、時間計算量は O(N)(Nはノード数)、再帰呼び出しによる空間計算量は木の高さに依存し、最悪の場合 O(N) となります。DFS(深さ優先探索)を使ったシンプルかつ効率的な解法と言えるでしょう。
-
C++における「struct」と「typedef struct」の違いとは?
```html 結論:C++では両者に実質的な違いはない C++において、「struct」を使った宣言と「typedef struct」を使った宣言の間には、実質的な違いがありません。その理由は、C++ではstruct、union、enum、classによるすべての宣言が、暗黙的にtypedefされたものと同じように扱われるためです。ただし、同じ名前を持つ別の宣言によってその名前が隠されている場合を除きます。 なぜ違いが生まれないのか C言語では、構造体を宣言しただけでは型名として直接使えず、「struct タグ名」という形式で記述する必要がありました。そのため、変数宣言のたびにstructキ
-
C++の文字リテラルと文字列リテラルの違いをわかりやすく解説
C++における文字リテラルと文字列リテラルの基本C++では、シングルクォート( )で囲まれた1文字は「文字リテラル」として扱われ、その型は char になります。例えば a は char 型であり、ASCIIベースのシステムでは整数値 97 を持ちます。一方、ダブルクォート( )で囲まれた1文字または複数文字の並びは「文字列リテラル」として扱われます。その型は const char[] であり、実体は「文字列の長さ + 1」のサイズを持つ配列です。この余分な1文字分は、文字列の終端を示すヌル文字(\0)として確保されています。具体的な違いのポイント文字リテラル: 原則として1文字のみを格納する