
C++で実装するジョンソン(Johnson)のアルゴリズム ― 全頂点間の最短経路を求めるプログラム
本記事では、グラフ上の頂点間の最短経路を求めるジョンソンのアルゴリズムについて解説します。紹介するC++プログラムでは、頂点の数・辺の数・各辺のコストを入力として受け取り、すべての頂点のペア間の最短距離を距離行列として出力します。
まず、次のようなグラフを例に考えてみましょう。
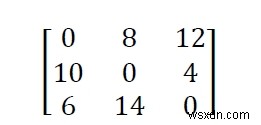
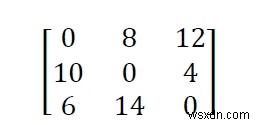
このグラフにおいて、各頂点間の最短経路は以下のようになります。プログラムは頂点数・辺数、そして各辺とそのコストを入力として受け取ります。
入力 − 頂点数:3
辺数:5
辺とコスト −
1 2 8
2 1 12
1 3 22
3 1 6
2 3 4
出力 − グラフの距離行列。
| 0 | 8 | 12 |
| 10 | 0 | 4 |
| 6 | 14 | 0 |
アルゴリズム
johnsonAlgorithm(cost)
入力 − 与えられたグラフのコスト行列。
出力 − 任意の頂点から任意の頂点への最短経路を格納した行列。
Begin
    コスト行列と同じ内容の別の行列「A」を作成する。i行目とj列目の間に辺が存在しない場合は、A[i,j]に無限大を設定する。
    for k := 1 to n, do
        for i := 1 to n, do
            for j := 1 to n, do
                A[i, j] = A[i, j] と (A[i, k] + A[k, j]) のうち小さい方
            done
        done
    done
    現在のA行列を表示する
End
処理の流れのポイント
- 隣接行列の初期化: 入力された辺のコストを隣接行列に格納し、辺が存在しない要素には無限大(ここでは定数INF)を設定します。対角成分(自分自身への距離)は0のままです。
- 経由頂点による緩和: 三重ループを用いて、「頂点iから頂点jへ直接向かう場合」と「頂点kを経由する場合」の距離を比較し、より小さい方で更新していきます。
- 計算量: 時間計算量はO(V³)、必要な記憶領域はO(V²)です。頂点数がそれほど多くない密なグラフに適しています。
なお、本来のジョンソンのアルゴリズムはベルマン・フォード法とダイクストラ法を組み合わせた手法ですが、ここで紹介する実装は動的計画法による全点対最短経路の計算手順(ワーシャル・フロイド法と同型のアプローチ)を採用しています。また、このシンプルな実装では辺のコストが非負であることを前提としています。
C++での実装例
#include<iostream>
#define INF 9999
using namespace std;
int min(int a, int b);
int cost[10][10], adj[10][10];
inline int min(int a, int b){
    return (a<b)?a:b;
}
main() {
    int vert, edge, i, j, k, c;
    cout << "Enter no of vertices: ";
    cin >> vert;
    cout << "Enter no of edges: ";
    cin >> edge;
    cout << "Enter the EDGE Costs:\n";
    for (k = 1; k <= edge; k++) { //入力を受け取り、adj行列とcost行列に格納する
        cin >> i >> j >> c;
        adj[i][j] = cost[i][j] = c;
    }
    for (i = 1; i <= vert; i++)
        for (j = 1; j <= vert; j++) {
            if (adj[i][j] == 0 && i != j)
                adj[i][j] = INF; //辺が存在しない場合は無限大を設定
        }
    for (k = 1; k <= vert; k++)
        for (i = 1; i <= vert; i++)
            for (j = 1; j <= vert; j++)
                adj[i][j] = min(adj[i][j], adj[i][k] + adj[k][j]); //頂点kを経由する場合のiからjへの最小距離を求める
    cout << "Resultant adj matrix\n";
    for (i = 1; i <= vert; i++) {
        for (j = 1; j <= vert; j++) {
             if (adj[i][j] != INF)
                 cout << adj[i][j] << " ";
        }
        cout << "\n";
    }
}
出力結果
Enter no of vertices: 3
Enter no of edges: 5
Enter the EDGE Costs:
1 2 8
2 1 12
1 3 22
3 1 6
2 3 4
Resultant adj matrix
0 8 12
10 0 4
6 14 0
このように、プログラムはすべての頂点のペア(i, j)についての最短距離を含む行列を出力します。例えば、頂点2から頂点1への最短距離は「2 → 3 → 1」という経路を通る10となり、直接の辺(コスト12)よりも短くなることが分かります。
-
補間探索(Interpolation Search)アルゴリズムをC++で実装する方法
補間探索とは二分探索では、リストを毎回等しい大きさの部分に分割しながら探索ら探索範囲を絞り込んでいきます。一方、補間探索では補間公式を使い、キーが存在すると推定されるおおよその位置を直接計算で求めます。推定位置が判明したら、その位置を基準にリストを分割して探索を進めます。毎回キーの正確な位置に近づこうとするため、探索にかかる時間を大幅に短縮できます。この手法は、データがソート済みであり、かつ値ができるだけ一様に分布している場合に特に高い効果を発揮します。キーの推定位置は次の式で求められます。estimate = start + ((key - array[start]) / (array[en
-
C++でFisher-Yatesアルゴリズムを実装し配列をランダムにシャッフルする方法
Fisher-Yatesアルゴリズムは、配列の要素に対してランダムな順列を生成するアルゴリズムです。すなわち、配列内の全要素をランダムにシャッフルします。このアルゴリズムは偏り(バイアス)を持たないため、考えられるすべての順列が等しい確率で現れるという特徴があります。 以下は、C++でFisher-Yatesアルゴリズムを実装し、配列をシャッフルするプログラム例です。 C++での実装例 #include <iostream> #include <cstdlib> using namespace std; int main() { int n;