
RedisとApache Kafkaで実現する時系列データ処理:デバイス監視パイプラインの構築ガイド
RedisTimeSeriesは、Redisにネイティブな時系列データ構造をもたらすRedisモジュールです。従来Sorted SetsやRedis Streamsの上に構築されていた時系列ソリューションは、RedisTimeSeriesが提供する大量データの高速挿入、低レイテンシ読み取り、柔軟なクエリ言語、ダウンサンプリングなどの機能によって、大きくメリットを得られます。
一般的に時系列データ自体は(比較的)シンプルです。しかし、実際の運用では以下のような特性も考慮する必要があります。
- データ速度:例えば、数千台のデバイスから毎秒数百のメトリクスが送られてくるようなケース
- データ量(ビッグデータ):数か月、場合によっては数年にわたるデータの蓄積
そのため、RedisTimeSeriesのようなデータベースはソリューションの一部にすぎません。すべてのデータを収集(インジェスト)し、処理して、RedisTimeSeriesへ送信する仕組みも必要になります。つまり、プロデューサーとコンシューマーを分離するバッファとして機能する、スケーラブルなデータパイプラインが求められるのです。
そこで登場するのがApache Kafkaです。Kafkaはコアとなるブローカーに加え、Kafka Connect(本記事のアーキテクチャでも採用)、多言語対応のクライアントライブラリ、Kafka Streams、Mirror Makerなど、豊富なエコシステムを持っています。
本記事では、RedisTimeSeriesとApache Kafkaを組み合わせて時系列データを分析する実践的な例を紹介します。
サンプルコードはGitHubリポジトリで公開しています:https://github.com/abhirockzz/redis-timeseries-kafka
まずはユースケースから見ていきましょう。なお、この例は説明をわかりやすくするために意図的にシンプルにしています。
シナリオ:デバイス監視
複数の場所(ロケーション)があり、それぞれの場所に複数のデバイスが設置されている状況を想定してください。あなたのタスクはデバイスメトリクスの監視です。今回は温度と圧力の2つの指標を扱います。これらのメトリクスはもちろんRedisTimeSeriesに保存され、キーは「<メトリクス名>:<ロケーション>:<デバイス>」という命名規則を使用します。例えば、ロケーション5のデバイス1の温度は「temp:5:1」で表されます。また、各時系列データポイントには「metric」「location」「device」というラベル(キーバリュー)も付与します。これにより、後述するように柔軟なクエリが可能になります。
TS.ADDコマンドを使ってデータポイントを追加する例をいくつか示します。
# ロケーション3のデバイス2の温度(ラベル付き):
TS.ADD temp:3:2 * 20 LABELS metric temp location 3 device 2
# ロケーション3のデバイス2の圧力:
TS.ADD pressure:3:2 * 60 LABELS metric pressure location 3 device 2
ソリューションアーキテクチャ
全体像は次のようになっています。
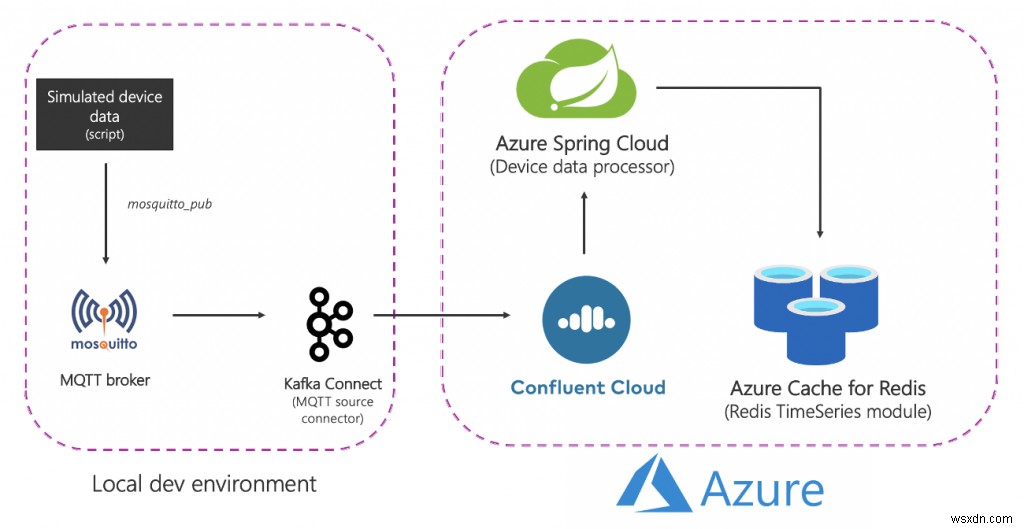
各コンポーネントを分解してみましょう。
ソース側(ローカル)コンポーネント
- MQTTブローカー(mosquitto):MQTTはIoTユースケースにおける事実上の標準プロトコルです。今回のシナリオはIoTと時系列の組み合わせとなります。
- Kafka Connect:MQTTソースコネクタを使用して、MQTTブローカーからKafkaクラスタへデータを転送します。
Azureサービス
- Azure Cache for Redis(Enterprise階層):Enterprise階層は、Redis社が提供する商用版であるRedis Enterpriseをベースにしています。RedisTimeSeriesに加え、RediSearchやRedisBloomもサポートしています。Enterprise階層ではライセンス取得を顧客が心配する必要はなく、Azure Marketplaceオファーを通じてライセンスの取得と支払いが行えます。
- Azure向けConfluent Cloud:Apache Kafkaをサービスとして提供するフルマネージド型の offering です。AzureからConfluent Cloudへの統合プロビジョニング層により、クロスプラットフォーム管理の負担を軽減し、Azureインフラ上でのConfluent Cloud利用に統合された体験を提供します。これにより、Confluent CloudをAzureアプリケーションと簡単に統合できます。
- Azure Spring Cloud(Azure Spring Apps):Spring BootマイクロサービスをAzureへ簡単にデプロイできます。インフラ管理の負担を軽減し、構成管理、サービスディスカバリー、CI/CD統合、ブルー/グリーンデプロイメントなどを提供します。開発者はコードに集中できるようになります。
※説明を簡潔にするため、一部のサービスはローカルでホストしています。本番環境ではこれらもAzure上で実行することをお勧めします。例えば、Kafka ConnectクラスタとMQTTコネクタはAzure Kubernetes Service上で運用できます。
まとめると、エンドツーエンドの流れは以下の通りです。
- スクリプトがシミュレートされたデバイスデータを生成し、ローカルのMQTTブローカーへ送信します。
- このデータはMQTT Kafka Connectソースコネクタが取得し、Azure上のConfluent Cloud Kafkaクラスタのトピックへ送られます。
- Azure Spring CloudでホストされているSpring Bootアプリケーションがさらに処理を行い、Azure Cache for Redisインスタンスに永続化します。
それでは実践的な作業に入りましょう。その前に、以下の準備が必要です。
前提条件
- Azureアカウント(無料アカウントを取得可能)
- Azure CLIのインストール
- JDK 11(例:OpenJDK)
- 最新バージョンのMavenとGit
インフラコンポーネントのセットアップ
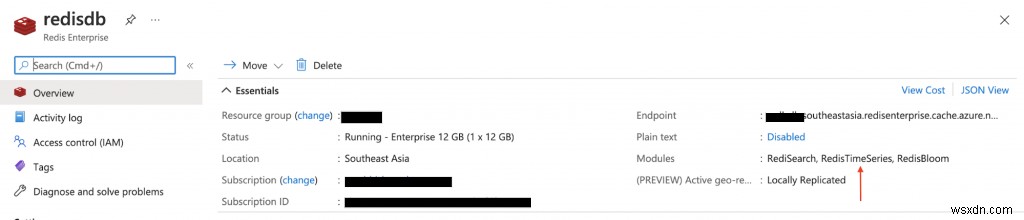
まず、RedisTimeSeriesモジュールを含むAzure Cache for Redis(Enterprise階層)を公式ドキュメントに従ってプロビジョニングします。
次に、Azure MarketplaceでConfluent Cloudクラスタをプロビジョニングします。Kafkaトピックを作成し(トピック名はmqtt.device-stats)、後ほど安全にクラスタへ接続するための認証情報(APIキーとシークレット)も作成しておいてください。
Azure Spring Cloudのインスタンスは、AzureポータルまたはAzure CLIで作成できます。
az spring-cloud create -n <Azure Spring Cloudサービス名> -g <リソースグループ名> -l <ロケーション 例:southeastasia>
先へ進む前に、GitHubリポジトリをクローンしておきましょう。
git clone https://github.com/abhirockzz/redis-timeseries-kafka
cd redis-timeseries-kafka
ローカルサービスのセットアップ
ローカルで動かすコンポーネントは以下の通りです。
- Mosquitto MQTTブローカー
- MQTTソースコネクタ付きのKafka Connect
- ダッシュボードで時系列データを追跡するためのGrafana
MQTTブローカー
ここではMacにmosquittoブローカーをインストールして起動します。
brew install mosquitto
brew services start mosquitto
お使いのOSに応じた手順を実施するか、Dockerイメージを利用しても構いません。
Grafana
同様に、MacにGrafanaをインストールして起動します。
brew install grafana
brew services start grafana
OSごとの手順でも、Dockerイメージでも問題ありません。
docker run -d -p 3000:3000 --name=grafana -e "GF_INSTALL_PLUGINS=redis-datasource" grafana/grafanaKafka Connect
クローンしたリポジトリ内にconnect-distributed.propertiesファイルがあるはずです。bootstrap.servers、sasl.jaas.configなどのプロパティ値を自分の環境に合わせて書き換えてください。
まず、Apache Kafkaをローカルにダウンロードして解凍します。
ローカルのKafka Connectクラスタを起動:
export KAFKA_INSTALL_DIR=<Kafkaのインストールディレクトリ 例:/home/foo/kafka_2.12-2.5.0>

$KAFKA_INSTALL_DIR/bin/connect-distributed.sh connect-distributed.properties
MQTTソースコネクタを手動でインストールする場合は:
- 配布ページからコネクタ/プラグインのZIPファイルをダウンロードし、
- Connectワーカーのplugin.path設定プロパティに記載されているディレクトリのいずれかに展開します
Confluent Platformをローカルで使っている場合は、Confluent Hub CLIを使うだけです: confluent-hub install confluentinc/kafka-connect-mqtt:latest
MQTTソースコネクタインスタンスの作成
mqtt-source-config.jsonファイルを確認し、kafka.topicには適切なトピック名を入力してください。mqtt.topicsは変更しないでください。
curl -X POST -H 'Content-Type: application/json'
https://localhost:8083/connectors -d @mqtt-source-config.json

# コネクタステータスの確認まで少し待ってから実行
curl https://localhost:8083/connectors/mqtt-source/status
デバイスデータ処理アプリケーションのデプロイ
クローンしたリポジトリのconsumer/src/resourcesフォルダにあるapplication.yamlファイルを開き、以下の値を書き換えます。
- Azure Cache for Redisのホスト名、ポート、プライマリアクセスキー
- Azure向けConfluent CloudのAPIキーとシークレット
アプリケーションのJARファイルをビルドします。
cd consumer

export JAVA_HOME=<絶対パスを指定 例:/Library/Java/JavaVirtualMachines/zulu-11.jdk/Contents/Home>

mvn clean package
Azure Spring Cloudアプリケーションを作成し、JARファイルをデプロイします。
az spring-cloud app create -n device-data-processor -s <Azure Spring Cloudインスタンス名> -g <リソースグループ名> --runtime-version Java_11

az spring-cloud app deploy -n device-data-processor -s <Azure Spring Cloudインスタンス名> -g <リソースグループ名> --jar-path target/device-data-processor-0.0.1-SNAPSHOT.jar
シミュレートされたデバイスデータ生成の開始
クローンしたリポジトリ内のスクリプトを使用します。
./gen-timeseries-data.sh補足—このスクリプトはmosquitto_pub CLIコマンドを使ってデータを送信しているだけです。
データはdevice-statsというMQTTトピック(Kafkaトピックではありません)に送られます。CLIサブスクライバーで確認できます。
mosquitto_sub -h localhost -t device-statsConfluent CloudポータルでKafkaトピックを確認しましょう。あわせて、Azure Spring Cloud上のデバイスデータ処理アプリのログもチェックします。
az spring-cloud app logs -f -n device-data-processor -s <Azure Spring Cloudインスタンス名> -g <リソースグループ名>Grafanaダッシュボードを楽しもう!
ブラウザでlocalhost:3000にアクセスしてGrafana UIを開きます。
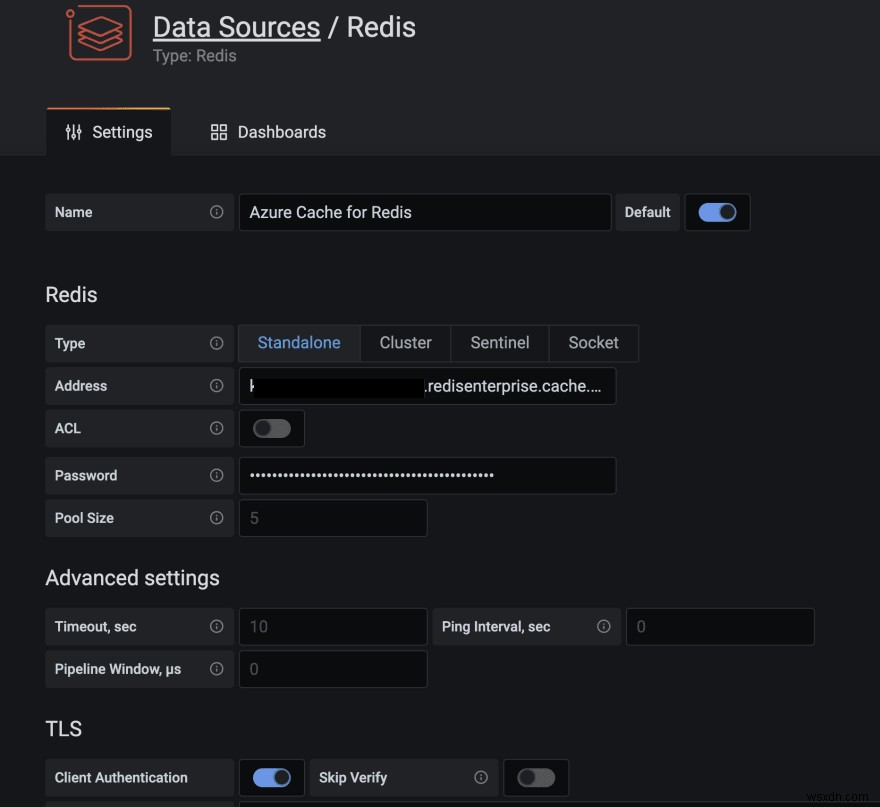
GrafanaのRedis Data Sourceプラグインは、Azure Cache for Redisを含むあらゆるRedisデータベースで動作します。こちらのブログ記事の手順に従ってデータソースを設定してください。
クローンしたリポジトリのgrafana_dashboardsフォルダにあるダッシュボードをインポートします(インポート方法についてはGrafana公式ドキュメントを参照してください)。
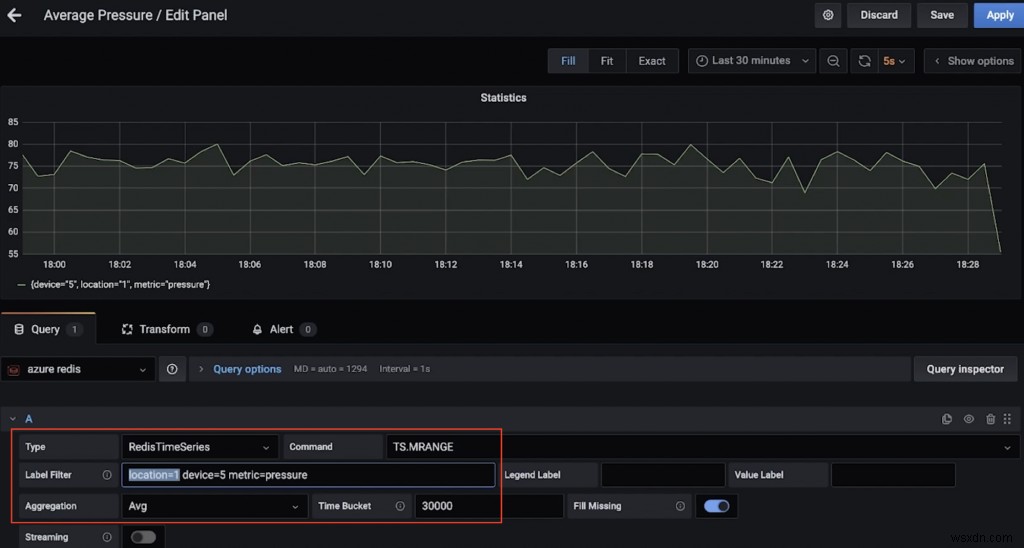
例えば、次のダッシュボードはロケーション1のデバイス5について30秒間の平均圧力を表示しています(TS.MRANGEを使用)。
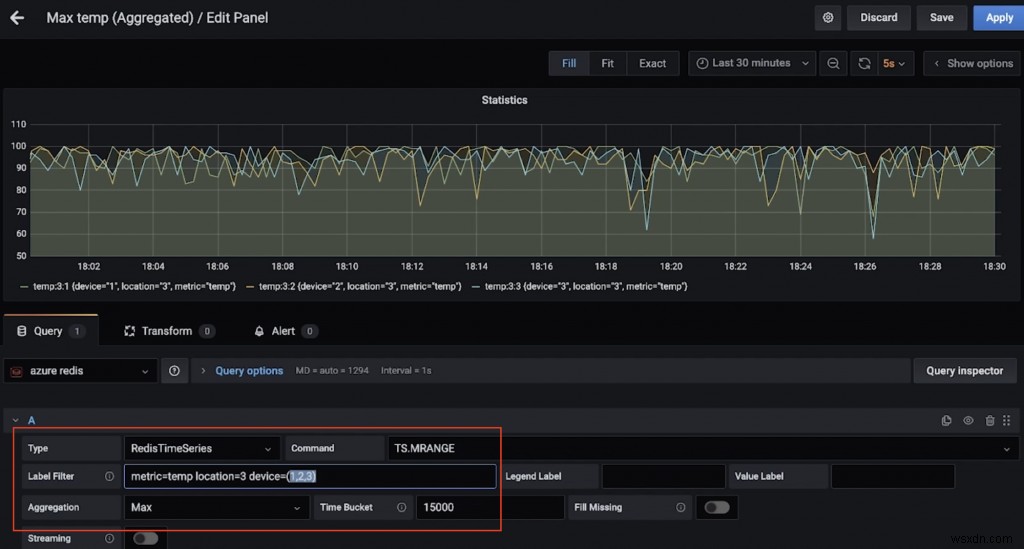
もう一つのダッシュボードは、ロケーション3の複数デバイスについて15秒間の最高温度を表示しています(こちらもTS.MRANGEのおかげです)。
RedisTimeSeriesのコマンドを試してみよう
redis-cliを起動して、Azure Cache for Redisインスタンスに接続します。
redis-cli -h <Azure Redisのホスト名 例:myredis.southeastasia.redisenterprise.cache.azure.net> -p 10000 -a <Azure Redisアクセスキー> --tlsまずはシンプルなクエリから始めましょう。
# ロケーション1のデバイス5の圧力
TS.GET pressure:1:5

# ロケーション4のデバイス5の温度
TS.GET temp:4:5ロケーションでフィルタリングし、すべてのデバイスの温度と圧力を取得します。
TS.MGET WITHLABELS FILTER location=3特定の時間範囲内で、1つまたは複数のロケーションにある全デバイスの温度と圧力を抽出します。
TS.MRANGE - + WITHLABELS FILTER location=3
TS.MRANGE - + WITHLABELS FILTER location=(3,5)
「- +」は最初から最新のタイムスタンプまでの全範囲を意味しますが、より具体的な範囲を指定することもできます。
MRANGEこそが必要だった機能です!特定のロケーション内の特定のデバイスでフィルタリングし、さらに温度や圧力で絞り込むこともできます。
TS.MRANGE - + WITHLABELS FILTER location=3 device=2
TS.MRANGE - + WITHLABELS FILTER location=3 metric=temp
TS.MRANGE - + WITHLABELS FILTER location=3 device=2 metric=temp
これらはすべて集計と組み合わせることができます。
# すべての温度データポイントは有用とは限りません。平均(または最大)の方が便利かもしれません。
TS.MRANGE - + WITHLABELS AGGREGATION avg 10000 FILTER location=3 metric=temp
TS.MRANGE - + WITHLABELS AGGREGATION max 10000 FILTER location=3 metric=temp
集計ルールを作成し、結果を別の時系列に保存することも可能です。
作業が終わったら、不要なコストを避けるためリソースの削除を忘れないでください。
リソースの削除
- ドキュメントの手順に従ってConfluent Cloudクラスタを削除します。必要なのはConfluent組織の削除だけです。
- 同様に、Azure Cache for Redisインスタンスも削除してください。
ローカルマシン上では:
- Kafka Connectクラスタを停止する
- mosquittoブローカーを停止する(例:brew services stop mosquitto)
- Grafanaサービスを停止する(例:brew services stop grafana)
ここまで、RedisとKafkaを使用して時系列データを収集・処理・照会するためのデータパイプラインを構築しました。本番環境グレードのソリューションへ進む際には、さらにいくつか検討すべき点があります。
追加の考慮事項
RedisTimeSeriesの最適化
- 保持ポリシー(Retention policy):時系列データポイントはデフォルトではトリミングも削除もされないため、必ず検討しましょう。
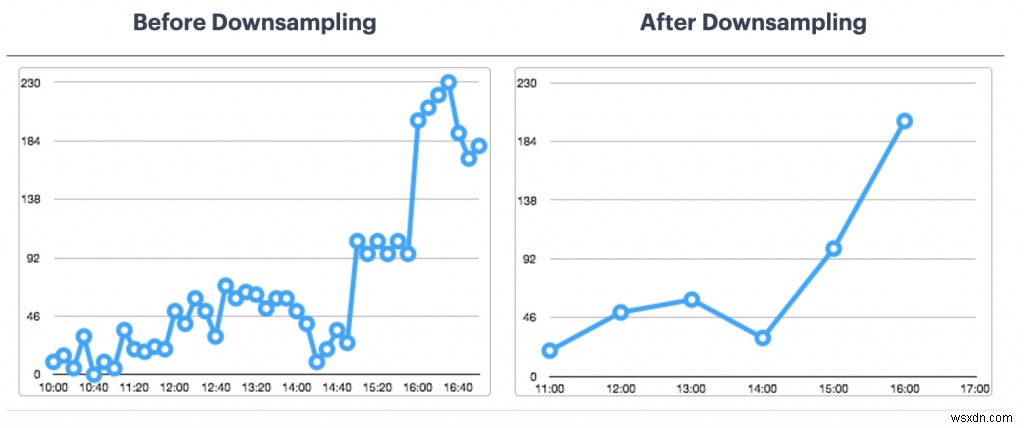
- ダウンサンプリングと集計ルール:データを永久に保存し続けたいわけではないはずです。適切なルールを設定して対応しましょう(例:TS.CREATERULE temp:1:2 temp:avg:30 AGGREGATION avg 30000)。
- 重複データポリシー:重複サンプルをどう扱うか決めておく必要があります。デフォルトのポリシー(BLOCK)が本当に要件に合っているか確認し、そうでなければ他のオプションを検討してください。
これは網羅的なリストではありません。その他の設定オプションについては、RedisTimeSeriesの公式ドキュメントを参照してください。
長期データ保持はどうする?
データは貴重な資産であり、時系列データも例外ではありません。さらなる処理(機械学習によるインサイト抽出や予知保全など)に活用したい場合もあるでしょう。そのためには長期間のデータ保持が必要で、コスト効率とパフォーマンスを両立するなら、Azure Data Lake Storage Gen2(ADLS Gen2)のようなスケーラブルなオブジェクトストレージサービスが最適です。
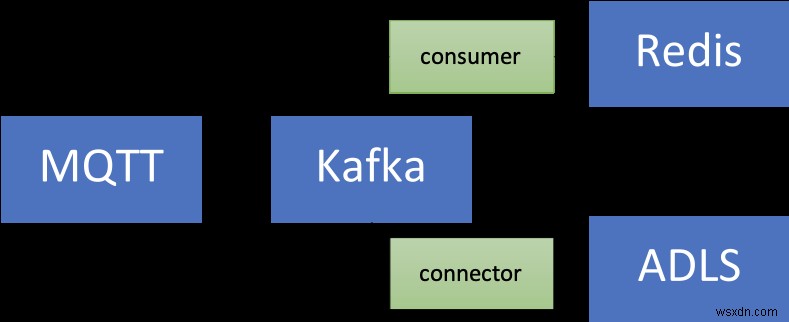
なんと、そのためのコネクタも存在します!フルマネージドのAzure Data Lake Storage Gen2 Sink Connector(for Confluent Cloud)を使えば、既存のデータパイプラインを拡張し、ADLSにデータを保存した上で、Azure Synapse AnalyticsやAzure Databricksで機械学習を実行できます。
スケーラビリティ
時系列データの量は増える一方です。ソリューションのスケーラビリティは極めて重要です。
- コアインフラ:マネージドサービスを活用すれば、チームはインフラの構築や保守ではなくソリューション本体に集中できます。特にRedisやKafkaのような複雑な分散システムにおいては大きなメリットです。
- Kafka Connect:データパイプラインの観点では心強い存在です。Kafka Connectプラットフォームは本質的にステートレスで水平スケール可能であり、ワーカークラスタのアーキテクチャやサイジングの選択肢は非常に豊富です。
- カスタムアプリケーション:本ソリューションのようにKafkaトピックのデータを処理するカスタムアプリケーションにも、同じスケーラビリティ特性が当てはまります。水平スケールの上限は基本的にKafkaトピックのパーティション数のみです。
統合性
統合先はGrafanaだけではありません!RedisTimeSeriesはPrometheusやTelegrafとも連携できます。ただし、本記事の執筆時点ではKafkaコネクタはまだ提供されていません。これはぜひ追加してほしい機能ですね。
まとめ
Redisはほぼ何にでも使えます。時系列ワークロードも例外ではありません!ただし、時系列データソースからRedis、そしてその先までのデータパイプラインと統合のためのエンドツーエンドアーキテクチャを必ず考慮してください。
-
サーバーレスRedisとReact Nativeで実現するアプリ内アナウンス機能の作り方
モバイルアプリでは、重要なお知らせや警告、利用ガイドなどをエンドユーザーに届けたい場面がよくあります。その手段のひとつが「アプリ内アナウンス」です。本記事では、サーバーレスRedisを活用してユーザーへアナウンスを配信するモバイルアプリを実際に構築します。アプリ開発にはReact Nativeを使用し、サーバーレスRedisにはUpstashを採用して、アプリから直接接続する構成を実装します。アプリ内アナウンスとは?アプリ内アナウンスとは、重要な情報を伝えたり、ユーザーの操作について通知したり、特定の場所へ誘導したりするために、エンドユーザーへ送信されるメッセージのことです。この仕組みを使えば
-
Nuxt 3とサーバーレスRedis(Upstash)で始めるページ訪問カウント実装
Nuxt 3とサーバーレスRedis(Upstash)で始めるページ訪問カウント実装 アプリケーションの利用状況を追跡したり、リソース利用を制限したり、キャッシュからデータを取得してパフォーマンスを向上させたりする必要がある場合、Redisがその答えとなります。Redisはインメモリのキー・バリュー型データベースであり、オープンソースで「Remote Dictionary Server」の略称です。 この記事では、サーバーレスRedisサービスであるUpstashと、Vue SSRフレームワークの最新ベータ版であるNuxt 3を組み合わせた基本的なアプリケーション構築を通じて、Redisの基礎