
ノーコードでOK!Chrome拡張機能「Data Miner」を使ってWebページからデータを抽出する方法
Webページから情報をコピー&ペーストして、手作業でスプレッドシートに転記していませんか?もしそうなら、「データスクレイピング(Webスクレイピング)」という手法をご存じないか、あるいは存在は知っていても「数時間のクリック作業を省くためだけにプログラミングを学ぶ気にはなれない」と考えているのかもしれません。
どちらの場合でも心配はいりません。現在はコーディング不要で使えるデータスクレイピングツールが数多く存在し、その中でも「Data Miner」のChrome拡張機能は特に直感的に操作できる選択肢の一つです。運が良ければ、やりたい作業がすでにツール内の「レシピ集(Recipe)」として登録されており、自分でポチポチと設定する手間すら省けるかもしれません。
Data Minerの仕組み
Data Minerは、読み込んだページのテキストを解析することで、Webページ上のデータを整形されたExcel/CSVファイルへと書き出すツールです。そのため、HTMLのパターンをある程度見分けられるレベルの知識は必要ですが、高度なものは求められません。HTMLやJavaScriptのスキルがあれば一部の複雑なタスクで役立ちますが、ほとんどのケースでは必須ではありません。また、出力結果をきれいに整理できるよう、スプレッドシートの基本操作ができると安心です。
1. Data Minerをセットアップする
まず、ChromeまたはChromium系ブラウザに拡張機能をインストールしましょう。ツールバーにつるはし型のアイコンが表示され、クリックするとアカウント作成ページへ移動します。無料版では月500回までスクレイピング可能です。毎日使うのでなければ、十分すぎる回数といえるでしょう。
2. データを読み込む
次に、データを抽出したいページにアクセスします。データが複数ページにまたがっていたり、ボタンの裏に隠れていたりしても問題ありません。まずはプログラムに「何を探せばいいか」を認識させるためのサンプルとなる1ページを用意すればOKです。
3. 既存のレシピを確認する
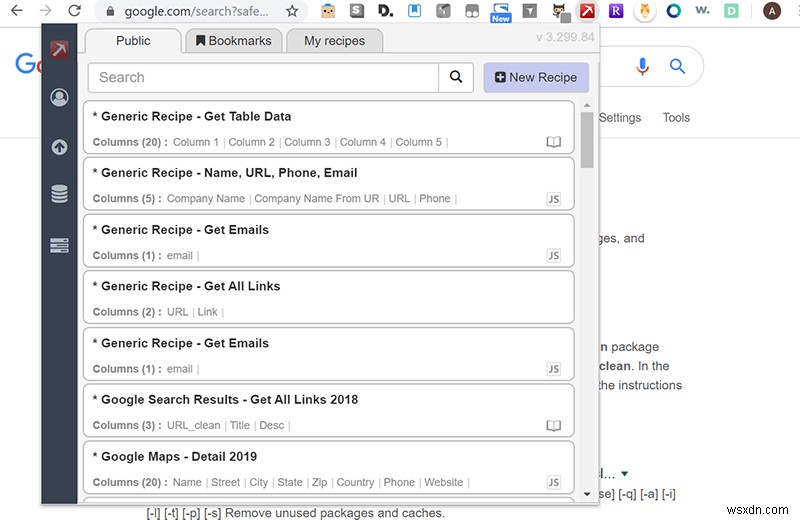
Data Minerを開き、「Public」タブで既存のレシピがないかチェックしましょう。人気サイトであれば、誰かがすでに目的のデータ取得プロセスを作成している可能性があり、大幅な時間短縮になります。たとえばGoogle、Amazon、Twitterなどには、リンクや価格、テキストなどを即座にダウンロードできるレシピが多数公開されています。「Run」ボタンを押せば生成されるスプレッドシートのプレビューを確認でき、「Edit」ボタンから既存レシピを自分用にカスタマイズすることも可能です。
4. ページタイプを選択する
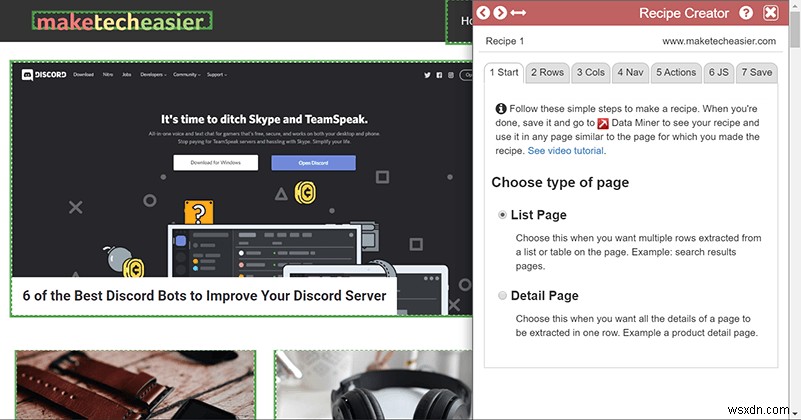
既製のレシピが見つからなかった場合は、自分で作りましょう。「New Recipe」ボタンをクリックして開始します。
最初に選択するのは「List Page(一覧ページ)」か「Detail Page(詳細ページ)」のどちらかです。
1つのページから複数行のデータを取得したい場合は「List Page」を選びます。たとえば検索結果すべてのリンクとページタイトルをダウンロードしたり、フィード内の投稿の日付と本文を取得したりするケースが該当します。これが最も一般的なタイプで、本記事でもこのタイプを例に解説します(詳細ページの手順も基本的には同じです)。
一方、1つのページに1つの対象に関するさまざまな情報がまとまっている場合は「Detail Page」を選択します。商品ページで価格・説明文・リンク・評価を1行にまとめて取得したい場合などが典型例です。
5. 行(Row)を作成する
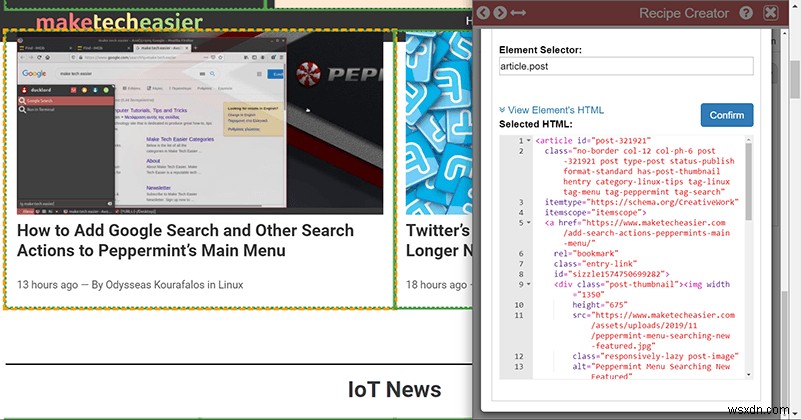
「Find」ボタンを押してマウスを移動し、黄色の選択ボックスが最終的なスプレッドシートの1エントリー分のデータ全体を覆うように調整します。たとえば検索結果をダウンロードするなら、タイトル・URL・説明文をすべて含む範囲を選択します。これらは次のステップでそれぞれ別の列に振り分けられます。確定するにはShiftキーを押してください。誤ってクリックしても心配無用。Data Minerはページを離れてもレシピの進捗を自動保存してくれます。
続いて、「Element's Classes」または「HTML Element Type」セクションのチェックボックスを少なくとも1つオンにします。うまくいくと、選択した要素と同じカテゴリに属するページ上の全要素に対して、選択範囲が自動的に複製されるはずです。
もしセレクターが必要な範囲をカバーしきれない場合は、要素を1つだけ選んで「Select Parent」を押してみてください。選択ボックスが大きくなり、必要なデータをすべて捕捉できることが多いです。それでもダメなら、HTMLを少し掘り下げて、対象要素のクラスやタイプを特定する必要があるかもしれません。迷ったら、選択ボックスが「リスト項目1つ分より大きくならない限界」まで「Select Parent」を押すのがおすすめです。そうすることで、後の列選択の自由度が高まります。
Data Minerでは下部の「View Element's HTML」オプションでHTMLを確認できるほか、カスタムセレクターを直接入力することも可能です。たとえばclass属性が「product」のリンクをすべて取得したいなら、a.productと入力するだけです。ここでHTML/CSSの基礎知識が真価を発揮します。
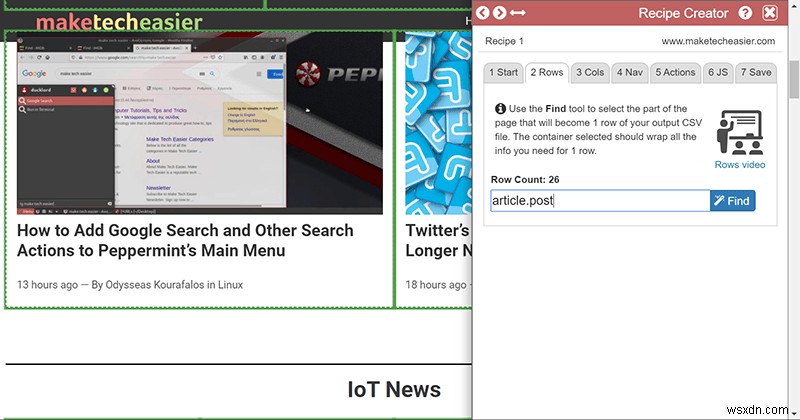
メインの行メニューに戻ると、「Row Count」としてレシピが生成するエントリー数が表示されます。数が合っていない場合は、行の選択を見直しましょう。
6. データを列に分割する
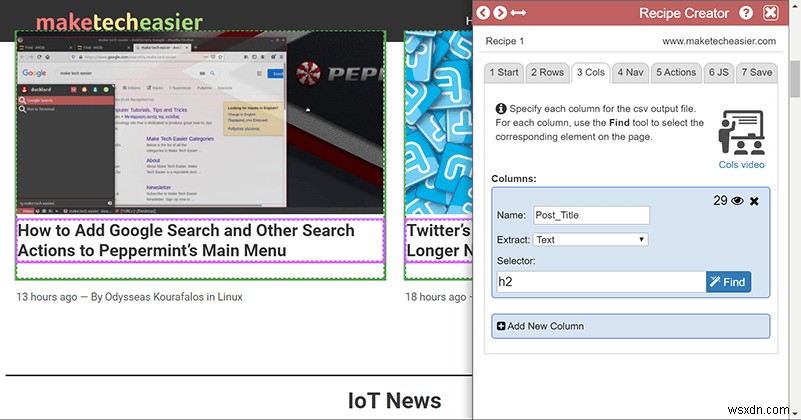
行に必要なデータをすべて選択できたら、次は列ごとのカテゴリに細分化して見栄えを整えます。ここでの選択は、必ず行として選んだボックスの一部分になるようにしてください。
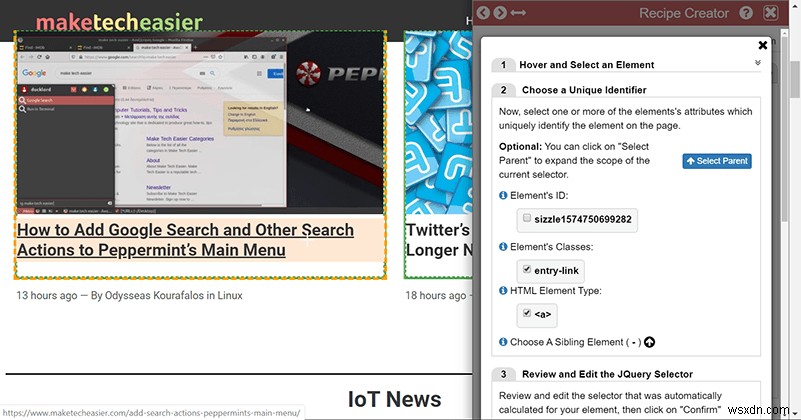
列を作るには、列名を入力して「Find」ボタンで抽出したい部分を選択するだけです。手順は行を作ったときと同じです。よく使うデータタイプはテキスト・URL・画像URLの3つでしょう。テキストリンクにカーソルを合わせてURLを取得するのは少しコツが要ります。「select parent」を押して、要素タイプが<a>(リンク用のHTMLタグ)の階層に達するまで親要素をたどる必要があるかもしれません。
列の中身が正しいデータかどうか確認するには、各列名の右側にある目のアイコン(選択済み列数の数字の横)をクリックします。その列の全行のプレビューが表示されます。おかしな箇所があれば戻って、行を識別するためのタグやタイプを調整しましょう。遠慮なくHTMLビューアーを開いて、取得したいデータに関連するパターンを探すのが成功のコツです。
7. 次ページへの移動方法を指定する
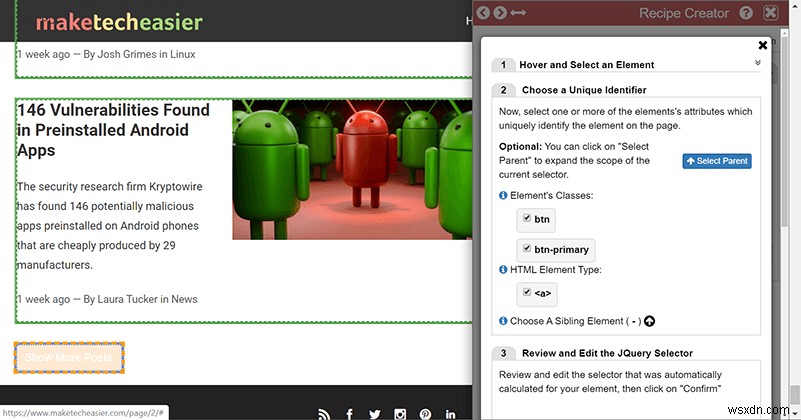
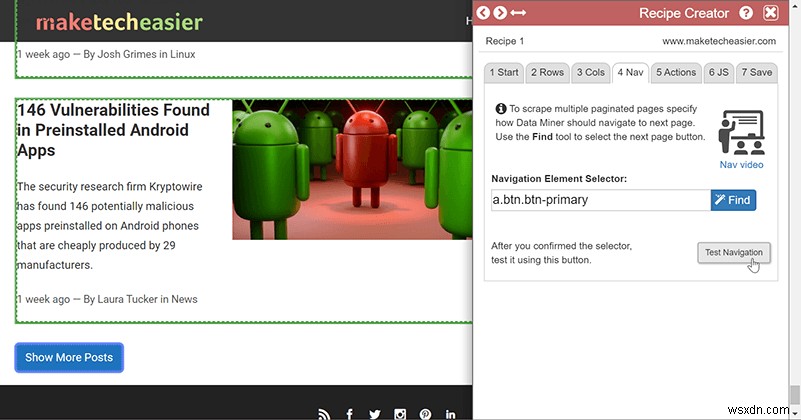
複数ページにまたがるデータを抽出する場合、毎ページ手動でレシピを実行し直すのは非効率です。そこで、次ページへ進むためのナビゲーションボタンの場所をData Minerに教えてあげましょう。注意点として、「Page 2」のような固定ページ番号のボタンを指定してはいけません。それだと常に2ページ目に飛ぶだけになってしまいます。ここでも<a>要素を選択していることを確認し、「Test Navigation」ボタンで正常に動作するかテストしておきましょう。
8. クリックやスクロールでデータを読み込む場所を指定する
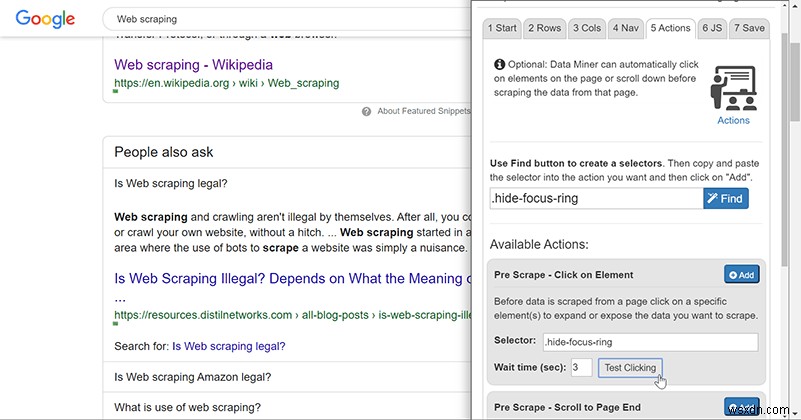
中には、何かをクリックしたり下にスクロールしたりするまでデータを読み込まないページもあります。幸い、Data Minerはこうした操作にも対応しています。画面上部の「Find」ツール(この頃には使いこなせているはず)で操作対象の要素を選択し、そのセレクターを適切なボックスに入力してテストすればOKです。
どのセレクターが要素や無限スクロールバーを起動するのかを見極めるのは少し難しいですが、HTMLの基礎知識と試行錯誤があれば十分対応できます。操作対象の多くはJavaScriptベースですが、Data Minerはアクションに紐づくCSSセレクターさえわかれば動作するため、ほとんどの場合コードを触る必要はありません。
さらに先のステップではカスタムJSを追加して自由に処理を組むこともできますが、これはかなり高度な内容なので、基本的なスクレイピングの範囲では不要でしょう。
9. レシピを保存して実行する
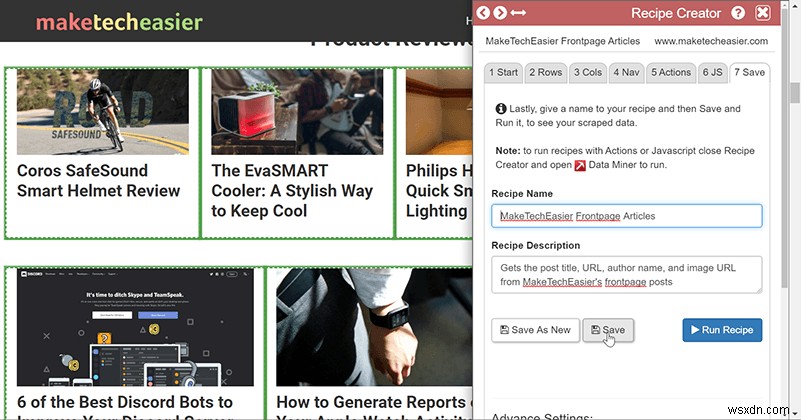
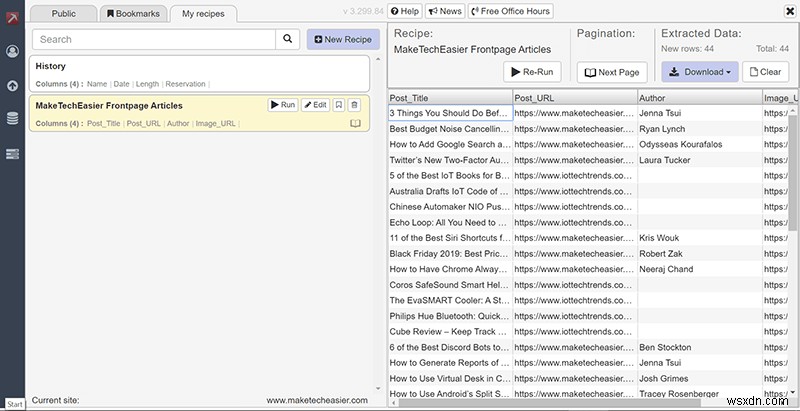
お疲れさまでした!いよいよ成果を確認する時間です。表示中のページでレシピを実行し、プレビューを見て行と列が意図どおりに機能しているかチェックしましょう。問題があれば、いつでも戻って編集できます。
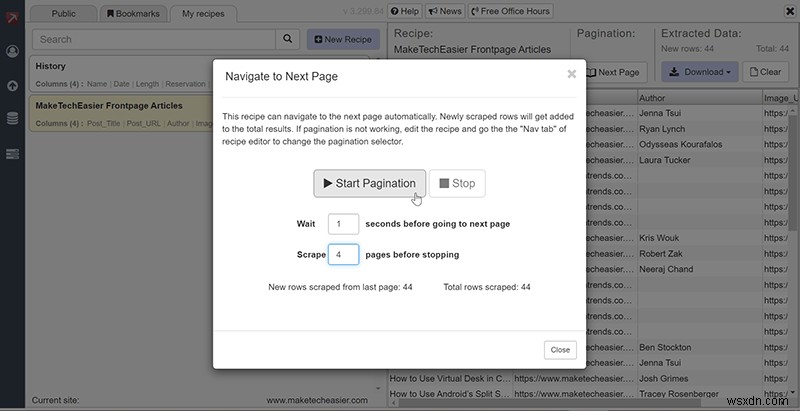
すべて順調なら、「Next Page」ボタンからクロールするページ数と実行速度を指定します(速度が速すぎるとbot判定を受ける可能性があるので注意)。
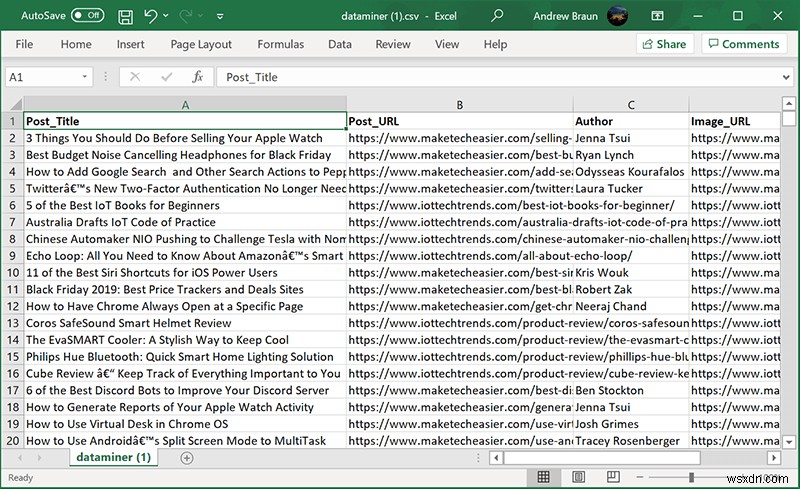
必要なデータをすべて収集したら、希望するファイル形式を選んでダウンロードしましょう。
うまくいかないときは?もっと簡単な方法はない?
Data Minerがしっくりこない場合でも、選択肢は豊富にあります。ParseHub、Scraper、Octoparse、Import.io、VisualScraperなど、他にも多くのスクレイピングツールが存在します。より直感的なインターフェースや高い自動化機能を持つものもありますが、いずれもHTMLの基礎とWebページの構造に関する最低限の知識は必要です。Data Minerが初心者にとって特におすすめなのは、クラウドソーシングによる充実したレシピライブラリです。これを活用すれば、コードに一切触れることなく目的を達成できる可能性があります。さらに、比較的寛大な無料月間スクレイピング枠と相まって、多くのニーズを満たせる優秀なツールといえるでしょう。
-
PDFからExcelへデータを抽出する4つの効果的な方法
日々の業務において、PDFファイルからデータを抽出してExcelのスプレッドシートに転記する作業は非常によくあるタスクです。手作業で行うと、時間がかかり、骨の折れる仕事になってしまいます。しかし、PDFからExcelへデータを抽出するテクニックをマスターしていれば、あっという間に作業を完了できます。この記事では、PDFからExcelへデータを抽出する4つの方法をご紹介します。これらの方法に興味がある方は、ぜひ最後までお読みください。 記事を読みながら練習できるように、サンプル用のワークブックとPDFファイルもご活用ください。 PDFからExcelへデータを抽出する4つの簡単な方法 各手法の
-
XMLファイルからExcelへデータを抽出する2つの簡単な方法
この記事では、XMLファイルからExcelへデータを抽出する方法をわかりやすく解説します。XML形式は主にWeb上でデータを保存・やり取りするために使われており、パソコン内にも保存できます。しかし、XMLファイルの中身をそのまま確認するのは容易ではありません。そこで本記事では、2つの異なる方法をご紹介します。どちらの方法でも、XMLファイルから簡単にデータを抽出し、Excelで見やすい形に整えられるようになります。 XMLファイルとは? XML(Extensible Markup Language:拡張マークアップ言語)は、さまざまなアプリケーションやシステム間で読み取り可能な形式でデータを