
C++で実装するN分木(N-ary Tree)のレベル順走査アルゴリズム
N分木(N-ary Tree)が与えられたとき、そのノードの値をレベル順走査(Level Order Traversal)、つまり上の階層から順に同じ深さごとにまとめて取得することを考えます。N分木の入力データはレベル順走査の形式でシリアライズされており、各子ノードのグループは null 値で区切られて表現されます。例えば、下図のようなツリーは [1,null,3,2,4,null,5,6] と表されます。
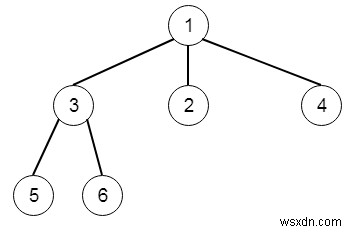
この場合、期待される出力は [[1],[3,2,4],[5,6]] となり、第1レベルにはルートの「1」、第2レベルには「3, 2, 4」、第3レベルには「5, 6」が含まれます。
解法のアプローチ:幅優先探索(BFS)
レベル順走査は、キュー(queue)を利用した幅優先探索(BFS)によって効率的に実現できます。具体的な手順は以下の通りです。
- 結果を格納するための二次元配列
ansを用意します。 - ルートが
nullの場合は、空のansを返します。 - キュー
qを作成し、ルートを挿入します。 - キューが空になるまで、以下の処理を繰り返します。
sizeに現在のキューのサイズを記録します(=現在のレベルのノード数)。- そのレベルの値をまとめる一時配列
tempを作成します。 size回だけ以下を繰り返します。currにキューの先頭要素を取り出します。currの値をtempに追加します。- キューからその要素を削除します。
currのすべての子ノードをキューに挿入します。
- 1レベル分の処理が完了したら、
tempをansに追加します。
- 最後に
ansを返します。
ポイントは、各ループの開始時にキューのサイズを固定しておくことです。これにより、「現在処理中のレベル」に属するノードだけを正確に処理でき、次のレベルの子ノードと混在することを防げます。
C++での実装例
それでは、実際のコードを見てみましょう。
#include <bits/stdc++.h>
using namespace std;
void print_vector(vector<vector<auto> > v){
    cout << "[";
    for(int i = 0; i<v.size(); i++){
        cout << "[";
        for(int j = 0; j <v[i].size(); j++){
            cout << v[i][j] << ", ";
        }
        cout << "],";
    }
    cout << "]"<<endl;
}
class Node {
    public:
    int val;
    vector<Node*> children;
    Node() {}
    Node(int _val) {
        val = _val;
    }
    Node(int _val, vector<Node*> _children) {
        val = _val;
        children = _children;
    }
};
class Solution {
    public:
    vector<vector<int>> levelOrder(Node* root) {
        vector < vector <int> > ans;
        if(!root)return ans;
        queue <Node*> q;
        q.push(root);
        while(!q.empty()){
            int sz = q.size();
            vector<int> temp;
            while(sz--){
                Node* curr = q.front();
                temp.push_back(curr->val);
                q.pop();
                for(int i = 0; i < curr->children.size(); i++){
                    q.push(curr->children[i]);
                }
            }
            ans.push_back(temp);
        }
        return ans;
    }
};
main(){
    Node *root = new Node(1);
    Node *left_ch = new Node(3), *mid_ch = new Node(2), *right_ch = new Node(4);
    left_ch->children.push_back(new Node(5));
    left_ch->children.push_back(new Node(6));
    root->children.push_back(left_ch);
    root->children.push_back(mid_ch);
    root->children.push_back(right_ch);
    Solution ob;
    print_vector(ob.levelOrder(root));
}
入力
[1,null,3,2,4,null,5,6]
出力
[[1],[3, 2, 4],[5, 6]]
計算量について
このアルゴリズムでは、すべてのノードをちょうど1回ずつ訪問するため、時間計算量はノード数を N とすると O(N) です。また、キューには最大で最も幅の広いレベルのノード数分の要素が保持されるため、空間計算量も最悪ケースで O(N) となります。
二分木の場合と同様に、キューを使ったBFSの考え方はそのままN分木にも適用できるのがポイントです。子ノードの数が可変である点以外、アルゴリズムの構造自体は変わりません。
-
【データ構造】二分探索木のレベル順走査(Level-Order Traversal)をC++で実装して理解しよう
本記事では、二分探索木(Binary Search Tree)におけるレベル順走査(Level-Order Traversal)の手法について詳しく解説します。レベル順走査は、木の根(ルート)から出発し、上の階層から下の階層へ、同じ深さのノードは左から右の順に訪問していく方法です。この走査は幅優先探索(BFS:Breadth-First Search)とも呼ばれ、木やグラフの探索において非常に重要な基本概念となっています。 例として、次のような二分探索木を考えてみましょう。 この木に対してレベル順走査を実行すると、ノードは次の順序で訪問されます。 10 → 5 → 16 → 8 → 15
-
Pythonで実装する二分木のジグザグレベル順走査(Zigzag Level Order Traversal)
二分木が与えられたとき、そのジグザグレベル順走査(Zigzag Level Order Traversal)の結果を求める問題を考えます。これは、第1レベルは左から右へ、第2レベルは右から左へ、第3レベルは再び左から右へ……というように、階層ごとに走査の向きを交互に切り替えながらノードを訪問する手法です。 例として、次のような二分木を扱います。 この木に対する走査結果は [[3], [20, 9], [15, 7]] になります。ルートの 3 を含む第1レベル、右から左へ読む第2レベル(20, 9)、そして左から右へ読む第3レベル(15, 7)という具合です。 アルゴリズムの流れ キュー