
C++で解く:二分探索木(BST)からターゲットに最も近いk個の値を効率的に取得する方法
問題概要
二分探索木(Binary Search Tree:BST)とターゲット値が与えられたとき、そのBSTの中からターゲットに最も近いk個の値を見つけることを考えます。ここで注意すべき点是として、ターゲット値は浮動小数点数であるという点が挙げられます。なお、kは常に有効な値であり、k ≤ 全ノード数が保証されているものとします。
例えば、次のようなBSTが入力として与えられた場合を考えます。
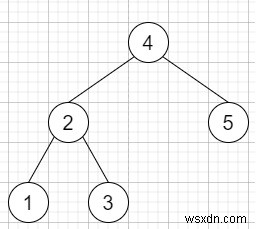
このとき、target = 3.714286、k = 2 とすると、出力は [4, 3] となります。
解法のアプローチ
この問題は、ターゲットより小さい値の候補と大きい値の候補をそれぞれ管理する2つのスタックを使うことで、中順走査(in-order traversal)のように効率的に解くことができます。手順は以下の通りです。
pushSmaller() 関数を定義する:引数としてノード、スタック st、ターゲットを受け取ります。
ノードが存在する間、以下を繰り返します。
ノードの値がターゲット未満の場合:
ノードをスタック st にプッシュする
node := ノードの右の子
それ以外の場合:
node := ノードの左の子
pushLarger() 関数を定義する:こちらもノード、スタック st、ターゲットを受け取ります。
ノードが存在する間、以下を繰り返します。
ノードの値がターゲット以上の場合:
ノードをスタック st にプッシュする
node := ノードの左の子
それ以外の場合:
node := ノードの右の子
メインメソッドでは以下を実行します。
結果格納用の配列 ret を定義する
スタック smaller と larger をそれぞれ定義する
pushLarger(root, larger, target) と pushSmaller(root, smaller, target) を呼び出して初期化する
k が 0 になるまで(1ステップごとに k をデクリメントしながら)以下を繰り返します。
smaller が空でなく、かつ(larger が空、または |target − smaller のトップの値| < |target − larger のトップの値|)を満たす場合:
curr := smaller のトップ要素を取り出してポップする
curr の値を ret の末尾に追加する
pushSmaller(curr の左の子, smaller, target) を呼び出して次の候補を補充する
それ以外の場合:
curr := larger のトップ要素を取り出してポップする
curr の値を ret の末尾に追加する
pushLarger(curr の右の子, larger, target) を呼び出して次の候補を補充する
ret を返す
この方法により、smaller のスタックトップは常に「ターゲット未満の最大値」を、larger のスタックトップは常に「ターゲット以上の最小値」を指すことになります。両者とターゲットとの距離を比較しながら近い方から順に答えを採用していくイメージです。
C++実装例
理解を深めるために、以下の実装例をご覧ください。
#include <bits/stdc++.h>
using namespace std;
void print_vector(vector<auto> v){
    cout << "[";
    for(int i = 0; i<v.size(); i++){
        cout << v[i] << ", ";
    }
    cout << "]"<<endl;
}
class TreeNode{
    public:
        int val;
        TreeNode *left, *right;
        TreeNode(int data){
            val = data;
            left = NULL;
            right = NULL;
        }
};
void insert(TreeNode **root, int val){
    queue<TreeNode*> q;
    q.push(*root);
    while(q.size()){
        TreeNode *temp = q.front();
        q.pop();
        if(!temp->left){
            if(val != NULL)
                temp->left = new TreeNode(val);
            else
                temp->left = new TreeNode(0);
            return;
        }
        else{
            q.push(temp->left);
        }
        if(!temp->right){
            if(val != NULL)
                temp->right = new TreeNode(val);
            else
                temp->right = new TreeNode(0);
            return;
        }
        else{
            q.push(temp->right);
        }
    }
}
TreeNode *make_tree(vector<int> v){
    TreeNode *root = new TreeNode(v[0]);
    for(int i = 1; i<v.size(); i++){
        insert(&root, v[i]);
    }
    return root;
}
class Solution {
public:
    vector<int> closestKValues(TreeNode* root, double target, int k) {
        vector<int> ret;
        stack<TreeNode*> smaller;
        stack<TreeNode*> larger;
        pushLarger(root, larger, target);
        pushSmaller(root, smaller, target);
        while (k--) {
            if (!smaller.empty() && (larger.empty() || (abs(target - smaller.top()->val) < abs(target - larger.top()->val)))) {
                TreeNode* curr = smaller.top();
                smaller.pop();
                ret.push_back(curr->val);
                pushSmaller(curr->left, smaller, target);
            }
            else {
                TreeNode* curr = larger.top();
                larger.pop();
                ret.push_back(curr->val);
                pushLarger(curr->right, larger, target);
            }
        }
        return ret;
    }
    void pushSmaller(TreeNode* node, stack <TreeNode*>& st, double target){
        while (node) {
            if (node->val < target) {
                st.push(node);
                node = node->right;
            }
            else {
                node = node->left;
            }
        }
    }
    void pushLarger(TreeNode* node, stack <TreeNode*>& st, double target){
        while (node) {
            if (node->val >= target) {
                st.push(node);
                node = node->left;
            }
            else
                node = node->right;
        }
    }
};
main(){
    Solution ob;
    vector<int> v = {4,2,5,1,3};
    TreeNode *root = make_tree(v);
    print_vector(ob.closestKValues(root, 3.7142, 2));
}
入力
{4,2,5,1,3}, 3.7142, 2出力
[4, 3]
計算量について
初期化の際に各スタックへは木の高さ分のノードしか積まれないため、時間計算量は O(h + k)(h は木の高さ)、空間計算量は O(h) となります。全ノードを走査してソートする O(n log n) のアプローチと比べ、k が小さい場合には非常に効率的です。
-
C++の二分探索木(BST)で最小値のノードを見つける方法
二分探索木(Binary Search Tree、BST)が与えられたとき、その木の中から最小の要素を見つけることを考えます。例えば、以下のようなBSTがあるとします。この場合、最小要素は 1 になります。考え方二分探索木の重要な性質として、左部分木には必ず親ノードより小さい値が格納されるというものがあります。この性質を利用すると、次の手順で最小要素を見つけることができます。ルートノードから探索を開始します。現在のノードの左の子が NULL でない間、左の子へ移動を繰り返します。左の子が NULL になったノードの値が、木全体の中で最小の要素です。この操作の計算量は木の高さに依存し、平衡な二分
-
C++プログラムにおける二分探索(バイナリサーチ)の基本と実装
二分探索(バイナリサーチ)とは二分探索は「半区間探索」「対数探索」「バイナリチョップ」とも呼ばれる検索アルゴリズムで、ソート済みの配列の中から目的の値が存在する位置を効率的に見つけ出します。基本的な仕組みは非常にシンプルです。まず、探したい値(ターゲット値)を配列の中央の要素と比較します。一致しなかった場合は、ターゲット値が存在し得ない半分を丸ごと排除し、残りの半分に対して同様の比較を繰り返します。この「中央との比較」と「範囲の絞り込み」を続け、ターゲット値が見つかるか、検索範囲が空になる(=配列にその値が存在しない)かのどちらかで処理が終了します。アイデア自体は簡単ですが、正しく実装するには