
Upstash Redisを活用したリアルタイムコード共同編集プラットフォームの構築
はじめに
Codeshareのようなプラットフォームがどのように構築されているのか、疑問に思ったことはありませんか?また、優れた開発者体験を維持しながら、そのようなサービスのスケーリングという課題に挑戦してみようと思ったことはありますか?
私がBytecrowdsの開発を決めたとき、これらすべてを学ぶ必要がありました。徹底的な調査を行った結果、テキスト共有機能にはYjsを使用することに決めました。次はデータベースを選ぶ番です。市場には数多くの選択肢がありますが、私は一つの重要なキーワード、シンプルさで候補を絞り込みました。
なぜUpstashなのか?
Upstashを知る前から、私はRedis®のシンプルなAPIに魅力を感じていました。しかし、それをプライマリデータベースとして使うには、スケーリング(キャッシュ用途でも必要になるかもしれません)や永続性の維持といった課題があります。さらに、スポンサーシップを獲得する前のオープンソースソフトウェアでは、予算管理に細心の注意が必要です。使用されていない時間帯にもコンピューティングリソースにお金を払う覚悟はありますか?突然のトラフィックスパイクに対応し、新機能の開発や改善、バグ修正ではなくインフラ作業に何時間も費やせますか?少なくとも私には無理でした。そこで出会ったのがUpstashです。
Upstash Redisは私の重要な基準のうち3つを満たしています。使いやすいこと、スケールしやすいこと、そして柔軟性があることです。さらに、低レイテンシー、サーバーレスクライアントで使えるREST SDK(Bytecrowdsにとっても必須要件でした)、グローバルレプリケーション、従量課金制などを組み合わせれば、なぜこのプロジェクトでUpstashを選んだのか理解していただけるでしょう。
アプリ全体でのRedis®の活用
Redis®をプロジェクトのメインデータベースとして使い、複数のサービスのニーズを満たす方法を見ていきましょう。全体像をつかむために、まずBytecrowdsのフロー図をご覧ください。
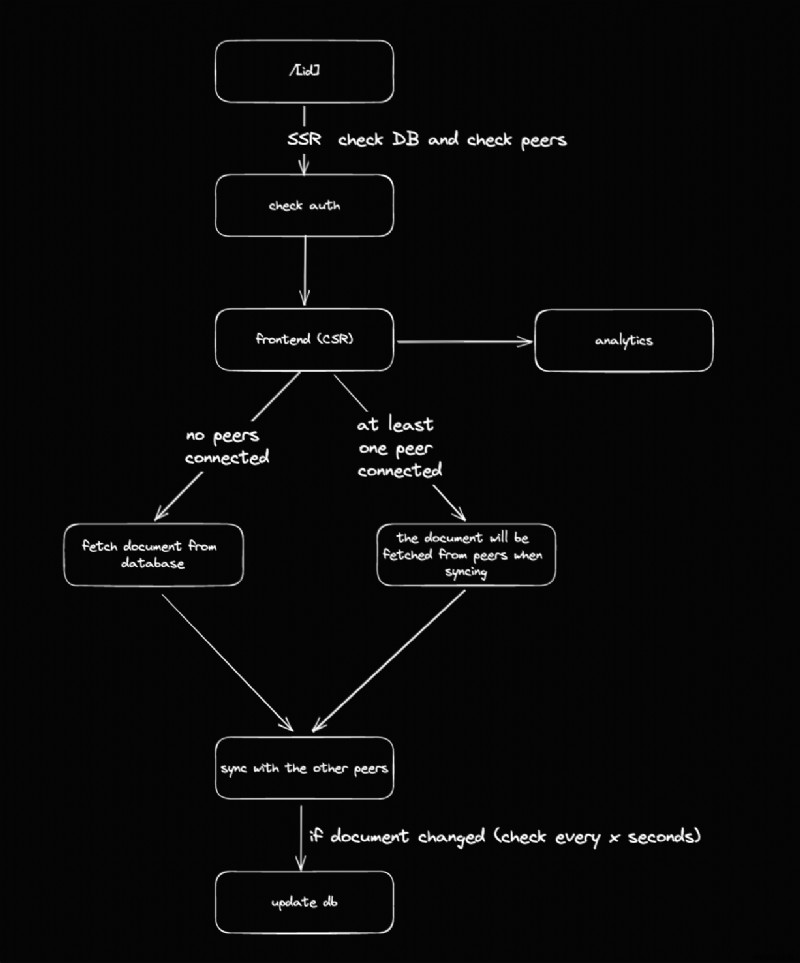
クライアント間のテキスト同期にはAblyを使用し、リクエストのIPアドレスに基づいてデータを収集するカスタム分析エンジンを採用しています。
メインストレージ
bytecrowdは、以下のプロパティを持つRedis®ハッシュとして保存されます。
{
 text: string,
 language: string,
 authorizedEmails: undefined || string array
}
プロパティの一つが変更されるたびにハッシュを更新しますが、更新間には「x」秒の遅延を設けています。本番環境では現在100ミリ秒に設定されています。
認証と認可
認証
BytecrowdsはNext.jsを使用しているため、GitHub OAuthの統合にはAuth.jsが最適な選択肢でした。幸い、セッション保存用のUpstashアダプターも活用でき、アプリ全体でRedis®を統一的に使うことができました。
認可
Bytecrowdsは、必要に応じてauthorizedEmailsフィールドを作成することで認可を処理します。このフィールドは一度設定されると、APIからは変更できません。Redis®で気に入っている点の一つは、定型的な操作のための関数が豊富に用意されており、しかも効率的になるようアルゴリズムが設計されていることです。例えば、authorizedEmailsがすでに設定されているかどうかの確認は、O(1)の計算量を持つHEXISTSコマンドを使うだけで完了します。
アナリティクス
Bytecrowdsのアナリティクスシステムは、次の2種類のデータを扱います。
- 1日分の統計情報。Redis®ハッシュとして保存され、
年 月 日形式の名前が付けられ、以下のプロパティを持ちます。
{
 countries: string array,
 hits: integer,
 pages: string array,
 uniqueVisitors: integer,
 addresses: string array,
 continents: string array
}ここでaddressesは、ウェブサイトのユニーク訪問者数を判定するために使われる、SHA256で暗号化されたIPアドレスの配列です。
continents、countries、pagesという3つのキー。データの保存にはRedis®のソート済みセット(sorted set)を使用しています。各統計値をそのカウント(ソート済みセットでは「スコア」)と一緒に保存することで、SORTやSORT_ROといったコマンドで簡単に照会・並べ替えが可能です。Redisのシンプルさがここでも発揮されます。
実装のコードが気になる方は、https://github.com/Bytecrowds/analytics/blob/main/src/index.js をご覧ください。
注:より複雑なユースケースでは、処理前に生データを保存したり、Apache Kafkaのようなストリーム処理ツールを導入したりするなどの変更を加えるとよいでしょう(Upstashはこれもサポートしています。詳細は公式ドキュメントをご確認ください)。
実際に試してみる
Bytecrowdsの動作を見てみたいですか?https://www.bytecrowds.com にアクセスし、「new bytecrowd」ボタンをクリックして、そのリンクを複数のタブで開いてみてください。コードを書き始めると、接続中のすべてのクライアントにコードがリアルタイムで同期される様子を確認できます。
おわりに
オープンソースプロジェクトの唯一のアクティブなメンテナーであることは大変だというのは周知の事実ですが、適切なツールとオートスケーリングインフラがあれば、トラフィックスパイクを気にせず素晴らしいプロジェクトの開発を続けられる大きな支えになります。もうUpstash Redis®を試してみたくなりましたか?クレジットカード不要の無料アカウントに今すぐ登録できます。
完全なコードについては、GitHubリポジトリをご確認ください。本記事に関するご質問やフィードバックは、tudor.zgimbau@gmail.comまでお気軽にお寄せください。
-
RedisConf 2021総まとめ:部門別に選ばれた注目セッション10選
毎年開催されるRedisコミュニティの祭典「RedisConf」。今年のテーマは「リアルタイムデータの力の再発見」でした。122か国から12,000人を超える開発者、アーキテクト、ビジネス・テクノロジーのリーダーたちが参加登録し、基調講演、座談会、60以上のブレイクアウトセッションがライブ配信されました。なお、2021年5月20日以降、RedisConf 2021の全セッションはYouTubeチャンネルで視聴可能です。 ユニークなユースケースを扱う多数のセッションの中から、投票によって10部門のトップセッションが選出されました。ここでは、各部門の受賞セッションをご紹介します。 最もエンター
-
RedisとApache Kafkaで実現する時系列データ処理:デバイス監視パイプラインの構築ガイド
RedisTimeSeriesは、Redisにネイティブな時系列データ構造をもたらすRedisモジュールです。従来Sorted SetsやRedis Streamsの上に構築されていた時系列ソリューションは、RedisTimeSeriesが提供する大量データの高速挿入、低レイテンシ読み取り、柔軟なクエリ言語、ダウンサンプリングなどの機能によって、大きくメリットを得られます。 一般的に時系列データ自体は(比較的)シンプルです。しかし、実際の運用では以下のような特性も考慮する必要があります。 データ速度:例えば、数千台のデバイスから毎秒数百のメトリクスが送られてくるようなケースデータ量(ビッグ