
Vercel Edge FunctionsとUpstash Redisで実現する、安全で低遅延なフィルタリングによるデータ漏洩防止
インターネット上では、データ漏洩が深刻な問題となっています。Statistaの調査によると、2022年だけで4億人以上がデータ漏洩の影響を受けました。自分のデータがネット上に流出することを望む人は誰もいません。そのため、ユーザーのプライバシーを尊重するセキュアなアプリケーションの構築は、多くの業界において極めて重要な課題です。
データ漏洩に対抗する有効な手段の一つが、問題のあるデータを他のサービスやユーザーへ配信する前にフィルタリングすることです。この手法には、データの見逃しを防ぐための常に最新のフィルターと、フィルタリングによるパフォーマンスへの影響を最小限に抑えるための低遅延インフラという、2つの要件があります。
Upstash for Redis®とVercel Edge Functionsは、この両方の要件を満たしながら問題を解決できる強力な組み合わせです。どちらも低遅延のサーバーレスソリューションであり、ユーザーの近くにデプロイできます。さらに、Vercelの新機能「cron」を活用すれば、フィルターデータを定期的に自動更新することも可能です。
このようなフィルターが実際にどのように動作するのかを示すため、サーバーレスエッジ技術を活用して不適切な表現をフィルタリングするフロントエンドとバックエンドを構築していきます。
アプリの機能
このアプリでは、Vercelのcron機能を使用して、リモートAPIから取得した最新の単語リストでUpstash for Redisデータベースを更新します。
データを取得する方法は以下の3つを用意します。
- フィルタリング済みテキストを含むWebページを返す
- データストアから取得したフィルタリング済みテキストをJSON形式で返す
- 送信されたテキストを受け取り、フィルタリング済みテキストをJSON形式で返す
使用する技術
アプリはNext.jsで構築し、Vercelにデプロイします。これにより、エッジ関数を活用したシームレスなサーバーレス開発体験が得られます。
データストレージには、低遅延と高い使いやすさを理由にUpstash for Redis®を採用します。
両サービスとも無料枠が用意されており、必要に応じて従量課金プランに移行できます。
前提条件
まず、以下のサービスのアカウントを用意してください。
- GitHub — コードをアップロードし、Vercelがダウンロードしてデプロイできるようにするため
- Vercel — ホームページとエッジ関数をホストするため
- Upstash — フィルタリング対象の単語リストを保存するため
実装
それでは始めましょう。まず新しいGitHubリポジトリを作成します。「Add a README file」にチェックを入れて、リポジトリが空にならないようにしてください。リポジトリが空でなければ、GitHubでCodespaceを起動できます。CodespaceにはNode.jsとGitHubへのGit接続があらかじめ設定されているため、すぐに開発を開始できます。
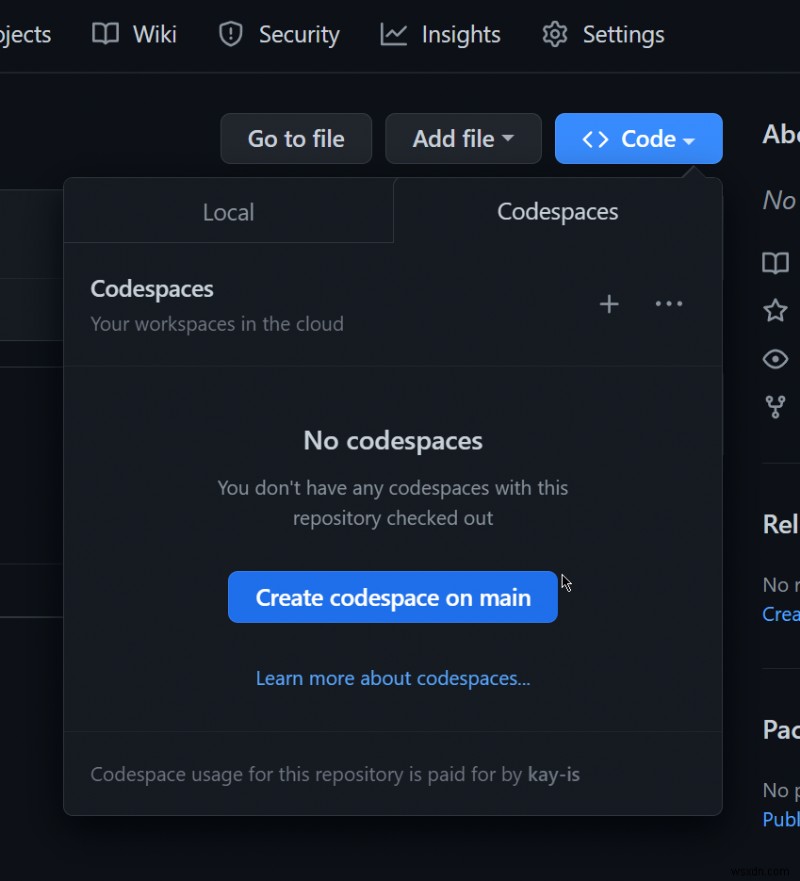 図1: Codespaceの起動
まず、以下のコマンドで新しいNext.jsプロジェクトを作成し、Upstash Redisクライアントをインストールします。
$ npx create-next-app@latest --typescript
$ npm i @upstash/redis
更新関数の実装
最初に実装するのは、不適切な単語リストを更新する関数です。次の内容で pages/api/refresh-list.ts というファイルを新規作成してください。
ファイル pages/api/refresh-list.ts:
import { Redis } from "@upstash/redis";

export const config = { runtime: "edge" };

const redisClient = new Redis({
 url: process.env.UPSTASH_REDIS_URL,
 token: process.env.UPSTASH_REDIS_TOKEN,
});

export default async function handler() {
 const wordResponse = await fetch(
 "https://raw.githubusercontent.com/kay-is/List-of-Dirty-Naughty-Obscene-and-Otherwise-Bad-Words/master/en",
 );
 const words = await wordResponse.text();

 const redisCommands = redisClient.pipeline();
 words
 .trim()
 .split("\n")
 .forEach((word) => redisCommands.sadd("words", word));
 await redisCommands.exec();
}
まず、この関数をエッジで実行するように設定します。この関数はバックグラウンドで動作するため必須ではありませんが、Vercel Edge FunctionsはCloudflare Workersを基盤としているため、Node.jsがネイティブにサポートしていないfetchメソッドを利用できるのが利点です。
ハンドラーは、不適切な単語を含むテキストファイルを読み込み、Upstash Redisに保存します。pipeline機能のおかげで、すべてのRedisコマンドをわずか1回のリクエストで送信できます。
単語の保存にはセット(set)型を使用するため、重複データが発生しません。また、後ほど1つのコマンドですべての単語を文字列の配列として取得することもできます。
なお、個人情報をフィルタリングしたい場合は、ユーザーのメールアドレス、電話番号、氏名、住所などをアカウントデータベースから取得し、フィルターの基礎データとして活用することも可能です。
Vercelにこの関数をcronジョブとして扱うよう指示するには、プロジェクトのルートに vercel.json ファイルを以下の内容で作成します。
ファイル vercel.json:
{
 "crons": [
 {
 "path": "/api/refresh-list",
 "schedule": "0 10 * * *"
 }
 ]
}
この設定により、Vercelは毎日UTC 10:00にrefresh-list関数を自動実行します。
無料のVercelアカウントでは、自動実行は1日1回までという制限があります。この例では十分ですが、より頻繁に変化するデータを扱う場合は、更新頻度を上げることを検討しましょう。
フィルターユーティリティの実装
次の機能は、テキスト内の単語がデータベース内の単語と一致した場合にマスク処理を行うユーティリティ関数です。utils/word-filter.ts というファイルを新規作成し、以下のコードを追加してください。
ファイル utils/word-filter.ts:
import { Redis } from "@upstash/redis";

const redisClient = new Redis({
 url: process.env.UPSTASH_REDIS_URL,
 token: process.env.UPSTASH_REDIS_TOKEN,
});

export async function filter(text: string) {
 const filteredWords = await redisClient.smembers("words");

 let maskedText = text;
 for (let word of filteredWords)
 maskedText = maskedText.replaceAll(new RegExp(word, "gi"), "[REDACTED]");

 return maskedText;
}
ここでもUpstash Redisクライアントを使用しますが、今回は先ほど保存したデータを読み込んでいます。
単語は文字列の配列として取得できるため、単純にループ処理を行い、テキスト内のすべての不適切な単語を「[REDACTED]」に置き換える置換関数を呼び出すだけです。
この関数は、フィルタリング対象となる単語の種類を問いません。今回のケースでは「職場では不適切な表現」を扱っていますが、フィルタリング処理自体は事前に保存したデータのみに依存します。つまり、同じ仕組みでさまざまな種類のデータに対応できるのです。
ホームページの実装
フィルターの動作を確認するために、pages/index.ts の内容を以下のコードに置き換えましょう。
ファイル pages/index.ts:
import Head from "next/head";
import { filter } from "@/utils/word-filter";

export const config = { runtime: "experimental-edge" };

interface HomeProps {
 maskedText: string;
}

export default function Home(props: HomeProps) {
 return (
 <>
 <Head>
 <title>Text with Filtered Words</title>
 </Head>
 <div>
 <h1>Text with Filtered Words</h1>
 <p>{props.maskedText}</p>
 </div>
 </>
 );
}

export async function getServerSideProps(): Promise<{ props: HomeProps }> {
 const maskedText = await filter(
 "He slipped and fell on his butt. Well, that wasn't very sexy."
 );
 return { props: { maskedText } };
}
config設定により、サーバーサイドレンダリングを含むすべての処理がエッジ上で実行されます。なお、このVercelの機能は現在まだ実験的(experimental)な段階です。
注目すべきは getServerSideProps 関数です。ここでは、先ほど実装した filter 関数を静的テキストに対して適用しています。この関数はサーバー側でのみ呼び出されるため、フィルタリング前の生データがクライアントに送られることはありません。
実際のアプリケーションでは、このテキストは個人情報を含むデータベースから取得され、表示前にクリーンアップされるといったケースが想定されます。
最初のAPIルートの実装
最初のAPIルートはホームページと同様の仕組みですが、HTMLではなくJSONを返します。pages/api/filtered-data.ts というファイルを以下の内容で作成してください。
ファイル pages/api/filtered-data.ts:
import { filter } from "@/utils/word-filter";

export const config = { runtime: "edge" };

export default async function handler() {
 const maskedText = await filter(
 "He slipped and fell on his butt. Well, that wasn't very sexy.",
 );

 return new Response(JSON.stringify({ text: maskedText }), {
 status: 200,
 headers: { "content-type": "application/json" },
 });
}
こちらもランタイムはエッジで、getServerSideProps関数と同様に静的テキストを使用しています。
2つ目のAPIルートの実装
このルートは、リクエスト経由でテキストを受け取り、フィルタリング済みの結果を返します。pages/api/filter.ts というファイルを新規作成し、以下のコードを追加してください。
ファイル pages/api/filter.ts:
import type { NextApiRequest } from "next";

import { filter } from "@/utils/word-filter";

export const config = { runtime: "edge" };

export default async function handler(request: NextApiRequest) {
 const { text } = await new Response(request.body).json();
 const maskedText = await filter(text);
 return new Response(JSON.stringify({ text: maskedText }), {
 status: 200,
 headers: { "content-type": "application/json" },
 });
}
今回は、フィルタリング対象のテキストを取得するためにリクエストボディをパースする必要があります。VercelのEdge Functionsでは、body は ReadableStream として提供されるため、これを Response オブジェクトに変換すれば、ネイティブのJSONパーサーを使ってデータを抽出できます。
リクエストからデータを取得できれば、あとの処理はこれまでとまったく同じです。
コード変更のプッシュ
すべての実装が完了したら、以下のコマンドでコードをGitHubリポジトリにプッシュします。
$ git add -A
$ git commit -m "Init"
$ git push
これでコードがオンライン上に公開され、Vercelがダウンロードしてデプロイできる状態になりました。
デプロイ
次に、環境変数用の認証情報を取得するためにUpstash Redisデータベースを作成し、Vercelプロジェクトを設定します。
Redisデータベースの作成
Upstashコンソールで「Create database」ボタンをクリックすると、新しいRedisデータベースを作成できます。設定内容は図2の通りです。この例ではリージョン型データベースで十分ですが、世界中に分散したユーザーを持つ場合や低遅延を維持したい場合は、グローバルタイプを選択することもできます。
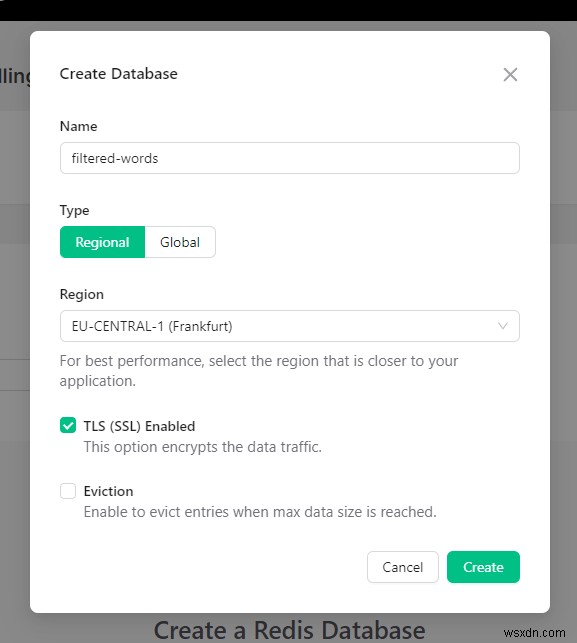
図2: 新しいデータベースの作成
作成後、「REST API」カテゴリの下に、環境変数として必要なURLとトークンが表示されます。図3のような画面です。
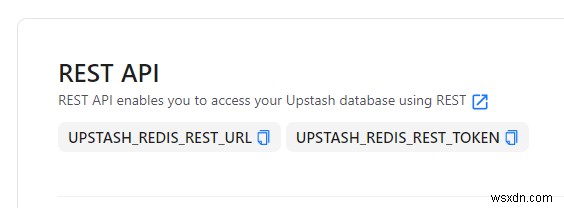
図3: データベースの認証情報
Vercelプロジェクトの作成
新しいVercelプロジェクトを作成するには、ブラウザでVercelダッシュボードを開き、中央にある「Create a New Project」をクリックします。VercelとGitHubアカウントを連携すると、インポートするリポジトリを選択できるようになります。
設定はデフォルトのまま進め、先ほど取得したUpstash Redisの認証情報を環境変数として追加します。参考までに、Vercelのプロジェクト作成画面を図4に示します。
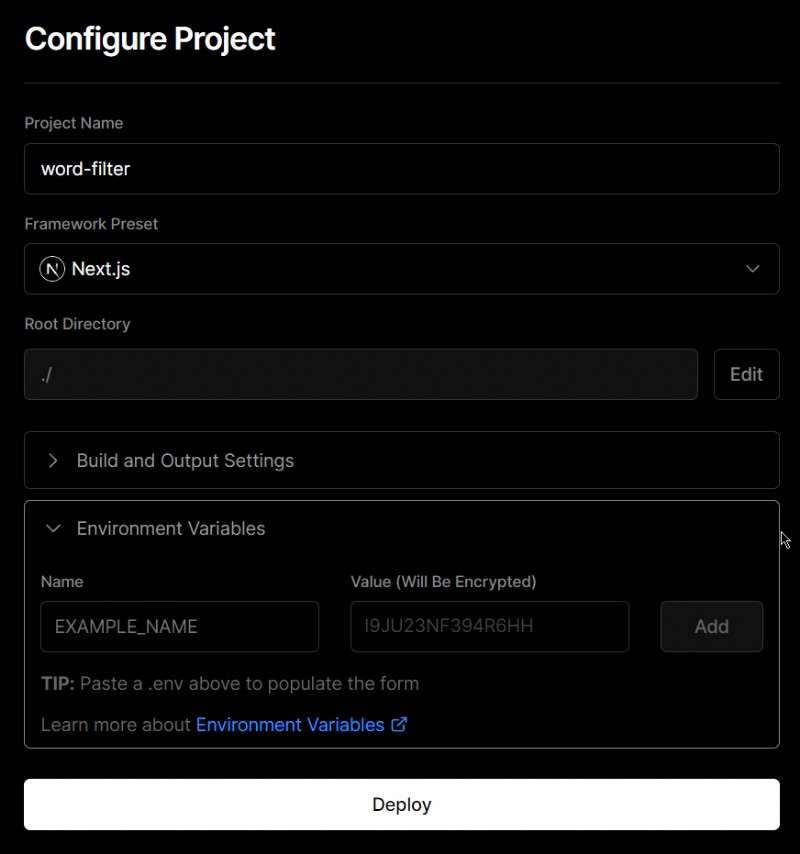
図4: Vercelプロジェクトの作成
環境変数の名前は UPSTASH_REDIS_URL と UPSTASH_REDIS_TOKEN です。前のステップで取得した値を使って登録してください。
「Deploy」をクリックすると、VercelがGitHubリポジトリからコードをダウンロードしてデプロイを開始します。
アプリのテスト
デプロイ直後は、cronジョブがまだ実行されていないため、アプリにはフィルタリング前の単語が表示されたままです。しかし、初回実行は手動で行えます。「Continue to Dashboard」ボタンをクリックし、「Cron Jobs」タブを選択してください。
ここに /api/refresh-list 関数が表示され、「Run」ボタンをクリックして実行できます。
関数の実行が完了したら、「Project」タブに移動し、「Domain」の下にあるいずれかのURLをクリックします。ブラウザでフィルタリング済みテキストを含むWebサイトが開き、図5のように表示されるはずです。
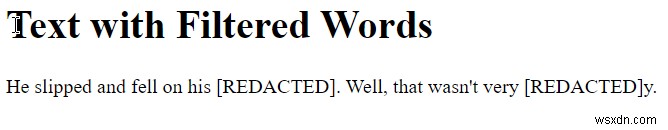 図5: フィルタリング済みのWebサイト
URLに /api/filtered-data を追加すると、APIレスポンスでも同様に機能することが確認できます。レスポンスは以下の例のようになります。
{
 "text": "He slipped and fell on his [REDACTED]. Well, that wasn't very [REDACTED]y."
}
最後に、cURLで /api/filter エンドポイントにリクエストを送ると、任意のテキストがフィルタリングされて返されます。<PROJECT> の部分はご自身のVercelプロジェクト名に置き換えてください。
$ curl -X POST https://<PROJECT>.vercel.app/api/filter \
 -H "Content-Type: application/json" \
 -d '{"text":"He fell on his butt."}'
レスポンスは以下の通りです。
{
 "text": "He fell on his [REDACTED]."
}
次のステップ
このチュートリアルを終えたところで、こんな疑問が浮かぶかもしれません。「データが更新されても、cronジョブが実行されるまでデータベースは更新されないのでは?」鋭い指摘です!
cronジョブが更新関数をトリガーしますが、これはあくまで通常のAPI関数でもあるため、好きなタイミングで自由に呼び出せます。
実際のデータフィルターでは、データの変更に応じてこの関数をトリガーしたくなるでしょう。ただし、その実装方法はフィルターの基盤となるデータストレージの種類に大きく依存します。構築の際には、この点を念頭に置いておきましょう。
関連リソース
完全なプロジェクトコードはGitHubで公開されています。
-
Redis分散ロック徹底解説:実証済みのパターンとよくある落とし穴の回避法
Redis 分散ロックとはマイクロサービスアーキテクチャが普及した現在、複数のサーバーやプロセスが同時に同一リソースへアクセスする場面は珍しくありません。このような状況でデータの整合性を維持するために不可欠なのが「分散ロック」です。Redisはインメモリデータストアとして高速な動作が特徴で、そのアトミックな操作を活かすことで、シンプルかつ効果的な分散ロックを実現できます。基本的な実装パターンRedisで分散ロックを実装する際の基本は SET key value NX EX seconds コマンドです。NXオプションによりキーが存在しない場合のみセットが成功し、EXオプションで有効期限を設定す
-
スケール入門書で学ぶキャッシングの概要――Redisによる大規模キャッシング
34年以上にわたりSaaSアプリケーションの設計・構築に携わってきたLee Atchison(リー・アッチソン)氏は、アプリケーションモダナイゼーション、クラウド移行、DevOps変革における第一人者として広く認められています。著書3冊、公開記事70本以上、そして数百回に及ぶ講演・講義・セミナーを通じて、その専門知識を披露しています。 あなたとチームが開発したアプリケーションが、ついに人々の注目を集めました。口コミで評判が広まり、人気は急上昇。しかしその一方で、運用コストは急騰し、アプリは頻繁にクラッシュ。ついには顧客が信じられない行動に出ます――あまりにも遅いレスポンス速度について、SNS