
UpstashとNode.jsで構築するリアルタイム記事レコメンデーションエンジンの作り方
GoogleやPerplexity.aiを使ったことはありませんか?最新の検索結果に、オンライン記事へのリンクが含まれている仕組みについて不思議に思ったことはないでしょうか。本ガイドでは、そのようなシステムを自分の手で構築する方法を学びます。追加した記事のリンクから「知識ベース」を育てていき、それをもとにレコメンデーションを生成できるシステムを作ります。
前提条件
このガイドを進めるには、以下が必要です。
- Node.js 18以降
- Upstashアカウント
- OpenAIアカウント
- Fly.ioアカウント
技術スタック
| 技術 | 説明 |
|---|---|
| Upstash | サーバーレスデータベースプラットフォーム。本ガイドではUpstash Vectorを使用して、ベクトル埋め込みとメタデータを保存します。 |
| Remix | Web標準に焦点を当てたフルスタックWebアプリケーションフレームワーク。 |
| OpenAI | 先進的なAI技術の開発に注力する人工知能研究ラボ。 |
| LangChain | 大規模言語モデル(LLM)を活用したアプリケーション開発のためのフレームワーク。 |
| Vercel AI SDK | AI搭載UIを構築するためのオープンソースライブラリ。 |
| TailwindCSS | カスタムデザインを構築するためのCSSフレームワーク。 |
| Fly.io | フルスタックアプリとデータベースをユーザーの近くで実行するプラットフォーム。 |
| Prettier | 一貫したコードスタイルを実現するためのコードフォーマッター。 |
全体の流れ
このガイドを完了して独自の記事レコメンデーションシステムをデプロイするには、以下の手順に従います。
- OpenAIトークンの生成
- Upstash Vectorインデックスの作成
- プロジェクトのセットアップ
- OpenAI APIクライアントのインスタンス化
- OpenAI API Embeddingsクライアントの作成
- Upstash Vectorクライアントの作成
- コンテキストAPIエンドポイントの作成
- チャットAPIエンドポイントの作成
- Fly.ioへのデプロイ
- まとめ
OpenAIトークンを生成する
OpenAI APIを使うことで、記事のベクトル埋め込みを取得したり、AIによるチャットボットの応答を生成したりできます。OpenAI APIへのすべてのリクエストには認証トークンが必要です。トークンを取得するには、OpenAIアカウントの「API Keys」ページに移動し、「Create new secret key」ボタンをクリックします。生成されたトークンをコピーし、後ほどOPENAI_API_KEY環境変数として使えるよう安全な場所に保管してください。
Upstash Vectorインデックスを作成する
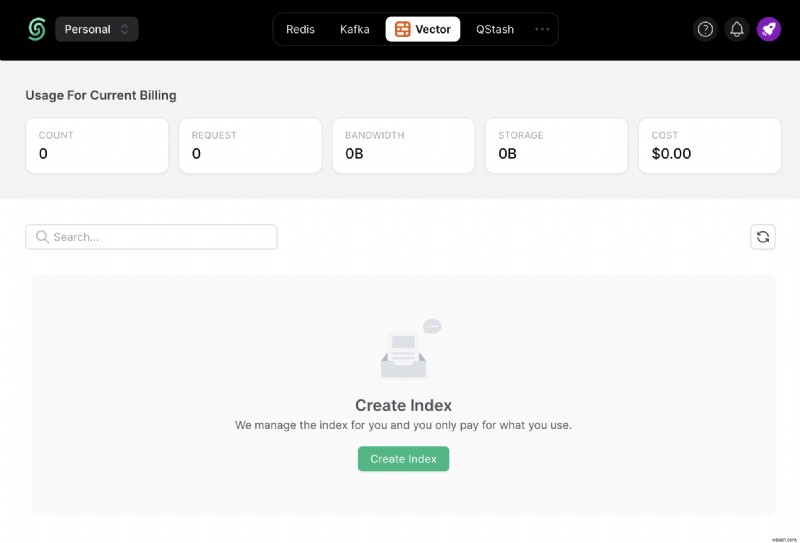
Upstashアカウントを作成してログインしたら、「Vector」タブに移動し、「Create Index」をクリックしてベクトルインデックスの作成を開始します。
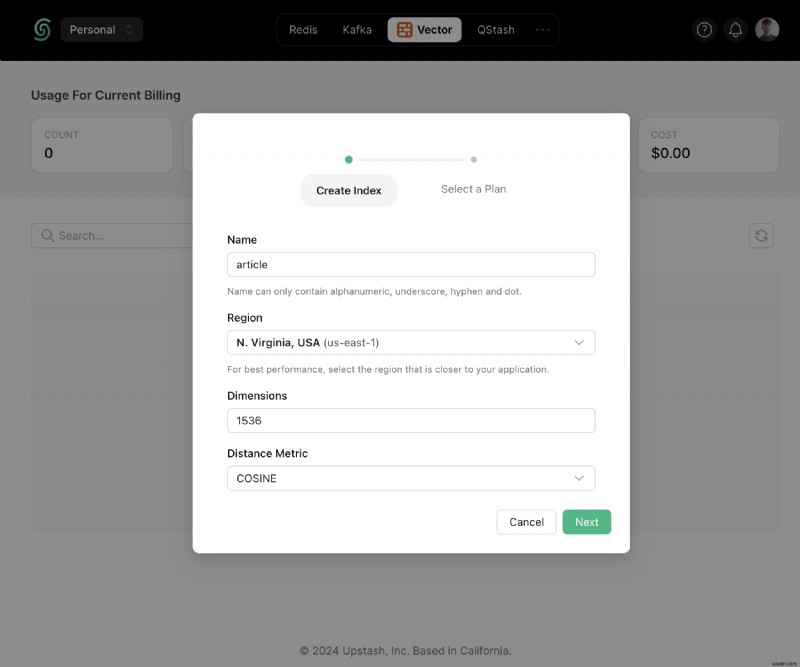
任意のインデックス名(ここではarticle)を入力し、ベクトルの次元数を1536に設定します。1536という数値は、OpenAIのtext-embedding-3-smallモデルが出力する埋め込みの次元数に対応しています。
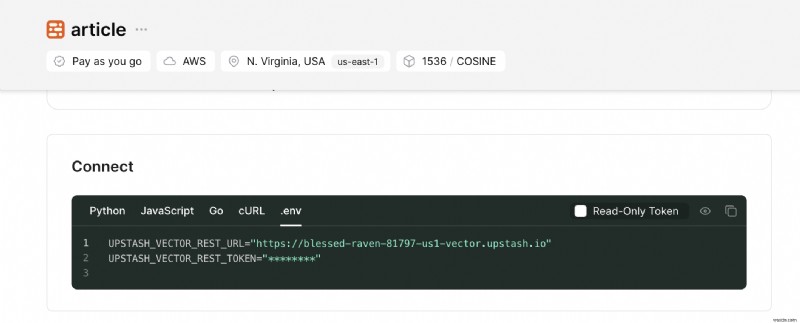
次に、ページを下にスクロールして「Connect」セクションを見つけ、「.env」ボタンをクリックします。表示された内容をコピーし、アプリケーション内で後ほど使用できるよう安全な場所に保存しておきましょう。
プロジェクトをセットアップする
セットアップは簡単です。アプリのリポジトリをクローンし、このガイドに沿ってコードの中身を理解していきましょう。ターミナルで以下のコマンドを実行してプロジェクトをクローンします。
# プロジェクトをクローン
git clone https://github.com/rishi-raj-jain/article-recommendation-system
cd article-recommendation-system

# 依存関係をインストール
pnpm installリポジトリをクローンしたら、.envファイルを作成します。このファイルには、前述のセクションで取得したシークレットキーを記載します。
.envファイルには以下のキーを含めてください。
# .env

# OpenAI API キー
OPENAI_API_KEY="sk-..."

# Upstash Vector キー
UPSTASH_VECTOR_REST_URL="https://...-us1-vector.upstash.io"
UPSTASH_VECTOR_REST_TOKEN="...="
これで設定は完了です。ターミナルで以下のコマンドを実行し、localhost:3000にアクセスすると、アプリケーションの動作を確認できます。
pnpm run build && pnpm run start続いて、独自の記事レコメンデーションシステムの構築を可能にする、コードの重要な部分を詳しく見ていきましょう。
OpenAI APIクライアントをインスタンス化する
openaiパッケージを使えば、わずか数行のコードでOpenAI REST APIとやり取りできます。以下のコードでは、チャット補完(chat completion)レスポンスの生成に使用するため、OpenAI APIクライアントライブラリをインスタンス化しています。
// ファイル: app/lib/openai/completion.server.ts

import OpenAI from 'openai'

// OpenAI APIを使ってテキスト補完を生成するクラスをインスタンス化
export default new OpenAI({
 apiKey: process.env.OPENAI_API_KEY,
})
ポイント: Remixではファイル名に.server.tsを付けることで、そのコードがクライアントサイドのバンドルから確実に除外されます。APIキーなどの機密情報を含むファイルには必ず付けましょう。
OpenAI API Embeddingsクライアントを作成する
@langchain/openaiパッケージのOpenAIEmbeddingsクラスを使うと、指定したテキストのベクトル埋め込みを生成できます。LangChainのVector Storeと組み合わせれば、各ベクトル埋め込みを自分で作成・挿入する手間が省けます。以下のコードでは、内部でベクトル埋め込みを生成するために、OpenAIEmbeddingsクラスをインスタンス化しています。
// ファイル: app/lib/openai/embedding.server.ts

import { OpenAIEmbeddings } from '@langchain/openai'

// OpenAI APIを使って埋め込みを生成するクラスをインスタンス化
export default new OpenAIEmbeddings({
 modelName: 'text-embedding-3-small',
 openAIApiKey: process.env.OPENAI_API_KEY,
})
Upstash Vectorクライアントを作成する
@upstash/vectorパッケージと@langchain/community/vectorstores/upstashパッケージを使えば、Remixアプリケーション内に接続不要のコネクションレス型クライアントを作成でき、Upstash Vectorインデックスへのベクトル埋め込みの保存・削除・クエリが可能になります。
// ファイル: app/lib/upstash/vectorStore.server.ts

import embeddings from '~/lib/openai/embedding.server'
import { Index as UpstashIndex } from '@upstash/vector'
import { UpstashVectorStore } from '@langchain/community/vectorstores/upstash'

// Upstash Vectorインデックスをインスタンス化
const index = new UpstashIndex({
 url: process.env.UPSTASH_VECTOR_REST_URL as string,
 token: process.env.UPSTASH_VECTOR_REST_TOKEN as string,
})

// 埋め込みの生成と保存を行うUpstash Vector Storeをインスタンス化
export default new UpstashVectorStore(embeddings, { index })
コンテキストAPIエンドポイントを作成する
Remixアプリケーションを起動すると、複数の記事URLを入力として受け付けるテキストボックスが表示されます。これらの記事は、今後のユーザー検索に対してパーソナライズされた応答を作り出すため、チャットボットの知識として追加されます。このセクションでは、コンテキストエンドポイント(app/routes/api_.context.tsx)がどのように複数の記事URLを受け付け、コンテンツを取得し、ベクトル埋め込みを生成して、Upstash Vectorインデックスに動的に保存するのかを学びます。
// ファイル: app/routes/api_.context.tsx

import { Document } from 'langchain/document'
import { ActionFunctionArgs } from '@remix-run/node'
import vectorServer from '~/lib/vector/vectorStore.server'
import { CheerioWebBaseLoader } from 'langchain/document_loaders/web/cheerio'

export const action = async ({ request }: ActionFunctionArgs) => {
 const formData = await request.formData()
 // フォーム送信に記事リンクが含まれているかチェック
 const articlesToEmbed = formData.get('articles') as string
 if (articlesToEmbed) {
 // Upstash Vector Storeに追加するドキュメントを作成
 const documents: any[] = []
 await Promise.all(
 articlesToEmbed.split(',').map(async (link) => {
 // 検索結果に表示するためにリンクを使用
 // Cheerioでリンクをパース
 const loader = new CheerioWebBaseLoader(link.trim())
 const scraper = await loader.scrape()
 // 検索結果に表示するtitleタグの内容を取得
 const name = scraper('title').html()
 // ページの本文を文字列として取得
 const pageContent = scraper.text()
 // ベクトルストアに挿入するメタデータオブジェクトを作成
 const metadata = { link, name }
 documents.push(new Document({ pageContent, metadata }))
 }),
 )
 // 提供されたドキュメントとメタデータから埋め込みを生成し、
 // Upstashデータベースに追加
 await vectorServer.addDocuments(documents.filter(Boolean))
 }
}
上記のRemix Actionでは、コンテキストエンドポイント(/api/context)へのPOSTリクエストに含まれるフォームデータがパースされます。その後、カンマ(,)で区切られた記事リンクのセットをループ処理し、以下の処理を行います。
- 記事のWebページから取得したテキストコンテンツを
pageContent変数として作成 - 記事ページのタイトルを
name変数として作成 - テキストコンテンツ・参照リンク・記事名を含むLangChainドキュメントを作成(
new Document({ pageContent, metadata })) - 各ドキュメントをグローバルな
documents配列に追加
最後に、グローバルなdocuments配列に格納されたすべてのドキュメントがUpstash Vectorインデックスに挿入されます。内部的には、各ドキュメントのpageContentプロパティをもとにベクトル埋め込みが生成されます。
チャットAPIエンドポイントを作成する
このセクションでは、チャットAPIエンドポイント(app/routes/api_.chat.tsx)が、ユーザーの検索に関連する記事のおすすめを含む「検索エンジンのような」応答を生成する仕組みを学びます。検索に関連する記事は、指定されたベクトルインデックスから上位K件(top-K)の最も近いベクトルを見つけることで特定されます。さらに、ベクトルのメタデータからタイトルとリンクを取り出し、OpenAI APIにコンテキストとして渡します。これにより、チャットボットはユーザーの検索に応答しながら、記事を外部リンクとして含めることができます。理解しやすいよう、以下のパートに分けて解説します。
類似性検索で関連するベクトル埋め込みを見つける
ユーザー検索のたびに記事の知識ベース全体を見直すのは、コストの高い操作です。そこで、ユーザーの検索に高い関連性を持つ(場合によっては)上位3件の記事に絞り込むため、Upstash Vectorインデックス内の既存のベクトルセットに対してクエリを実行します。さらにフィルタリングを行い、ユーザー検索のベクトル埋め込みとの類似度スコアが少なくとも70%以上あるベクトルだけを残します。
// ファイル: app/routes/api_.chat.tsx

import vectorServer from '~/lib/upstash/vectorStore.server'
import type { ActionFunctionArgs } from '@remix-run/node'

export const action = async ({ request }: ActionFunctionArgs) => {

 // ユーザーとチャットボットの間のメッセージ一覧
 const { messages = [] } = await request.json()

 // チャット配列の最後のメッセージから最新の質問を取得
 const searchQuery = messages[messages.length - 1].content

 // Upstash Vector Storeで類似性検索を実行
 const queryResult = await vectorServer.similaritySearchWithScore(searchQuery, 3)

 // 信頼度スコア70%超のレコードをフィルタリングし、
 // 検索結果として表示するメタデータを設定
 const results = queryResult.filter((i) => i[1] >= 0.7).map((i) => i[0].metadata)

 // 応答の作成へ続く
}
チャットボット用のシステムコンテキストと指示を作成する
関連性の高いベクトルのセットが得られたので、次はチャットボットがユーザーの検索に応答する前に、関連付けられた記事を把握し参照できるようにします。OpenAIのgpt-3.5-turboモデルでこれを実現するには、roleプロパティをsystemとしたメッセージオブジェクトを作成し、contentプロパティに以下の指示を含めます。
- チャットボットはGoogleのように振る舞うこと
- 応答は必ずMarkdown形式であること
- 応答には記事へのハイパーリンクを含めること
- 単なる参考文献の提示にとどまらず、質問に関連する一般的な説明文も加えること
// ファイル: app/routes/api_.train.tsx

import { OpenAIStream, StreamingTextResponse } from 'ai'
import completionServer from '~/lib/openai/completion.server'

export const action = async ({ request }: ActionFunctionArgs) => {
 // ...

 // 関連記事をコンテキストとしてOpenAIテキスト補完を使用
 const completionResponse = await completionServer.chat.completions.create({
 stream: true,
 model: 'gpt-3.5-turbo',
 messages: [
 {
 // システムコンテンツメッセージを作成。
 // OpenAIテキスト補完がAPI経由でコンテキストとして供給する
 role: 'system',
 content: `Behave like a Google. You have the knowledge of the following articles: ${JSON.stringify(results)}. Each response should be in 100% markdown compatible format and should have hyperlinks in it. Be precise. Do add some general text in the response related to the query.`,
 },
 // 会話履歴全体も渡す!
 ...messages,
 ],
 })

 // レスポンスを扱いやすいテキストストリームに変換
 const stream = OpenAIStream(completionResponse)
 // ストリームで応答を返す
 return new StreamingTextResponse(stream)
}
上記のコードにより、コンテキストを考慮した結果をOpenAIからストリーミング受信し、ユーザーの検索に関連すると判断された記事をおすすめとして返せるようになります。
盛りだくさんの内容でしたが、これで完成です✨
Fly.ioにデプロイする
リポジトリにはFly.io向けの設定があらかじめ組み込まれています。具体的には以下の通りです。
- Dockerfile
- fly.toml
- .dockerignore
Fly.ioアカウントを作成したら、ルートディレクトリでターミナルから以下のコマンドを実行して、Fly.io上にアプリを作成できます。
# 組み込みの設定をもとにアカウント内にアプリを作成
# 既存のfly.tomlで変更されるのはアプリ名のみ

fly launch
そして、ターミナルで以下のコマンドを実行してFly.ioにデプロイします。
# 上記で作成した設定にもとづいてアプリをデプロイ

fly deploy
参考資料
より詳細な情報については、本ガイドで参照した以下の資料をご覧ください。
- GitHubリポジトリ
- Upstash Vector StoreとLangChainの統合
- OpenAI Chat Completions APIにおけるシステム指示(System Instructions)
- LangChainのCheerioを使ったWebページからのデータ読み込み
- ReactアプリでのAIチャットUIの作成
まとめ
本ガイドでは、ベクトル埋め込みとOpenAI Completion API、そして動的に生成されるシステムコンテキストを活用して、記事レコメンデーションシステムを構築する方法を学びました。Upstash VectorとLangChainを組み合わせれば、ベクトルのインデックスへの保存、top-Kベクトル検索クエリの実行、ユーザー検索ごとの関連コンテキストの生成まで、ほんの数行のコードで実現できます。
ご質問やコメントがある場合は、GitHubでお気軽にご連絡ください。
-
Vercel Edge FunctionsとUpstash Redisで実現する、安全で低遅延なフィルタリングによるデータ漏洩防止
インターネット上では、データ漏洩が深刻な問題となっています。Statistaの調査によると、2022年だけで4億人以上がデータ漏洩の影響を受けました。自分のデータがネット上に流出することを望む人は誰もいません。そのため、ユーザーのプライバシーを尊重するセキュアなアプリケーションの構築は、多くの業界において極めて重要な課題です。 データ漏洩に対抗する有効な手段の一つが、問題のあるデータを他のサービスやユーザーへ配信する前にフィルタリングすることです。この手法には、データの見逃しを防ぐための常に最新のフィルターと、フィルタリングによるパフォーマンスへの影響を最小限に抑えるための低遅延インフラという
-
Redis GEOADDコマンド徹底解説 – 地理空間データに要素を作成・追加する方法
このチュートリアルでは、Redisのキーに保存された地理空間値(geospatial value)に要素を作成・追加する方法について解説します。ここではGEOADDコマンドを使用します。 GEOADDコマンドとは GEOADDコマンドは、キーに格納された地理空間値に対して、1つ以上の地理空間メンバーを追加するためのコマンドです。地理空間値とは、このコマンドによって生成されるソート済みセット(sorted set)のことであり、メンバーは後からGEORADIUSやGEORADIUSBYMEMBERコマンドによる半径検索で取得できる形式で格納されます。 ソート済みセットへの登録には「Geohash