
Upstash KafkaとMongoDBコネクタで実現する低レイテンシセグメンテーションプラットフォームの構築
はじめに
セグメンテーションプラットフォームは、顧客や製品といった関連データを理解し、分類するうえで重要な役割を担います。
セグメンテーションとは、一定の基準に基づいて大きなグループを、より均質性の高い小さなサブグループへ分割することです。たとえばECサイトにおける顧客セグメンテーションでは、パーソナライズされたマーケティング施策の立案、ターゲットを絞ったプロモーションの実施、きめ細かなショッピング体験の提供などが可能になります。
目次
- 要件の把握
- 基本アーキテクチャ
- アーキテクチャ構成要素
- 設計上の課題
- 提案ソリューション
- まとめ
1. 要件の把握
EC向けの顧客セグメントを対象とした低レイテンシのセグメンテーションプラットフォームを設計する際には、リアルタイム処理、ユーザー体験、そして顧客行動の変化の速さに関わる特有の課題に直面します。ここでは、想定される主な課題を整理します。
-
大規模かつ動的なデータセット
- ECプラットフォームでは、顧客プロファイル、商品カタログ、取引履歴など、絶えず変化する大規模なデータセットを扱います。
- こうした膨大なデータを、低レイテンシを維持しながらリアルタイムに管理・処理することは大きな挑戦となります。
-
スケーラビリティ
- 変動するワークロードに対応するには、スケーラビリティを考慮した設計が不可欠です。処理ユニットを追加して水平方向に拡張しつつ、レイテンシを犠牲にしないためには、綿密なアーキテクチャ設計が必要です。
-
非同期処理
- 非同期処理を活用すれば、コンポーネント間の結合度を下げ、システム全体の応答性を高められます。ただし、複雑化や遅延を招かずに非同期通信を管理するには、慎重な設計が求められます。
-
データフローとパイプライン
- 低レイテンシシステムにおいては、効率的なデータフローと処理パイプラインの設計が極めて重要です。
- コンポーネント間のデータ転送時間を最小限に抑え、処理ステップの順序を最適化することが、全体のレイテンシに大きく影響します。
-
マイクロサービスアーキテクチャ
- マイクロサービスアーキテクチャを採用すれば、スケーラビリティと柔軟性が向上します。しかし、レイテンシを増加させずにマイクロサービス間のシームレスな通信を実現するのは容易ではありません。
- 効率的なAPI設計とサービス間通信の管理が成功の鍵となります。
2. 基本アーキテクチャ
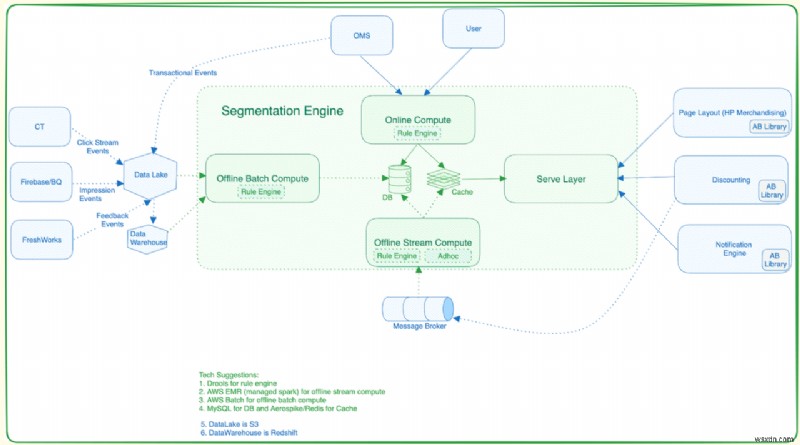
セグメンテーションプラットフォームは、次の3つの主要サブシステムで構成されます。
-
コンピュートサービス(オフラインバッチ計算/オンライン計算)
- Sparkジョブを使用して、生データからユーザーセグメントを抽出します。
- Sparkジョブはデータレイクからデータを取得し、クレンジングと検証を行います。
- 処理結果はサービングサブシステムへ送信されます。
-
インジェストサービス
- 計算済みのセグメントを、コンピュートサービスからセグメンテーションサービスへ転送します。
- セグメントへのユーザーの追加・除外を管理します。
-
セグメントサービス(サーブ層)
- ユーザーサービスや割引サービスからの要求に応じて、ユーザーセグメントを提供します。
- 割引サービスはユーザーIDをキーに照会し、適用可能な割引を算出できます。データイメージは以下の通りです。
ユーザーID セグメントID 作成日 2521 Segment X 2023年12月3日 2788 Segment Y 2023年12月3日 3943 Segment Z 2023年12月3日
3. アーキテクチャ構成要素
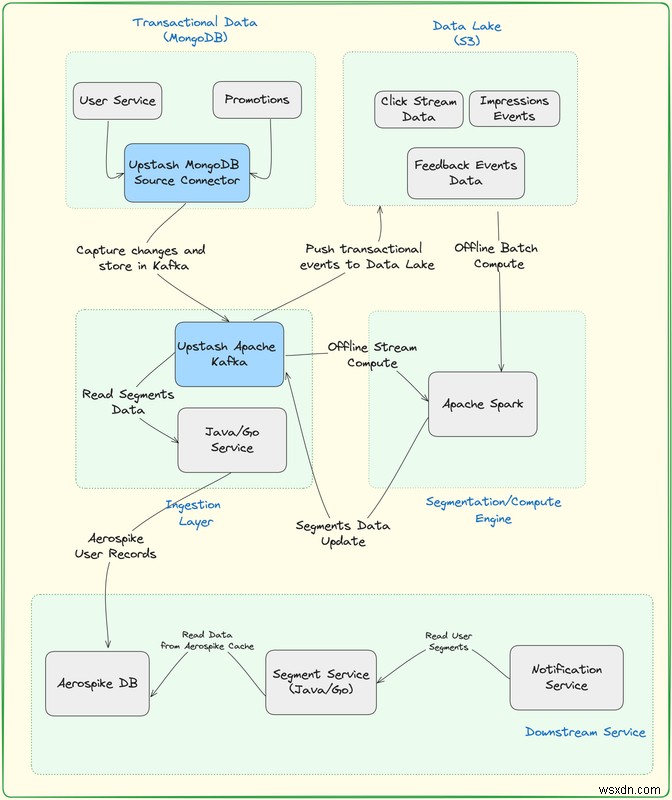
セグメンテーションプラットフォームは、以下の主要コンポーネントで構成されています。
-
データレイク:S3
- S3は、データレイクとして広く採用されている汎用性の高い選択肢です。スケーラブルで耐久性の高いオブジェクトストレージ機能により、多様なデータタイプを大量に効率的に保存・管理できます。
- S3をデータレイクとして利用することで、堅牢なデータ保存・取得・管理機能の恩恵を受けられます。そのため、データ中心のさまざまなアプリケーションやアーキテクチャで人気の選択肢となっています。
-
トランザクションデータベース:MongoDB
- MongoDBのドキュメント指向モデルはトランザクション用途に適しており、JSONに近い形式で複雑なデータ構造を格納できます。この柔軟性は、データ構造が時間とともに進化するアプリケーションにとって特に有用です。
-
Upstash Kafkaクラスタ
- Webアプリケーションからのトラフィック(クリック)イベントをUpstash Kafkaへストリーミングし、その後データレイクに保存してさらなる処理に活用できます。
- Upstash Kafkaは世界初のサーバーレスKafkaサービスです。リクエスト単位の従量課金モデルにより、数百ドルもの費用をかけずに完全マネージドのKafkaクラスタを利用できます。無料枠では、クレジットカード登録なしで数秒以内にKafkaクラスタを作成可能です。可用性、メンテナンス、スケーリング、アップグレードなどの面倒な作業はUpstashチームが担当するため、開発者はアプリケーション開発に集中できます。
-
Upstash MongoDBソースコネクタ
- MongoDBソースコネクタは、Apache Kafka Connectのようなデータ統合・ストリーミングプラットフォームで使用されるコンポーネントで、MongoDBデータベースに接続し、変更やイベントをリアルタイムにキャプチャします。
- Upstash MongoDBソースコネクタは、MongoDBから別のシステムやプラットフォームへのデータ移動を容易にし、シームレスなデータ統合と分析を可能にします。
-
Apache Spark
- Apache Sparkは、単一ノードまたはクラスタ上でデータエンジニアリング、データサイエンス、機械学習を実行できる多言語対応エンジンです。
- Upstashが標準提供しているUpstash KafkaとApache Sparkの統合により、Webアプリケーションからのトラフィック(クリック)イベントをUpstash Kafkaへストリーミングし、リアルタイムに分析できます。
- Apache Sparkはユーザーセグメントの更新処理を担当します。更新データはまずUpstash Kafkaに書き込まれ、その後伝播されてAerospikeデータベースが更新されます。
4. 設計上の課題
セグメンテーションエンジンの利用拡大に伴い、システムには以下のような課題が生じる可能性があります。
- 書き込みQPSのボトルネック: セグメントの数やサイズが増加すると、書き込みクエリ毎秒(QPS)にボトルネックが発生し、セグメント作成の待ち時間が長引く恐れがあります。
- 低レイテンシ要求: 特定のコミュニケーション配信、特にユーザーが特定セグメントに属しているかどうかの判定では、非常に低いレイテンシの実現が不可欠です。
-
読み取りレイテンシ
- プラットフォームの進化に伴い、読み取り時に50ms未満という必要なレイテンシを満たしていても、特定のサービスや将来のユースケースには不十分になる可能性が予想されます。
- たとえば通知サービスでは、コミュニケーションを配信する前にユーザーのセグメント所属を高速に判定する必要があります。各リクエストでレイテンシが増加することは、将来的に許容されないと予想されます。
-
Kafkaインフラの管理
- トランザクションソースから毎分数百万件のイベントを処理する場合、Kafkaインフラの運用は確かに困難であり、高いスループットを効果的に管理するには、さまざまな要素を慎重に検討する必要があります。
- 高スループットのKafkaインフラを維持するには、定期的なパフォーマンステストと最適化が鍵となります。
-
MongoDBのChange Data Capture(CDC)
- Webアプリケーションからのイベントを集約し、MongoDBのような従来型トランザクションデータベースに格納したうえでデータレイクへ送出するには、相応の手間がかかります。
- MongoDBが提供するCDC(change data capture)機構を利用するか、データベースの変更をキャプチャするカスタムソリューションを実装しましょう。
5. 提案ソリューション
-
分散キャッシュAerospikeによる読み取りレイテンシの改善
- Aerospikeにはユーザーのセグメント情報を格納し、ユーザーIDを主キーとしてユーザーセグメントにアクセスします。
- さらに、セグメントIDに対してセカンダリインデックスを実装すれば、セグメント所属ユーザーの取得が効率化され、セグメントユーザーを別途保存する必要がなくなります。
- また、この設計はレイテンシ要件を満たすことを目的としており、キャッシュとして機能させればRedisの代替にもなり得ます。
- 既存のAerospikeをUpstash Redisに置き換える場合は、セグメントユーザーとユーザーセグメントという2種類のデータを管理する必要が生じます。
-
サーバーレスUpstash KafkaによるKafkaインフラ管理
- Upstash Kafkaなら完全マネージドサービスを利用できます。つまり、Kafkaクラスタの稼働に必要なサーバープロビジョニング、スケーリング、メンテナンスといった技術的な作業はすべてUpstashが担います。
- インフラのセットアップ、正常な動作の確認、継続的な保守などを心配する必要はありません。
- そのため、インフラ管理の負担なしに、独自の要件や目標に合わせてKafkaを活用することに集中でき、急速に変化する開発環境においてアプリケーション全体の品質向上にエネルギーを注げます。
- 価格はゼロまでスケール: 真のサーバーレスは、利用していないときに課金されるべきではありません。リクエスト単位の課金は最大の特長です。固定費を最小限に抑えることが求められますが、Kafkaのような巨大なシステムではこれは非常に困難です。
- ユーザーに運用負担なし: ユーザーはKafkaトピックを作成してすぐ使い始められます。高可用性、スケーラビリティ、アップグレード、バックアップなどはすべてUpstashの責任範囲です。
- コネクションレス: サーバーレス関数は状態を保持しません。そのため、ステートレスな接続でデータにアクセスできる必要があります。UpstashのKafkaはKafka TCPプロトコルをサポートしているため、すべてのKafkaクライアントが利用可能です。さらに、AWS LambdaやCloudflare Workersのようなコネクションレス環境向けに、REST APIも組み込みで提供されています。
-
Upstash MongoDBソースコネクタによるMongoDB CDC
- Kafka Connectは、コードを一切書かずにApache Kafkaと他のシステム間でデータをストリーミングするツールです。Kafkaシンクコネクタを使えばデータを任意のストレージへ書き出せ、Kafkaソースコネクタを使えば他のシステムからKafkaトピックへデータを取り込めます。
- Kafkaコネクタはセルフホストも可能ですが、追加のプロセスやマシンのセットアップと保守が必要になります。UpstashはKafkaクラスタ向けのホステッド版コネクタを提供しており、追加システムの保守負担から解放されるだけでなく、クラスタの近くで動作するためパフォーマンスにも優れています。
6. まとめ
本記事では、Upstashが提供する技術を活用した低レイテンシセグメンテーションプラットフォームの設計原則について解説しました。このインフラはシームレスにスケールするよう設計されており、数百万規模のユーザーに対応し、データレイクに保存されたテラバイト級のデータを処理できます。
-
Replicate・Next.js・Upstashで作る写真復元アプリ開発チュートリアル
この記事では、機械学習モデルを活用した写真復元アプリの開発方法を解説します。進める前に、以下の環境が整っていることを前提とします。 Redisインスタンスを作成済みのUpstashアカウント APIトークンを取得済みのReplicateアカウント 機能を実装するためのNext.jsプロジェクト プロジェクトをデプロイするためのVercelアカウント このチュートリアルについて Replicateで提供されているモデルを使って、機械学習による画像生成を始めてみたいと思ったことはありませんか?本チュートリアルでは、Replicateがホストする多彩なモデルとUpstashのRedisを組み合わ
-
Redis ZCOUNT –スコア範囲でソートされたセットの要素数を取得する方法
このチュートリアルでは、RedisのZCOUNTコマンドを使用して、ソート済みセット(Sorted Set)に格納された要素のうち、特定のスコア範囲に該当する要素数を取得する方法を解説します。 ZCOUNTコマンドとは ZCOUNTコマンドは、引数として渡されたmin以上かつmax以下のスコアを持つ、ソート済みセットの要素数を返すコマンドです。 デフォルトではminとmaxは閉区間(境界値を含む)として扱われますが、値の先頭に「(」を付けることで、開区間(境界値を含まない)として指定することも可能です。例えば以下のようになります。 ZCOUNT zset (1 5 上記のコマンドは「1 <