
SQL環境を中断せずにRedisクエリを実行する2つの方法
RedisでSQLクエリを実行することは、決して難しいことではありません。実は数年前、小売企業でデータウェアハウスソリューションを管理している友人と話していた際に、まさにこの話題に触れたことがあります。彼が直面していた課題について聞いたことがきっかけで、Redisのクエリ機能について語り始めたのです。
友人はこう語っていました。
「私たちにはデータウェアハウスソリューションに関する悩みがあります。データを記録し、リアルタイムで分析処理を行う必要があるユースケースがあるのですが、結果が得られるまでに数分かかることがあるのです。Redisはここで役立つでしょうか?ただし、SQLベースのソリューションを一気に作り替えることはできません。少しずつ段階的に進めるしかないのです。」
もしあなたがこの友人と同じ状況にあるなら、朗報です。現在のSQLベースのソリューションを中断することなく、Redisクエリを実行し、アーキテクチャにRedisを導入する方法はいくつもあります。
それでは、具体的な方法を見ていきましょう。その前に、Redis Hackathonの出場者が、SQLでRedis内のデータをクエリできるアプリを自作した事例をご紹介します。以下の動画をご覧ください。
テーブルをRedisデータ構造として再構築する
テーブルをRedisデータ構造にマッピングするのは非常にシンプルです。特に有用なデータ構造は以下の3つです。
- Hash(ハッシュ)
- Sorted Set(ソート済みセット)
- Set(セット)
一つの方法としては、テーブルの各行をHashとして保存し、キーは主キーに基づいて生成します。そして、そのキーをSetまたはSorted Setに格納します。
図1は、テーブルをRedisデータ構造にマッピングする例を示したものです。この例では「Products」というテーブルがあり、各行はHashデータ構造にマッピングされます。
主キーIDが10001の行は、「product:10001」というキーを持つHashとして保存されます。この例では2つのSorted Setを使用しています。1つ目は主キーでデータセット全体を走査するためのもので、2つ目は価格に基づいてクエリを実行するためのものです。
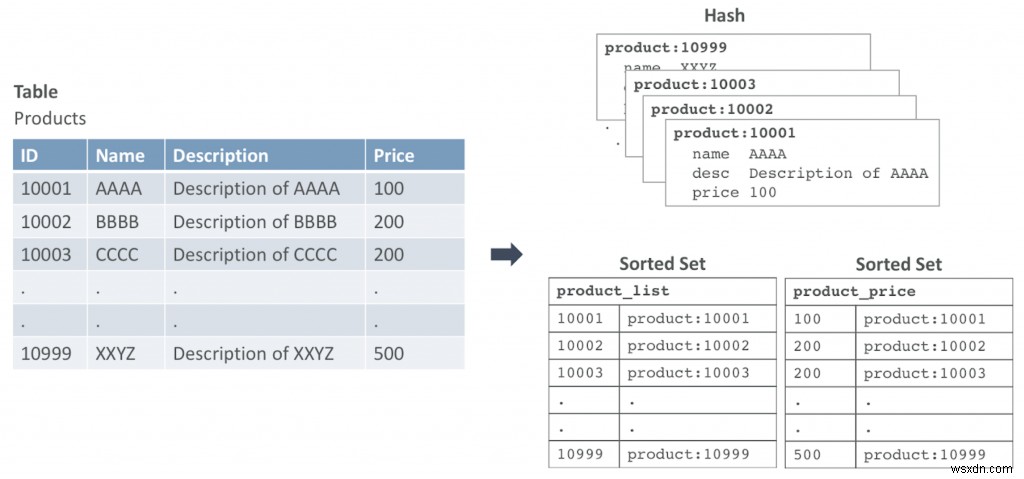
この方法を採用する場合、SQLコマンドの代わりにRedisクエリを使用するようコードを修正する必要があります。以下に、SQLと同等のRedisコマンドの例をいくつか示します。
A. データの挿入
SQL:
insert into Products (id, name, description, price)
values = (10200, “ZXYW”,“Description for ZXYW”, 300);
Redis:
MULTI
HMSET product:10200 name ZXYW desc “Description for ZXYW” price 300
ZADD product_list 10200 product:10200
ZADD product_price 300 product:10200
EXEC
B. 商品IDによるクエリ
SQL:
select * from Products where id = 10200
Redis:
HGETALL product:10200
C. 価格によるクエリ
SQL:
select * from Product where price < 300
Redis:
ZRANGEBYSCORE product_price 0 300
これにより、product:10001、product:10002、product:10003というキーが返されます。続けて、各キーに対してHGETALLを実行しましょう。
HGETALL product:10001
HGETALL product:10002
HGETALL product:10003
DataFramesを使ってテーブルを自動的にRedisデータ構造へマッピングする
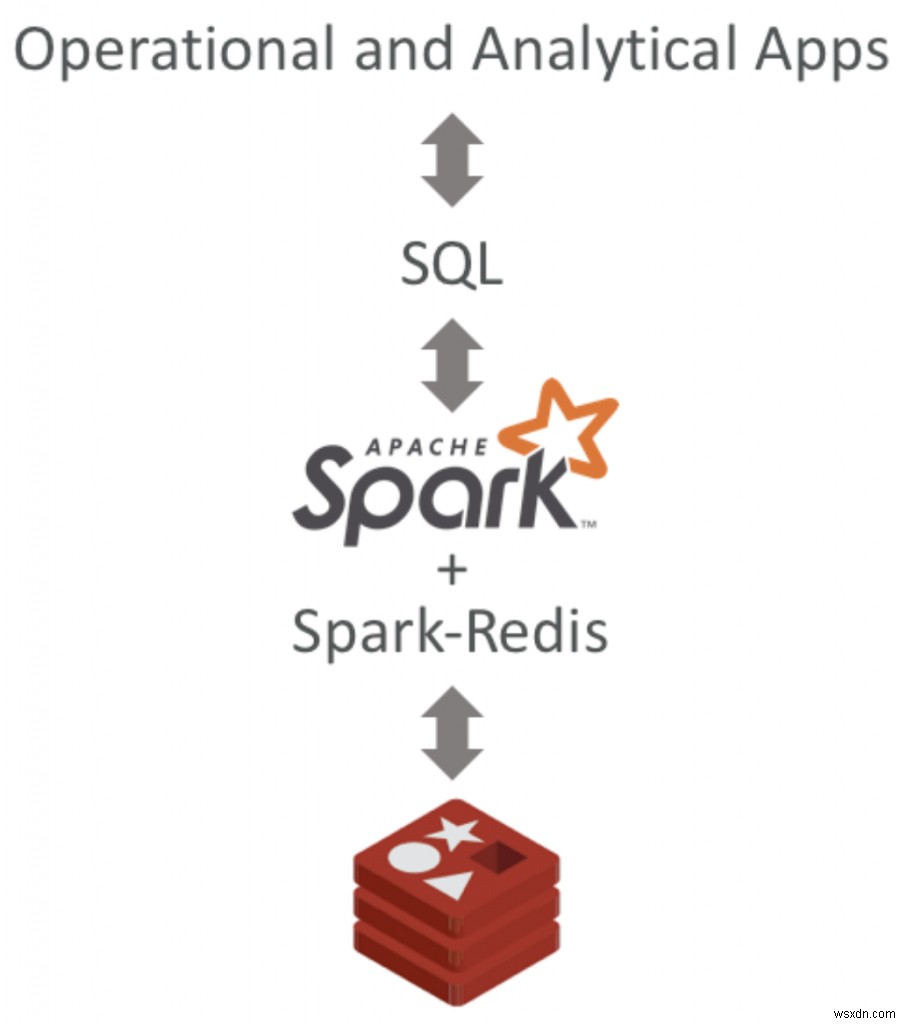
ソリューションでSQLインターフェースを維持しつつ、パフォーマンス向上のためだけに基盤となるデータストアをRedisへ変更したい場合は、Apache SparkとSpark-Redisライブラリを活用することで実現できます。
Spark-Redisライブラリを使用すると、DataFrame APIを通じてRedisデータの保存やアクセスが可能になります。つまり、SQLコマンドでデータの挿入・更新・クエリを行いながら、内部ではデータが自動的にRedisデータ構造へマッピングされるのです。
まず、spark-redisをダウンロードしてライブラリをビルドし、jarファイルを取得する必要があります。たとえばspark-redis 2.3.1の場合、「spark-redis-2.3.1-SNAPSHOT-jar-with-dependencies.jar」というファイルが生成されます。
次に、Redisインスタンスが起動していることを確認してください。この例では、localhostのデフォルトポート6379でRedisを実行します。
また、Apache Sparkエンジン上でもクエリを実行できます。以下はその具体例です。
$ spark-shell --jars spark-redis-2.3.1-SNAPSHOT-jar-with-dependencies.jar
scala> import org.apache.spark.sql.SparkSession

scala> val spark = SparkSession
.builder()
.appName("redis-sql")
.master("local[*]")
.config("spark.redis.host","localhost")
.config("spark.redis.port","6379").getOrCreate()

scala> import spark.sql

scala> import spark.implicits._

scala> sql("create table if not exists products(id string, name string, description string, price int) using org.apache.spark.sql.redis options (table 'product')")

scala> sql("insert into products values = ('10200','ZXYW','Description of ZXYW', 300)")

scala> val results = sql("select * from products")

scala> results.show()
+-----+----+-------------------+-----+
| id|name| description|price|
+-----+----+-------------------+-----+
|10200|ZXYW|Description of ZXYW| 300|
+-----+----+-------------------+-----+
さらに、Redisクライアントを使えば、このデータにRedisデータ構造として直接アクセスすることもできます。
127.0.0.1:6379> keys product*
1) "product:2e3f8611dbe94a588706a2aaea547caa"
より効率的なアプローチはscanコマンドの使用です。scanコマンドなら、データを走査しながらページネーションできるため、大量のデータを扱う際に便利です。
127.0.0.1:6379> scan 0 match product*
1) "3"
2) 1) "product:2e3f8611dbe94a588706a2aaea547caa"
127.0.0.1:6379> hgetall product:2e3f8611dbe94a588706a2aaea547caa
1) "name"
2) "ZXYW"
3) "price"
4) "300"
5) "description"
6) "Description of ZXYW"
7) "id"
8) "10200"
以上が、既存システムを中断することなくRedis SQLクエリを実行するための2つのシンプルな方法です。さらに一歩進んでみたい方は、新しいホワイトペーパー「Why Your SQL Server Needs Redis」もぜひご覧ください。
なお、Redisによるリアルタイムデータ処理については、ここで紹介したのはリアルタイム体験を提供する数ある方法のほんの一例にすぎません。
Redisがリアルタイムのデータ伝送をどのように実現できるのか詳しく知りたい方は、ぜひお気軽にお問い合わせください。
-
データを失わずにMBRをGPTへ変換する完全ガイド【Windows 10対応】
PCの年代やスペックによって、お使いのパソコンはマスターブートレコード(MBR)またはGUIDパーティションテーブル(GPT)のどちらかを使用しています。より新しく高性能なフォーマットであるGPTへディスク形式を移行したいと考えているなら、朗報です。実は、データを一切失うことなく変換を行うことができます。MBRからGPTへの切り替えを検討する理由は数多くあります。しかし、一般的な変換手法の中には、レガシーなBIOSから新しいUEFIへの移行と同時にディスクをMBRからGPTへ変換する過程で、ディスク上のデータをすべて消去してしまうものもあります。本記事では、データ損失なしで安全に変換する方法を
-
Redisを再発見した3人のコミュニティメンバー:バイオテック・メドテック・ロボティクスでの活用
Redisコミュニティが革新的なアプリケーションを動かすために、いかに創造的で強力な方法でRedisを活用しているか――私たちは常にそこにインスピレーションを受けています。創刊号のRediscover Magazineでは、データ課題の克服に向けてRedisを「再発見」した3人のコミュニティメンバーをご紹介しました。今回取り上げるのは、Carlos Justiniano氏、Matthew Goos氏、Dan Pipe-Mazo氏の3人。それぞれバイオテック、メドテック、ロボティクスという異なる分野でRedisをどう活用しているのか、詳しく掘り下げていきます。Rediscover Magazin