
「インピーダンスミスマッチテスト」:データプラットフォームはシンプルか、それとも複雑か?
「シンプルさこそが究極の洗練である」 — レオナルド・ダ・ヴィンチ
「ほとんどの情報は無関係であり、ほとんどの努力は無駄である。しかし、専門家だけが何を無視すべきかを知っている」 — ジェームズ・クリア著『アトミック・ハビット』
多様なシステムで構成された派手なデータパイプラインをお持ちかもしれません。表面上は洗練されて見えますが、内部は複雑な迷路になっていることが少なくありません。異なるコンポーネントを接続するために大量の配管作業(プラミング)が必要になったり、常時監視が不可欠になったり、独自の専門知識を持つ大規模なチームが運用・デバッグ・管理に追われたりします。さらに、システムが増えればデータの重複箇所も増え、Out-of-sync状態やスタイルデータのリスクも高まります。各サブシステムが異なるベンダーによって独立して開発されているため、それらのアップグレードやバグ修正がパイプラインやデータ層を破壊する可能性さえあります。
注意しないと、以下の3分間の動画で描かれているような事態に陥るかもしれません。先にご覧になることを強くお勧めします。
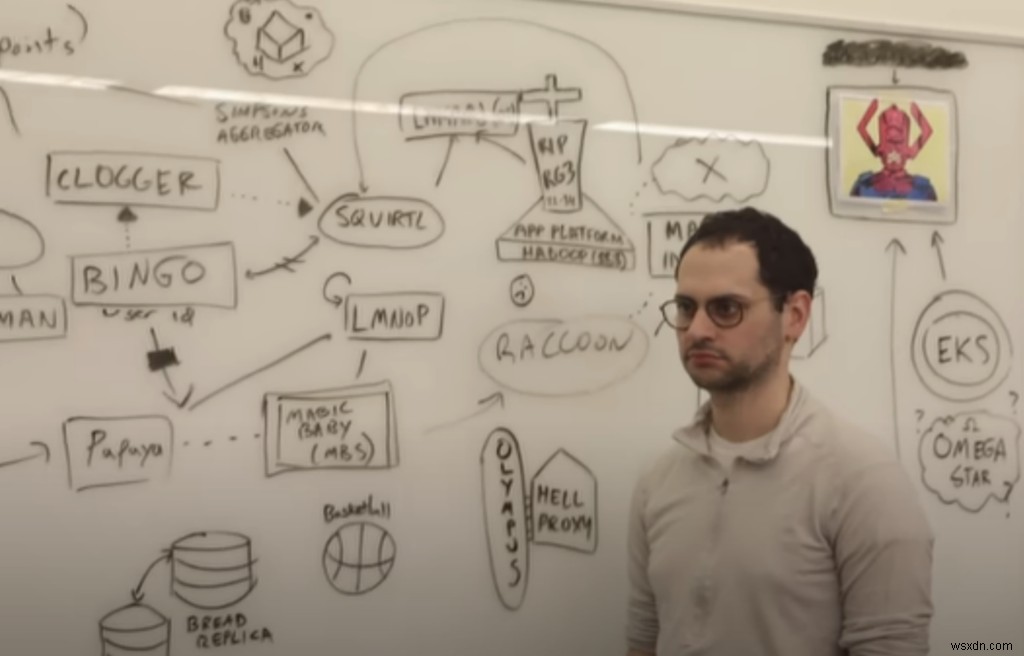
個々のシステムは表面上シンプルに見えても、実際には以下の変数をパイプラインに持ち込み、大量の複雑性を加えます:
- プロトコル — データをどう転送するか?(HTTP、TCP、REST、GraphQL、FTP、JDBC)
- データ形式 — どの形式をサポートするか?(バイナリ、CSV、JSON、Avro)
- データスキーマと進化 — データをどう格納するか?(テーブル、ストリーム、グラフ、ドキュメント)
- SDKとAPI — 必要なSDKやAPIが提供されているか?
- ACIDとBASE — ACID整合性かBASE整合性か?
- 移行 — データの移入・移出が容易か?
- 耐久性 — どの程度の耐久性保証があるか?
- 可用性 — どの程度の可用性保証があるか?(99.9%、99.999%)
- 拡張性 — どうスケールするか?
- セキュリティ — どの程度安全か?
- パフォーマンス — データ処理はどの程度高速か?
- ホスティングオプション — ホステッド型、オンプレミス型、ハイブリッド型か?
- クラウド対応 — 自社のクラウド、リージョンで動作するか?
- 追加システム — 別システムが必要か?(例:Kafka用のZooKeeper)
データ形式、スキーマ、プロトコルなどの変数は「変換オーバーヘッド」を構成します。パフォーマンス、耐久性、拡張性などの変数は「パイプラインオーバーヘッド」を構成します。これらを合わせたものが「インピーダンスミスマッチ」として知られるものです。これが測定できれば、複雑性を計算し、システムをシンプル化する指針にできます。詳しくは後ほど説明します。
「見た目は複雑だが、自分のニーズにとっては最もシンプルなシステムだ」と反論されるかもしれません。しかし、それをどう証明しますか?
つまり、データ層が本当にシンプルか複雑かをどう測定・判断するか? そして、将来機能を追加した際にシステムがシンプルであり続けるか、それとも新たなシステムが必要になるかをどう見積もるか?
ここで登場するのが「インピーダンスミスマッチテスト」です。まずインピーダンスミスマッチとは何かを理解し、その後テストの詳細に入ります。
インピーダンスミスマッチとは
この用語は電気工学に由来し、電気インピーダンスの不一致により、ポイントAからポイントBへエネルギーを転送する際にエネルギー損失が生じる現象を説明するものです。
簡単に言えば、「手元にあるもの」と「必要なもの」が一致しない状態です。それを使うには、手元のものを必要な形に変換してから使用する必要があり、ここにミスマッチと、それを解消するためのオーバーヘッドが発生します。
データの世界では、データが何らかの形・量で存在し、それを利用可能な形に変換する必要があります。この変換は複数回発生し、間に複数のシステムを挟むこともあります。
データベースの世界では、インピーダンスミスマッチは主に2つの理由で発生します:
- 変換オーバーヘッド:システムがデータを処理・格納する方法が、データの本来の姿や、開発者が考えるモデルと異なる場合。例:サーバーサイドではコレクション、ストリーム、リスト、セット、配列など多様なデータ構造で自然にモデリングできますが、RDBMSのテーブルやJSONドキュメントストアに格納するにはマッピングが必要です。読み出し時は逆の変換が必要です。オブジェクト指向モデルとリレーショナルテーブルモデルの具体的なミスマッチは「オブジェクト・リレーショナル インピーダンスミスマッチ」として知られています。
- パイプラインオーバーヘッド:サーバーで処理するデータの量・種類と、データベースが扱える量・種類が異なる場合。例:モバイルデバイスから数百万イベントが流れてくるとき、典型的なRDBMSやドキュメントストアでは格納できなかったり、集計・計算用のAPIが不足したりします。そのためKafkaやRedis Streamsのようなストリーム処理システム、さらにデータウェアハウスが必要になります。
インピーダンスミスマッチテスト(IMSテスト)
このテストの目的は、プラットフォーム全体の複雑性を測定し、将来機能を追加した際に複雑性が増大するか縮小するかを判断することです。
テストの方法はシンプルです。「変換オーバーヘッド」と「パイプラインオーバーヘッド」を「インピーダンスミスマッチスコア(IMS)」として計算します。これにより、現在のシステムが他システムと比べてどの程度複雑か、また機能追加に伴って複雑性がどう変化するかがわかります。
IMSの計算式は以下の通りです:

式は両オーバーヘッドを足し合わせ、機能数で割るだけです。これにより「機能あたりの総オーバーヘッド=複雑性スコア」が得られます。
理解を深めるため、4つのシンプルなデータパイプラインを比較しスコアを計算します。さらに、シンプルなアプリを2フェーズで構築する想定で、機能追加に伴うIMSスコアの変化を見てみましょう。
フェーズ1:リアルタイムダッシュボードの構築
モバイルデバイスから毎分数百万のボタンクリックイベントが届き、ドロップやスパイクがあればアラートを出す要件です。これを大規模アプリの1機能とみなします。
ケース1:RDBMSのみでイベントを格納(テーブルが合わない可能性あり)
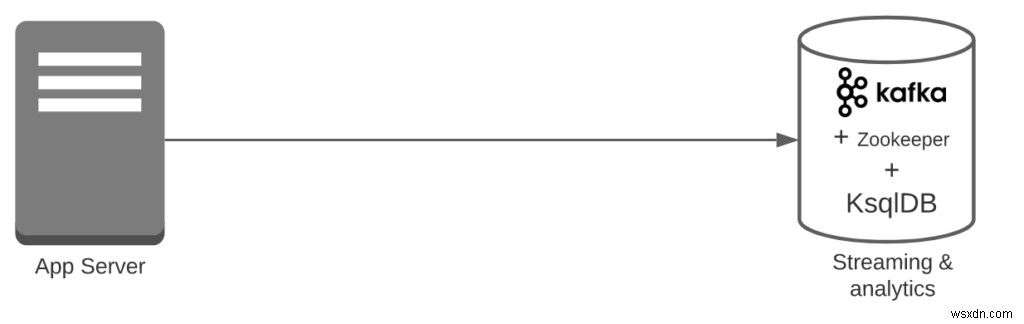
- 変換オーバーヘッド = 1
- イベントストリームをテーブルに変換する必要がある
- パイプラインオーバーヘッド = 1
- パイプラインにDBが1つだけ
- 機能数 = 1
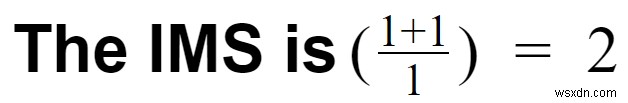
ケース2:Kafkaで処理し、RDBMSに格納
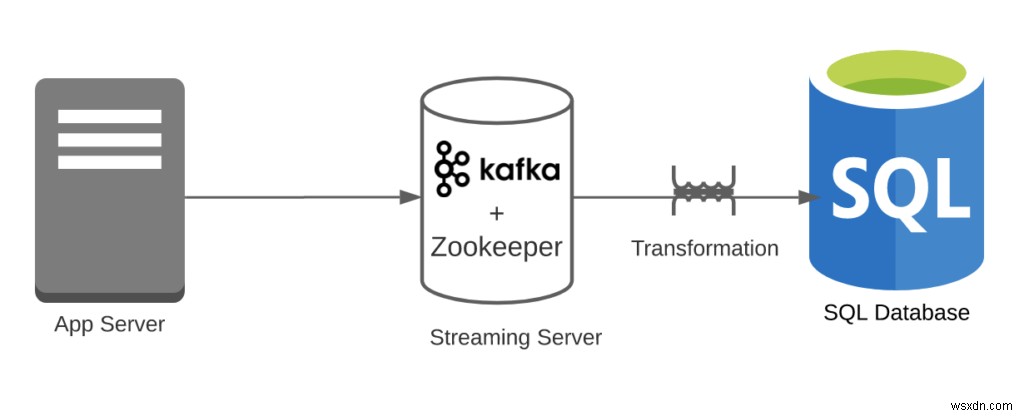
- 変換オーバーヘッド = 1
- Kafkaはクリックストリームを容易に処理できるが、Kafka→RDBMSはオーバーヘッド
- パイプラインオーバーヘッド = 2
- 2システム(RDBMSとKafka)。※ZooKeeperは無視
- 機能数 = 1
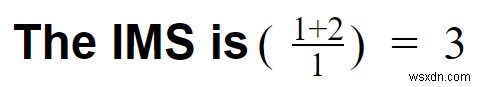
ケース3:Kafkaで処理し、ksqlDBに格納
- 変換オーバーヘッド = 0
- Kafkaはクリックストリームを容易に処理できる
- パイプラインオーバーヘッド = 1
- 1システムのみ(Kafka + ksqlDB)。※ZooKeeperは無視
- 機能数 = 1
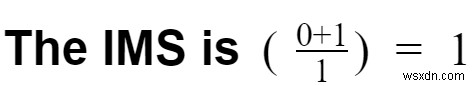
ケース4:Redis Streamsで処理し、RedisTimeSeriesに格納(両方ともRedisの一部でネイティブ連携)
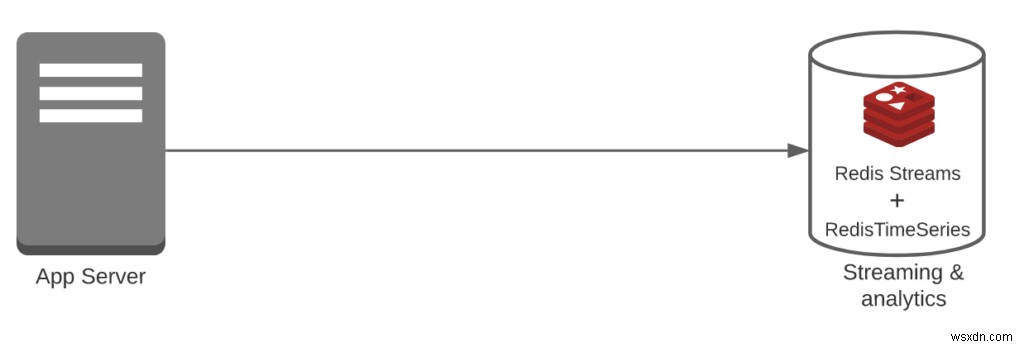
- 変換オーバーヘッド = 0
- Redis Streamsはクリックストリームを容易に処理できる
- パイプラインオーバーヘッド = 1
- 1システムのみ(Redis Streams + RedisTimeSeries)
- 機能数 = 1
フェーズ1後の結論
4システムを比較した結果、「ケース3」と「ケース4」がIMSスコア1で最もシンプルでした。この時点では同点ですが、機能追加後も同じでしょうか?
さらに機能を追加し、IMSがどう変化するか見てみましょう。
フェーズ2:IPホワイトリスト機能付きリアルタイムダッシュボード
同じアプリで、ホワイトリスト登録済みIPアドレスからのイベントのみ許可する要件を追加します。新機能が1つ増えました。
ケース1:RDBMSでイベント格納、Redis/MemCachedでIPホワイトリスト
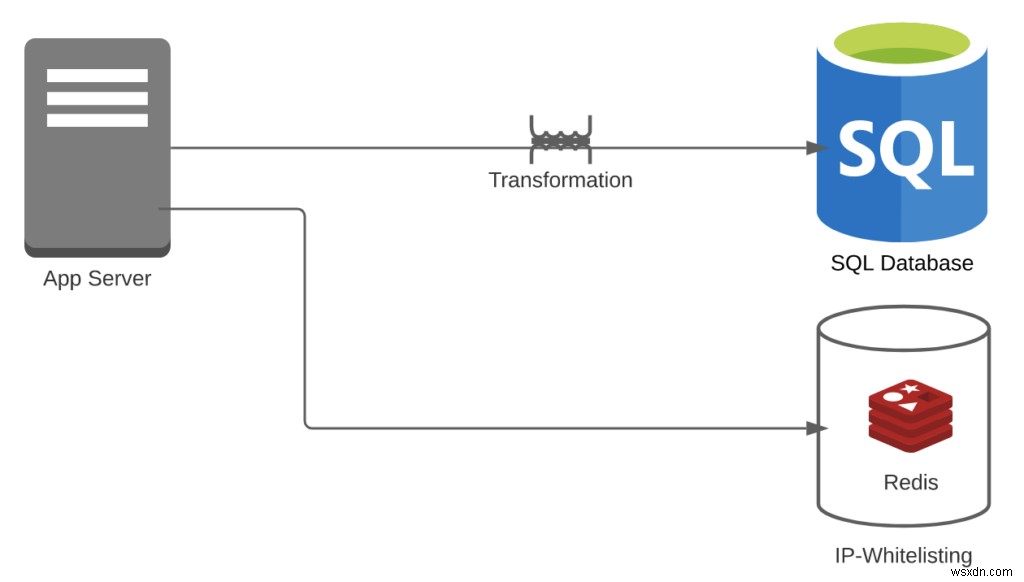
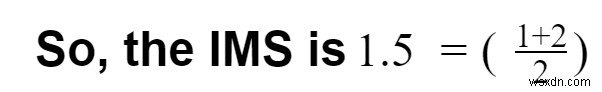
- 変換オーバーヘッド = 1
- IPホワイトリストには変換不要。ただしイベントストリーム→テーブル変換は必要
- パイプラインオーバーヘッド = 2
- Redis + RDBMS
- 機能数 = 2
ケース2:Redis + Kafka + RDBMS
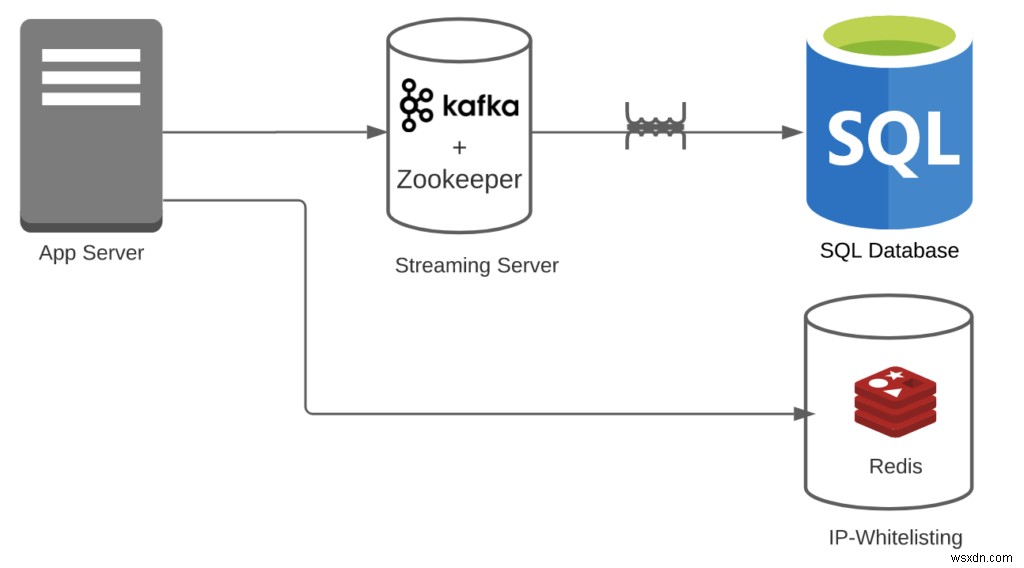
- 変換オーバーヘッド = 1
- IPホワイトリストには変換不要。Kafkaもストリームを容易に処理可能
- パイプラインオーバーヘッド = 3
- Redis + Kafka + RDBMS。※Kafka用ZooKeeperを加えるとさらに悪化
- 機能数 = 2
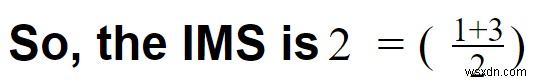
ケース3:Redis + Kafka + ksqlDB
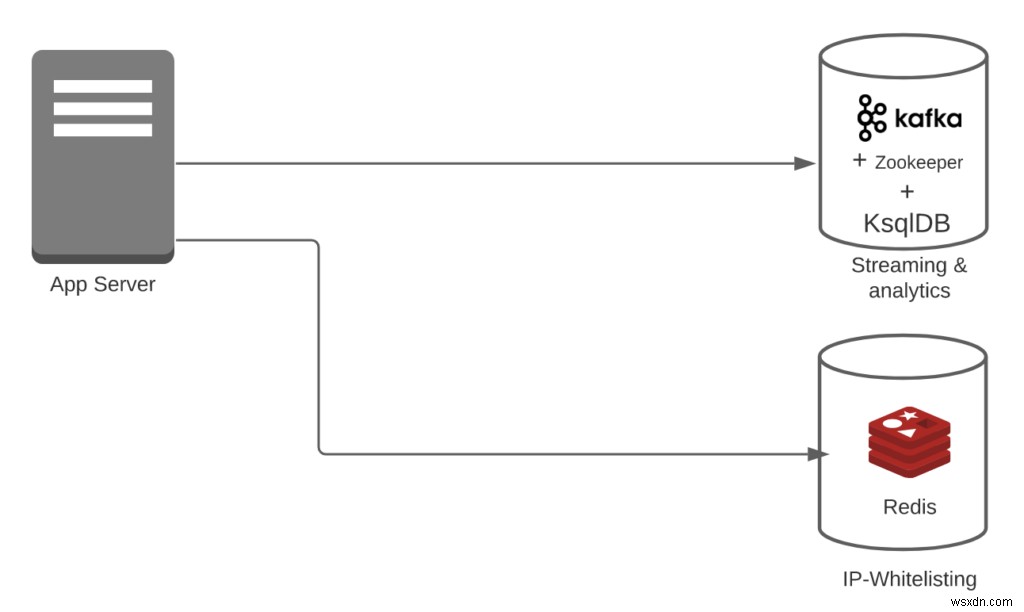
- 変換オーバーヘッド = 0
- IPホワイトリストには変換不要。KafkaとksqlDBもストリームを容易に処理可能
- パイプラインオーバーヘッド = 2
- Redis + (Kafka + ksqlDB)。※Kafka+ksqlDBを同一システムとみなす
- 機能数 = 2
ケース4:Redis + Redis Streams + RedisTimeSeries
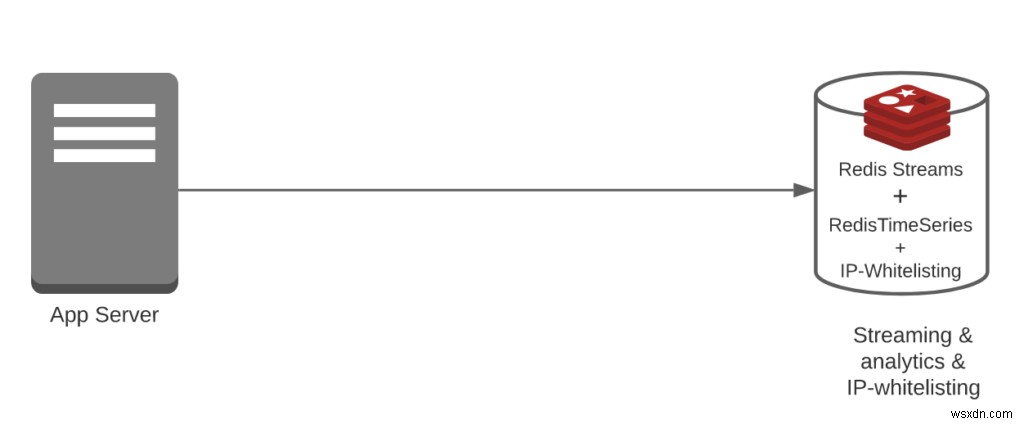
- 変換オーバーヘッド = 0
- IPホワイトリストには変換不要。Redis StreamsとRedisTimeSeriesもストリームとアラートを容易に処理可能
- パイプラインオーバーヘッド = 1
- Redis + Redis Streams + RedisTimeSeries。※3つとも同一システムの一部
- 機能数 = 2
フェーズ2後の結論
機能追加後の変化:
- ケース1:フェーズ1で2 → フェーズ2で1.5に低下
- ケース2:フェーズ1で3 → フェーズ2で2に低下
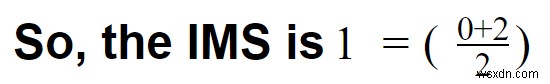
- ケース3:フェーズ1で1 → フェーズ2で1を維持
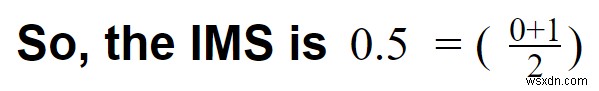
- ケース4:フェーズ1で1 → フェーズ2で0.5に低下(最良)
この例では、フェーズ1で最低スコアの1だったケース4が、新機能追加でさらに改善し0.5になりました。
注意:別の機能を追加すればケース4が最シンプルでなくなる可能性もあります。それがIMSスコアの考え方です。全機能をリストアップし、異なるアーキテクチャで比較し、ユースケースに最適なものを見極めます。
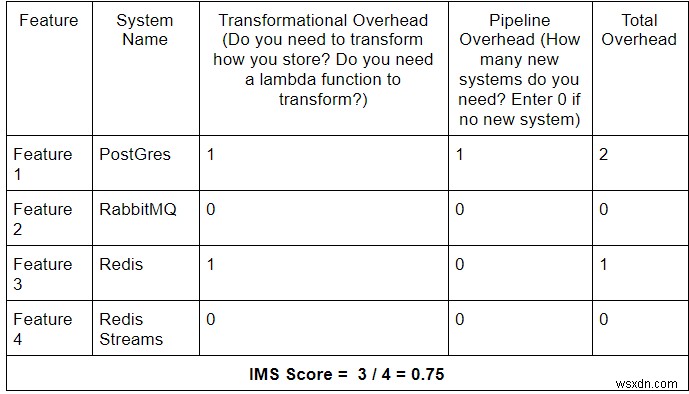
より簡単に使えるよう、シンプルなスプレッドシートで実装できるIMS計算機を提供します。
IMS計算機
使い方:
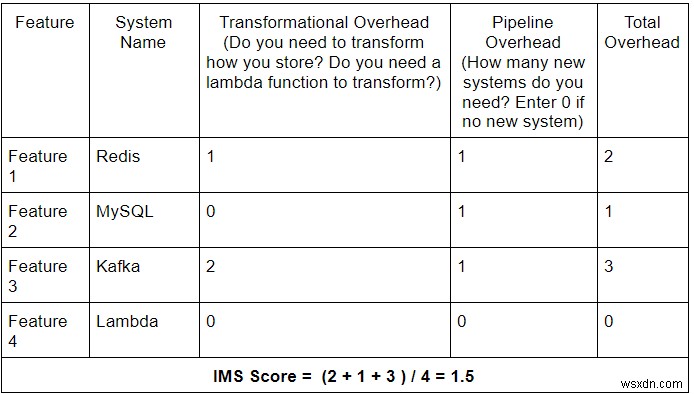
- 各データ層・データパイプラインについて、以下をリストアップ:
- 現在の機能
- ロードマップ上の機能(重要:今後の機能追加でもオーバーヘッド増なしで対応できるか確認するため)
- 各機能について、変換オーバーヘッドとパイプラインオーバーヘッドを割り当て
- 全オーバーヘッドの合計を機能数で割る
- 異なるシステム構成のパイプラインについて手順2〜3を繰り返し、比較検討
データパイプライン1
データパイプライン2
まとめ
結果を考えずに複雑なデータ層を構築してしまうのは非常に簡単です。IMSスコアは、その意思決定を意識的に行うためのツールとして作られました。
IMSスコアを使えば、ユースケースに合わせて複数のシステムを簡単に比較・検討し、どれが自社の機能セットに真に最適かを見極められます。また、機能拡張に耐え、可能な限りシンプルさを維持できるかを検証できます。
常に心に留めておきたい言葉:
「シンプルさこそが究極の洗練である」 — レオナルド・ダ・ヴィンチ
「ほとんどの情報は無関係であり、ほとんどの努力は無駄である。しかし、専門家だけが何を無視すべきかを知っている」 — ジェームズ・クリア著『アトミック・ハビット』
-
Google Chromeで閲覧データを消去する2つの簡単な方法
ウェブサイトが自分について保存しているデータを、以前よりも自由にコントロールできることをご存じですか?Google Chromeにはプライバシー保護のための便利な機能が数多く搭載されています。かつては個別のCookieしか削除できませんでしたが、現在ではウェブサイトが保存したすべてのデータをまとめて削除することも可能です。 この記事では、Google Chromeで閲覧データを削除する2つの方法――「Chromeアクション」と「設定」メニュー――の手順を詳しく解説します。 Chromeアクションで閲覧データを消去する方法 1つ目の方法は、アドレスバーから使えるショートカット機能「Chromeア
-
インターネットから個人データを削除する方法【Google・Facebook・Xなど主要サービス別ガイド】
GoogleやFacebookなどのオンラインサービスを利用する際、私たちは多くの個人情報を企業に提供しています。この点に不安を感じるのは自然なことです。幸いなことに、インターネット上の自分の個人データは比較的簡単に削除できます。ただし、サービスごとに削除手順が異なるため、それぞれの方法を把握しておくことが重要です。このガイドでは、主要なWebサービスから個人情報を削除する具体的な手順を詳しく解説します。 Googleアカウントの個人データを削除する方法 Googleは世界で最も利用されているサービスの一つであり、パーソナライズされたコンテンツを提供するために膨大なデータを保存しています。