
C++で二分木を二分探索木(BST)へ変換する方法を解説
二分木(Binary Tree)とは
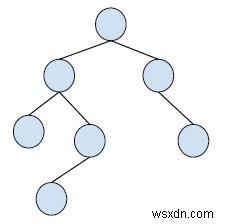
二分木とは、木構造の各ノードが最大で2つの子ノードを持つことができる特別な木構造です。これらの子ノードは、それぞれ「左の子ノード」と「右の子ノード」と呼ばれます。
シンプルな二分木の例は以下の通りです。
二分探索木(BST)とは
二分探索木(BST)は、以下のルールに従う特別な木構造です。
- 左の子ノードの値は、常に親ノードの値より小さい
- 右の子ノードの値は、常に親ノードの値より大きい
- すべてのノードが、それぞれ独立して二分探索木の性質を満たす
二分探索木(BST)の例は以下の通りです。
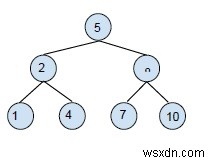
二分探索木は、検索や最小値・最大値の探索といった操作の計算量を削減するために用いられるデータ構造です。
二分木をBSTへ変換する
ここでは、二分木(BT)が与えられ、それを二分探索木(BST)へ変換することを考えます。重要なポイントとして、この変換では元の二分木の構造は変更してはいけません。ノードの値だけを入れ替えて、BSTの条件を満たすようにします。
具体的な例を使って、二分木をBSTへ変換する流れを見ていきましょう。
入力: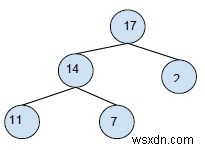
出力: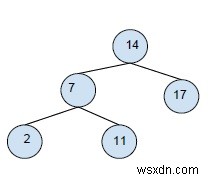
変換の手順
二分木から二分探索木への変換は、以下の3つのステップで行われます。
- ステップ1:二分木を中順巡回(Inorder Traversal)し、訪問したノードの値を配列 arr[] に格納します。
- ステップ2:任意のソートアルゴリズムを使って、配列 arr[] を昇順にソートします。
- ステップ3:木を再び中順巡回し、ソート済み配列の要素を順番に木の各ノードへ書き戻します。
この方法がうまく機能するのは、二分探索木を中順巡回すると必ず昇順に値が並ぶという性質があるためです。ソート済みの配列の値を中順巡回の順に書き戻すことで、木の構造を変えずにBSTの条件を満たすことができます。
C++での実装例
#include<stdio.h>
#include<stdlib.h>
struct node{
    int data;
    struct node *left;
    struct node *right;
};
void Inordertraversal(struct node* node, int inorder[], int *index_ptr){
    if (node == NULL)
       return;
    Inordertraversal(node->left, inorder, index_ptr);
    inorder[*index_ptr] = node->data;
    (*index_ptr)++;
    Inordertraversal(node->right, inorder, index_ptr);
}
int countNodes(struct node* root){
    if (root == NULL)
       return 0;
    return countNodes (root->left) +
    countNodes (root->right) + 1;
}
int compare (const void * a, const void * b){
    return( *(int*)a - *(int*)b );
}
void arrayToBST (int *arr, struct node* root, int *index_ptr){
    if (root == NULL)
       return;
    arrayToBST (arr, root->left, index_ptr);
    root->data = arr[*index_ptr];
    (*index_ptr)++;
    arrayToBST (arr, root->right, index_ptr);
}
struct node* newNode (int data){
    struct node *temp = new struct node;
    temp->data = data;
    temp->left = NULL;
    temp->right = NULL;
    return temp;
}
void printInorder (struct node* node){
    if (node == NULL)
       return;
    printInorder (node->left);
    printf("%d ", node->data);
    printInorder (node->right);
}
int main(){
    struct node *root = NULL;
    root = newNode(17);
    root->left = newNode(14);
    root->right = newNode(2);
    root->left->left = newNode(11);
    root->right->right = newNode(7);
    printf("Inorder Traversal of the binary Tree: \n");
    printInorder (root);
    int n = countNodes(root);
    int *arr = new int[n];
    int i = 0;
    Inordertraversal(root, arr, &i);
    qsort(arr, n, sizeof(arr[0]), compare);
    i = 0;
    arrayToBST (arr, root, &i);
    delete [] arr;
    printf("\nInorder Traversal of the converted BST: \n");
    printInorder (root);
    return 0;
}
実行結果
Inorder Traversal of the binary Tree:
11 14 17 2 7
Inorder Traversal of the converted BST:
2 7 11 14 17
実行結果から、変換後の木を中順巡回すると値が昇順に並んでいることがわかります。これは、変換後の木が二分探索木の条件を正しく満たしていることを示しています。
このアルゴリズムの計算量は、中順巡回に O(n)、ソートに O(n log n)、書き戻しに O(n) かかるため、全体として O(n log n) となります。
-
C++で実装する二分探索木(BST)イテレータの作り方
二分探索木(BST)に対するイテレータを実装することを考えてみましょう。このイテレータには、次の2つのメソッドが必要です。 next():次の要素(次に小さい値)を返すメソッド hasNext():次の要素が存在するかどうかをブール値で返すメソッド 例えば、以下のような二分探索木があるとします。 この木に対して、関数呼び出しのシーケンスが [next(), next(), hasNext(), next(), hasNext(), next(), hasNext(), next(), hasNext()] である場合、出力は [3, 7, true, 9, true, 15, true,
-
C++プログラムにおける二分探索(バイナリサーチ)の基本と実装
二分探索(バイナリサーチ)とは二分探索は「半区間探索」「対数探索」「バイナリチョップ」とも呼ばれる検索アルゴリズムで、ソート済みの配列の中から目的の値が存在する位置を効率的に見つけ出します。基本的な仕組みは非常にシンプルです。まず、探したい値(ターゲット値)を配列の中央の要素と比較します。一致しなかった場合は、ターゲット値が存在し得ない半分を丸ごと排除し、残りの半分に対して同様の比較を繰り返します。この「中央との比較」と「範囲の絞り込み」を続け、ターゲット値が見つかるか、検索範囲が空になる(=配列にその値が存在しない)かのどちらかで処理が終了します。アイデア自体は簡単ですが、正しく実装するには