
C++で実装する二分探索木(BST)イテレータの作り方
二分探索木(BST)に対するイテレータを実装することを考えてみましょう。このイテレータには、次の2つのメソッドが必要です。
- next():次の要素(次に小さい値)を返すメソッド
- hasNext():次の要素が存在するかどうかをブール値で返すメソッド
例えば、以下のような二分探索木があるとします。
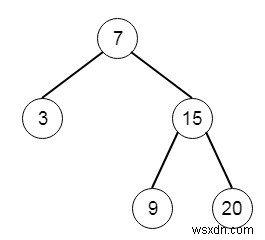
この木に対して、関数呼び出しのシーケンスが [next(), next(), hasNext(), next(), hasNext(), next(), hasNext(), next(), hasNext()] である場合、出力は [3, 7, true, 9, true, 15, true, 20, false] となります。これは、木の中順走査(inorder traversal)の順序で値が取り出されることを意味します。
解決のためのアプローチ
この問題は、スタックを使って中順走査を効率的に管理することで解決できます。具体的な手順は以下の通りです。
next() メソッドの処理内容
- スタックの先頭要素を
currとして取得し、その要素をスタックからポップする currの右の子が存在する場合、右部分木の中順後継者(inorder successor)となるノード群をスタックにプッシュする- 現在のノードの値を返す
hasNext() メソッドの処理内容
- スタックが空でなければ
trueを、空であればfalseを返す
コンストラクタでは、ルートノードから左方向へ辿りながら、すべての左端ノードをスタックに積んでおきます。これにより、next() が呼ばれるたびに最小の未訪問ノードが常にスタックの先頭に来るようになります。
それでは、実際の実装を見てみましょう。
実装例(C++)
#include <bits/stdc++.h>
using namespace std;
class TreeNode{
    public:
        int val;
        TreeNode *left, *right;
        TreeNode(int data){
            val = data;
            left = right = NULL;
        }
};
void insert(TreeNode **root, int val){
    queue<TreeNode*> q;
    q.push(*root);
    while(q.size()){
        TreeNode *temp = q.front();
        q.pop();
        if(!temp->left){
            if(val != NULL)
                temp->left = new TreeNode(val);
            else
                temp->left = new TreeNode(0);
            return;
        } else {
            q.push(temp->left);
        }
        if(!temp->right){
            if(val != NULL)
                temp->right = new TreeNode(val);
            else
                temp->right = new TreeNode(0);
            return;
        }else{
            q.push(temp->right);
        }
    }
}
TreeNode *make_tree(vector<int> v){
    TreeNode *root = new TreeNode(v[0]);
    for(int i = 1; i<v.size(); i++){
        insert(&root, v[i]);
    }
    return root;
}
class BSTIterator {
public:
    stack <TreeNode*> st;
    void fillStack(TreeNode* node){
        while(node && node->val != 0){
            st.push(node);
            node=node->left;
        }
    }
    BSTIterator(TreeNode* root) {
        fillStack(root);
    }
    /** @return 次に小さい数値を返す */
    int next() {
        TreeNode* curr = st.top();
        st.pop();
        if(curr->right && curr->right->val != 0){
            fillStack(curr->right);
        }
        return curr->val;
    }
    /** @return 次に小さい数値が存在するかどうかを返す */
    bool hasNext() {
        return !st.empty();
    }
};
main(){
    vector<int> v = {7,3,15,NULL,NULL,9,20};
    TreeNode *root = make_tree(v);
    BSTIterator ob(root);
    cout << "Next: " << ob.next() << endl;
    cout << "Next: " << ob.next() << endl;
    cout << ob.hasNext() << endl;
    cout << "Next: " << ob.next() << endl;
    cout << ob.hasNext() << endl;
    cout << "Next: " << ob.next() << endl;
    cout << ob.hasNext() << endl;
    cout << "Next: " << ob.next() << endl;
    cout << ob.hasNext() << endl;
}
入力
BSTIterator ob(root);
ob.next()
ob.next()
ob.hasNext()
ob.next()
ob.hasNext()
ob.next()
ob.hasNext()
ob.next()
ob.hasNext()
出力
Next: 3
Next: 7
1
Next: 9
1
Next: 15
1
Next: 20
0
計算量について
この実装における計算量は以下の通りです。
- 時間計算量:next() および hasNext() は平均して O(1) で動作します。各ノードはスタックに最大1回プッシュされ、1回ポップされるだけだからです。
- 空間計算量:O(h)(h は木の高さ)。スタックには、任意の時点で最大でも木の高さ分のノードしか保持されません。
このように、スタックを利用した中順走査の遅延評価により、メモリ効率よく二分探索木を昇順に走査できるイテレータが実現できます。
-
C++で二分木を二分探索木(BST)へ変換する方法を解説
二分木(Binary Tree)とは二分木とは、木構造の各ノードが最大で2つの子ノードを持つことができる特別な木構造です。これらの子ノードは、それぞれ「左の子ノード」と「右の子ノード」と呼ばれます。シンプルな二分木の例は以下の通りです。二分探索木(BST)とは二分探索木(BST)は、以下のルールに従う特別な木構造です。左の子ノードの値は、常に親ノードの値より小さい右の子ノードの値は、常に親ノードの値より大きいすべてのノードが、それぞれ独立して二分探索木の性質を満たす二分探索木(BST)の例は以下の通りです。二分探索木は、検索や最小値・最大値の探索といった操作の計算量を削減するために用いられるデ
-
C++プログラムにおける二分探索(バイナリサーチ)の基本と実装
二分探索(バイナリサーチ)とは二分探索は「半区間探索」「対数探索」「バイナリチョップ」とも呼ばれる検索アルゴリズムで、ソート済みの配列の中から目的の値が存在する位置を効率的に見つけ出します。基本的な仕組みは非常にシンプルです。まず、探したい値(ターゲット値)を配列の中央の要素と比較します。一致しなかった場合は、ターゲット値が存在し得ない半分を丸ごと排除し、残りの半分に対して同様の比較を繰り返します。この「中央との比較」と「範囲の絞り込み」を続け、ターゲット値が見つかるか、検索範囲が空になる(=配列にその値が存在しない)かのどちらかで処理が終了します。アイデア自体は簡単ですが、正しく実装するには