
木構造における部分木のDFSクエリをC++で効率的に処理する方法
この問題では、二分木が与えられ、特定のノードからDFS(深さ優先探索)を実行することが求められます。その際、与えられたノードを根(ルート)とみなして探索を行います。
下の木構造では、ノードFからDFSを実行する場合を例に考えてみましょう。
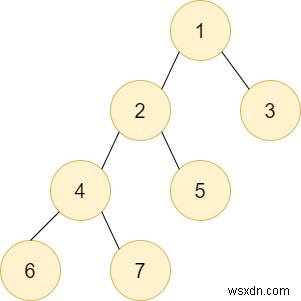
本チュートリアルでは、時間計算量を大幅に削減できる工夫された手法を適用することで、より大きな入力サイズでもコードを高速に実行できるようにします。
アプローチ
この手法では、クエリごとにすべてのノードからDFSをやり直す素朴な方法は採用しません。その方法では制約が大きい場合にTLE(実行時間超過)が発生する可能性が高いためです。代わりに、事前計算を活用した効率的な手法を用います。
具体的には、まず木全体のDFS訪問順序を一度だけ事前計算して配列に格納します。同時に、各ノードを起点とする部分木に含まれるノードの総数も記録しておきます。こうすることで、任意のノードに対する部分木のDFSクエリには、事前計算済みの配列から該当する範囲を取り出すだけで答えられるようになります。
#include <bits/stdc++.h>
using namespace std;
#define N 100000
// 木のノードの接続を格納する隣接リスト
vector<int> v[N];
unordered_map<int, int> mape; // ノードとそのインデックスを対応付けるために使用
vector<int> a;
void dfs(int nodesunder[], int child, int parent){ // DFSとnodesunderの事前計算を行う関数
    a.push_back(child); // 木のDFS訪問順序を格納
    // 子部分木のノード数を初期化
    nodesunder[child] = 1;
    for (auto it : v[child]) { // 通常のDFSを実行
        if (it != parent) { // 子が親に遡るのを防ぐ(サイクルになるため)
            dfs(nodesunder, it, child); // 再帰呼び出し
            nodesunder[child] += nodesunder[it]; // 子の部分木のノード数を加算
        }
    }
}
// ノードの部分木のDFSを出力する関数
void printDFS(int node, int nodesunder[]){
    int ind = mape[node]; // DFS配列におけるノードのインデックス
    cout << "The DFS of subtree " << node << ": ";
    // 部分木のDFSを出力
    for (int i = ind; i < ind + nodesunder[node]; i++){ // DFS配列を走査し、対象ノード以下のすべてのノードを出力
        cout << a[i] << " ";
    }
    cout << endl;
}
void addEdgetoGraph(int x, int y){ // 隣接リストの管理用
    v[x].push_back(y);
    v[y].push_back(x);
}
void mark(){ // 各ノードにDFS配列内のインデックスを記録
    int size = a.size();
    // インデックスを記録
    for (int i = 0; i < size; i++) {
        mape[a[i]] = i;
    }
}
int main(){
    int n = 7;
    // 木の辺を追加
    addEdgetoGraph(1, 2);
    addEdgetoGraph(1, 3);
    addEdgetoGraph(2, 4);
    addEdgetoGraph(2, 5);
    addEdgetoGraph(4, 6);
    addEdgetoGraph(4, 7);
    // 各ノードの部分木に含まれるノード数を格納する配列
    int nodesunder[n + 1];
    dfs(nodesunder, 1, 0); // nodesunder配列を生成
    mark(); // mapにインデックスを記録
    // クエリ1
    printDFS(2, nodesunder);
    // クエリ2
    printDFS(4, nodesunder);
    return 0;
}
出力
The DFS of subtree 2: 2 4 6 7 5
The DFS of subtree 4: 4 6 7
コードの解説
このアプローチでは、まずDFSの訪問順序を事前計算してvectorに格納します。事前計算と同時に、各ノードを起点とする部分木に含まれるノード数(nodesunder)も計算しておきます。
クエリが来たら、対象ノードのDFS配列上の開始インデックスをunordered_mapから取得し、そこから部分木のノード数分だけ配列を走査して出力するだけで済みます。この方法により、前計算はO(N)、各クエリへの回答は部分木のサイズに比例した時間で実現でき、クエリごとにDFSをやり直す素朴な手法と比べて大幅な高速化が可能です。
まとめ
本チュートリアルでは、木構造における部分木のDFSクエリを効率的に処理する問題を解説しました。C++による実装例と、DFS順序の事前計算を活用した効率的なアプローチについて学びました。
同じロジックは、C、Java、Pythonなどの他のプログラミング言語でも実装可能です。この記事が皆さんのお役に立てば幸いです。
-
C++で二分木を見やすい形式で2次元配列に出力する方法
本記事では、二分木(バイナリツリー)を m×n の2次元文字列配列として整形して出力する方法を解説します。出力には以下のルールが適用されます。行数 m は、与えられた二分木の高さと一致すること。列数 n は、必ず奇数になること。ルートノードの値は、最初の行のちょうど中央に配置する。ルートノードが存在する行と列によって、残りの領域は「左下」と「右下」の2つの部分に分割される。左側の部分木は左下の領域へ、右側の部分木は右下の領域へそれぞれ出力する。左右の領域は同じサイズとする。片方の部分木が存在しない場合でも、何も出力はしないものの、もう一方の部分木と同じサイズの領域は確保しておく必要がある。ただ
-
C++で二分木が別の二分木の部分木(サブツリー)であるかを判定する方法
はじめに二つの二分木が与えられたとき、小さい方の木がもう一方の二分木の部分木(サブツリー)として含まれているかどうかを判定する方法を解説します。例として、以下のような二つの木を考えてみましょう。この場合、2番目の木は1番目の木の部分木となっています。判定アルゴリズムの考え方この性質を確認するためには、大きい方の木を後順走査(post-order traversal)でたどり、各ノードを根とする部分木が2番目の木と完全に一致するかどうかを順番に調べます。一致する部分木が一つでも見つかれば、2番目の木は1番目の木の部分木であると判定できます。判定の流れは以下の通りです。1. 部分木側がNULLであ