
二分探索木の走査アルゴリズム完全解説:行順・先行順・後行順・レベル順をC++で実装
二分探索木の走査とは
この記事では、二分探索木(BST:Binary Search Tree)に格納されたキーを巡回するための4種類の走査アルゴリズムを解説します。具体的には、以下の4つです。
- 行順(Inorder)走査:左部分木 → 根 → 右部分木の順に訪問
- 先行順(Preorder)走査:根 → 左部分木 → 右部分木の順に訪問
- 後行順(Postorder)走査:左部分木 → 右部分木 → 根の順に訪問
- レベル順(Level-order)走査:木の上から階層ごとに左から右へ訪問
例として使用する木
説明のために、次のような二分探索木を想定します。
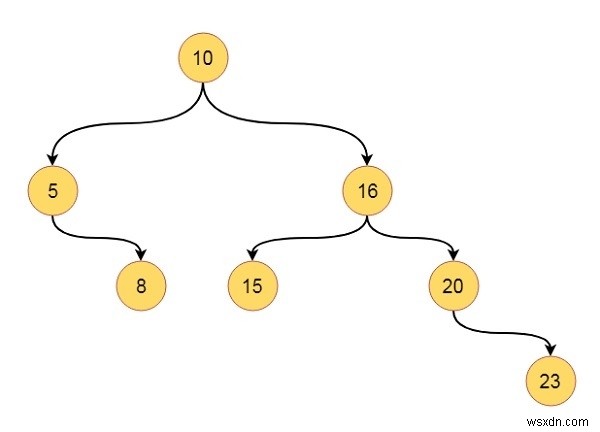
この木に対する各走査の結果は以下のようになります。
- 行順走査:5 8 10 15 16 20 23(昇順にソートされた結果が出力される)
- 先行順走査:10 5 8 16 15 20 23
- 後行順走査:8 5 15 23 20 16 10
- レベル順走査:10 5 16 8 15 20 23
特に注目すべき点として、二分探索木に対して行順走査を行うと、キーが必ず昇順に並んだ結果が得られます。これは二分探索木の重要な性質の一つです。
アルゴリズムの擬似コード
まず、各走査アルゴリズムの流れを擬似コードで確認しましょう。
行順・先行順・後行順走査(再帰による実装)
inorderTraverse(root):
Begin
    if root is not empty, then
        inorderTraversal(left of root)
        print the value of root
        inorderTraversal(right of root)
    end if
End

preorderTraverse(root):
Begin
    if root is not empty, then
        print the value of root
        preorderTraversal(left of root)
        preorderTraversal(right of root)
    end if
End

postorderTraverse(root):
Begin
    if root is not empty, then
        postorderTraversal(left of root)
        postorderTraversal(right of root)
        print the value of root
    end if
Endこれら3つの走査は、「値を出力するタイミング」だけが異なります。左・根・右のどの順序で訪問するかを入れ替えるだけで実装できる点がポイントです。
レベル順走査(キューによる実装)
levelOrderTraverse(root):
Begin
    define queue que to store nodes
    insert root into the que.
    while que is not empty, do
        item := item present at front position of queue
        print the value of item
        if left of the item is not null, then
            insert left of item into que
        end if
        if right of the item is not null, then
            insert right of item into que
        end if
        delete front element from que
    done
Endレベル順走査では再帰ではなくキュー(FIFO)を使用します。根から順にノードをキューへ追加し、先頭から取り出しながらその子ノードを追加していくことで、上の階層から順に訪問できます。
C++による実装例
次に、これらの走査アルゴリズムをC++で実際に実装してみましょう。
#include<iostream>
#include<queue>
using namespace std;

class node{
    public:
        int h_left, h_right, bf, value;
        node *left, *right;
};

class tree{
    private:
        node *get_node(int key);
    public:
        node *root;
        tree(){
            root = NULL; // 最初は根をNULLに設定
        }
        void inorder_traversal(node *r);
        void preorder_traversal(node *r);
        void postorder_traversal(node *r);
        void levelorder_traversal(node *r);
        node *insert_node(node *root, int key);
};

// 新しいノードを動的に生成する
node *tree::get_node(int key){
    node *new_node;
    new_node = new node;
    new_node->h_left = 0; new_node->h_right = 0;
    new_node->bf = 0;
    new_node->value = key; // キーの値を格納
    new_node->left = NULL; new_node->right = NULL;
    return new_node;
}

// 行順走査:左 → 根 → 右 の順に訪問
void tree::inorder_traversal(node *r){
    if(r != NULL){
        inorder_traversal(r->left);
        cout << r->value << " ";
        inorder_traversal(r->right);
    }
}

// 先行順走査:根 → 左 → 右 の順に訪問
void tree::preorder_traversal(node *r){
    if(r != NULL){
        cout << r->value << " ";
        preorder_traversal(r->left);
        preorder_traversal(r->right);
    }
}

// 後行順走査:左 → 右 → 根 の順に訪問
void tree::postorder_traversal(node *r){
    if(r != NULL){
        postorder_traversal(r->left);
        postorder_traversal(r->right);
        cout << r->value << " ";
    }
}

// レベル順走査:キューを使って階層ごとに訪問
void tree::levelorder_traversal(node *root){
    queue <node*> que;
    node *item;
    que.push(root); // 最初に根をキューへ挿入
    while(!que.empty()){
        item = que.front(); // キューの先頭要素を取得
        cout << item->value << " ";
        if(item->left != NULL) // 左の子があればキューへ挿入
            que.push(item->left);
        if(item->right != NULL) // 右の子があればキューへ挿入
            que.push(item->right);
        que.pop(); // 先頭要素をキューから削除
    }
}

// ノードの挿入:BSTの性質に従って配置する
node *tree::insert_node(node *root, int key){
    if(root == NULL){
        return (get_node(key)); // 木が空なら新しいノードを根にする
    }
    if(key < root->value){ // キーが根の値より小さければ左へ
        root->left = insert_node(root->left, key);
    }else if(key > root->value){ // キーが根の値より大きければ右へ
        root->right = insert_node(root->right, key);
    }
    return root; // 同じキーが既に存在する場合は挿入しない
}

main(){
    node *root;
    tree my_tree;
    // 木にキーを挿入する
    my_tree.root = my_tree.insert_node(my_tree.root, 10);
    my_tree.root = my_tree.insert_node(my_tree.root, 5);
    my_tree.root = my_tree.insert_node(my_tree.root, 16);
    my_tree.root = my_tree.insert_node(my_tree.root, 20);
    my_tree.root = my_tree.insert_node(my_tree.root, 15);
    my_tree.root = my_tree.insert_node(my_tree.root, 8);
    my_tree.root = my_tree.insert_node(my_tree.root, 23);
    cout << "In-Order Traversal: ";
    my_tree.inorder_traversal(my_tree.root);
    cout << "\nPre-Order Traversal: ";
    my_tree.preorder_traversal(my_tree.root);
    cout << "\nPost-Order Traversal: ";
    my_tree.postorder_traversal(my_tree.root);
    cout << "\nLevel-Order Traversal: ";
    my_tree.levelorder_traversal(my_tree.root);
}
実行結果
上記のプログラムをコンパイルして実行すると、以下の出力が得られます。
In-Order Traversal: 5 8 10 15 16 20 23
Pre-Order Traversal: 10 5 8 16 15 20 23
Post-Order Traversal: 8 5 15 23 20 16 10
Level-Order Traversal: 10 5 16 8 15 20 23
まとめ
二分探索木の走査には、行順・先行順・後行順・レベル順の4種類があります。深さ優先に分類される行順・先行順・後行順走査は再帰関数を使えば簡潔に実装でき、出力のタイミングを変えるだけで相互に変換できます。一方、レベル順走査(幅優先探索)はキューを活用することで、木を上から順に効率よく巡回できます。それぞれの走査には得意な用途があり、例えば行順走査はソート済みデータの取得、後行順走査は木の解放処理などに適しています。用途に応じて使い分けることが、効率的なプログラミングへの第一歩です。
-
二分木(バイナリツリー)のデータ構造と重要な性質を解説
二分木(バイナリツリー)とは、各ノードが持てる子ノードの数を最大2つに制限した木構造のデータ構造です。本記事では、この二分木が持つ重要な性質について、具体例とともにわかりやすく解説します。まず、次のような二分木を例に考えてみましょう。二分木の主な性質各レベルの最大ノード数:レベル「l」における最大ノード数は 2l−1 です。ここでいうレベルとは、根(ルート)からそのノードまでの経路上にあるノードの総数を指し、ルート自身も含みます。なお、ルートのレベルは1として扱います。木全体の最大ノード数:高さ h の二分木に含まれる最大ノード数は 2h−1 です。ここでいう高さとは、ルートから葉までの経路上
-
データ構造における二分木の表現方法|配列と連結リストの違いを解説
コンピュータメモリ上での二分木の表現方法 ここでは、二分木をコンピュータのメモリ上でどのように表現するかについて解説します。表現方法には主に2種類あり、配列を使う方法と連結リスト(リンクリスト)を使う方法があります。 配列による表現 まず、次のような二分木を例に考えてみましょう。 配列による表現では、木の要素をレベル順(幅優先順)に走査しながら格納していきます。つまり、ノードを上のレベルから順番に保存する方式です。存在しない要素がある場合は、その位置を空白のまま残します。上記の木を配列で表現すると、次のようになります。 123456789101112131415 10516-81520