
最適二分探索木(Optimal BST):探索コストを最小化する構築法とC++実装
ソート済みの整数集合と、各キーが検索される回数を示す頻度配列 freq が与えられたとします。ここでの課題は、これらのデータを用いて二分探索木(BST)を構築し、すべての検索にかかる合計コストを最小にすることです。
部分問題の解を保存して再利用するために、補助配列 cost[n][n] を作成します。この cost 行列を利用することで、問題をボトムアップ方式で効率的に解くことができます。
入力と出力
入力:
キー値(ノード)とその頻度。
Keys = {10, 12, 20}
Frequency = {34, 8, 50}
出力:
最小コストは 142。
以下は、与えられた値から構成できるBSTの例です。
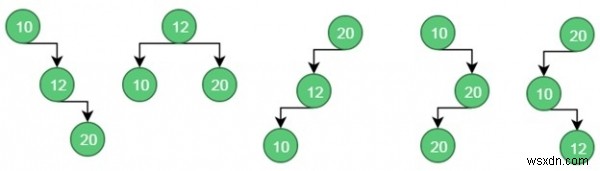 ケース1のコスト: (34*1) + (8*2) + (50*3) = 200
ケース2のコスト: (8*1) + (34*2) + (50*2) = 176
同様にケース5のコスト: (50*1) + (34*2) + (8*3) = 142(最小)
アルゴリズム
optCostBst(keys, freq, n)
入力: BSTに挿入するキー、各キーに対応する頻度、キーの総数。
出力: 最適なBSTを構築する際の最小コスト。
Begin
    n × n の cost 行列を定義する
    for i in range 0 to n-1, do
        cost[i, i] := freq[i]
    done

    for length in range 2 to n, do
        for i in range 0 to (n-length+1), do
            j := i + length – 1
            cost[i, j] := ∞
            for r in range i to j, do
                if r > i, then
                    c := cost[i, r-1]
                else
                    c := 0
                if r < j, then
                    c := c + cost[r+1, j]
                c := c + i から j までの頻度の合計
                if c < cost[i, j], then
                    cost[i, j] := c
            done
        done
    done
    return cost[0, n-1]
End
このアルゴリズムでは、区間 [i, j] に含まれる各キー r を根とした場合のコストを順に評価し、その最小値を cost[i][j] に記録していきます。計算量は時間 O(n³)、必要なメモリは O(n²) となります。
C++による実装例
#include <iostream>
using namespace std;

int sum(int freq[], int low, int high) {    //low〜high 範囲の頻度の合計を求める
    int sum = 0;
    for (int k = low; k <=high; k++)
        sum += freq[k];
    return sum;
}

int minCostBST(int keys[], int freq[], int n) {
    int cost[n][n];

    for (int i = 0; i < n; i++)    //キーが1つだけの場合、対角成分に頻度を格納
        cost[i][i] = freq[i];

    for (int length=2; length<=n; length++) {
        for (int i=0; i<=n-length+1; i++) {    //i を 0行目から n-length+1 行目まで動かす
            int j = i+length-1;
            cost[i][j] = INT_MAX;    //初期値として無限大を設定

            for (int r=i; r<=j; r++) {
                //r を部分木の根としたときのコストを求める
                int c = ((r > i)?cost[i][r-1]:0)+((r < j)?cost[r+1][j]:0)+sum(freq, i, j);
                if (c < cost[i][j])
                    cost[i][j] = c;
            }
        }
    }
    return cost[0][n-1];
}

int main() {
    int keys[] = {10, 12, 20};
    int freq[] = {34, 8, 50};
    int n = 3;
    cout << "Cost of Optimal BST is: "<< minCostBST(keys, freq, n);
}
実行結果
Cost of Optimal BST is: 142
この結果から、頻度が最も高いキー 20 を根に近い位置へ配置した木が最適であることがわかります。頻度の高いキーほど浅い階層に配置することで探索コスト全体を抑えられる、というのが最適二分探索木の本質です。
-
データ構造入門:最適二分探索木(Optimal BST)で検索コストを最小化する方法
最適二分探索木とはソートされた順序で整数のキー集合が与えられ、同時に各キーの出現頻度を格納した配列 freq も渡されます。この課題は、これらのデータをもとに二分探索木(BST)を構築し、すべての検索にかかるコストの合計を最小にすることです。検索コストは「キーの深さ × 出現頻度」の総和で表されます。そのため、頻度の高いキーほど根に近い浅い位置へ配置できれば、全体のコストを大きく抑えられます。このような木を最適二分探索木(Optimal BST)と呼びます。部分問題の解を保存し、ボトムアップ方式で問題を解決するために、補助配列 cost[n][n] を作成します。このコスト行列には、動的計画法
-
C#で二分探索(バイナリサーチ)を実装する方法|仕組みと計算量を解説
二分探索とは二分探索(バイナリサーチ)は、ソート済みの配列を対象とした高速な検索アルゴリズムです。探索したい値を配列の中央にある要素と比較し、一致しなかった場合は、その値が存在し得ない側の半分の領域を丸ごと除外します。この操作を残りの半分に対して繰り返すことで、効率よく目的の値を見つけ出します。例えば、下図のような配列から「62」という値を探す場合を考えてみましょう。中央の要素との比較結果から、62が存在するのは右側の領域だけであることが分かるため、左半分は完全に除外され、以降は右半分のみが探索対象となります。二分探索の計算量二分探索における各ケースの計算量は以下の通りです。最悪時間計算量O(