
サーバーレスデータベースのレイテンシー徹底比較:DynamoDB vs FaunaDB vs Upstash
はじめに
本記事では、典型的なWebアプリケーションのユースケースを想定し、3つのサーバーレスデータベース——DynamoDB、FaunaDB、Upstash(Redis)——のレイテンシーを実測データに基づいて比較します。
検証のためにニュースサイトのサンプルを構築し、サイトへの各リクエスト時にデータベース関連のレイテンシーを記録する仕組みを実装しました。実際のサイトとソースコードは公開しているので、興味のある方はぜひ参照してください。
各データベースには、New York Times Archive APIから収集した7,001件の記事(2021年1月分の全記事)を挿入済みです。さらに、各記事に対してランダムなスコアを付与しています。ページがリクエストされるたびに、Worldセクションに属する記事の中からスコア上位10件を各データベースへクエリします。
記事データの読み込みにはサーバーレス関数(AWS Lambda)を使用しており、10件の記事取得にかかるレスポンス時間をLambda関数内で「レイテンシー」として記録します。なお、ここで測定しているのはLambda関数とデータベース間のレイテンシーのみであり、ブラウザとサーバー間のレイテンシーは含まれていない点に注意してください。
また、読み取りリクエストのたびにスコアをランダムに更新することで、動的に変化するリアルタイムデータをシミュレートしています。ただし、この更新処理はレイテンシー計算の対象からは除外しています。
それでは、まずアプリケーションの構成を確認した後、測定結果を見ていきましょう。
検証環境のセットアップ
AWS Lambdaの設定
- リージョン:US-West-1
- メモリ:1024MB
- ランタイム:nodejs14.x
DynamoDBの設定
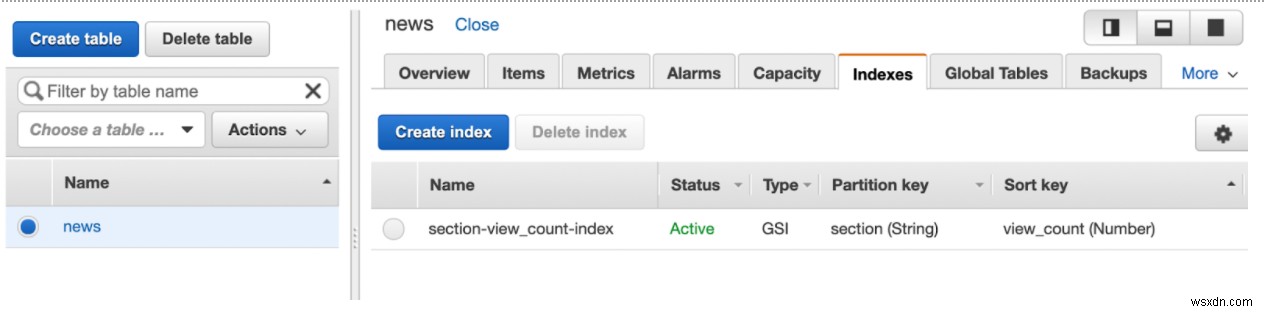
US-West-1リージョンにDynamoDBテーブルを作成しました。読み書きキャパシティはデフォルト値の5ではなく50に設定しています。
インデックスはGSI(グローバルセカンダリインデックス)を使用し、パーティションキーにsection(String)、ソートキーにview_count(Number)を指定しました。
FaunaDBの設定
FaunaDBはグローバルにレプリケーションされるデータベースのため、私の知る限りリージョンを選択する方法はありません。GraphQL APIには何らかのオーバーヘッドがある可能性を考慮し、FQLを採用しました。
以下のように、termsにsection、valuesにrefを持つインデックスを作成しています。パフォーマンス向上を期待して、シリアライズ無効(non-serialized)に設定しました。
CreateIndex({
  name: "section_by_view_count",
  unique: false,
  serialized: false,
  source: Collection("news"),
  terms: [
    { field: ["data", "section"] }
  ],
  values: [
    { field: ["data", "view_count"], reverse: true },
    { field: ["ref"] }
  ]
})
Redis(Upstash)の設定
UpstashでUS-West-1リージョンにStandardタイプのデータベースを作成しました。ニュースカテゴリごとにSorted Setを使用しており、Worldカテゴリの全記事はキーWorldのSorted Setに格納されます。
データベースの初期化
NYTimes APIサイトから7,001件のニュース記事をJSONファイルとしてダウンロードし、そのJSONを読み込んで各データベースにレコードを挿入するNode.jsスクリプトを、データベースごとに作成しました。詳細はinitDynamo.js、initFauna.js、initRedis.jsをご覧ください。
クエリの実装
DynamoDBへのクエリ
DynamoDBへの接続にはAWS SDKを使用しました。レイテンシーを最小化するため、DynamoDBのコネクションを維持(keep-alive)しています。レスポンス時間の計測にはperf_hooksライブラリを使用し、上位10件の記事をクエリする直前に現在時刻を記録し、DynamoDBからレスポンスを受け取った時点でレイテンシーを算出します。その後、記事のスコアをランダムに更新し、レイテンシー値をRedisのSorted Setに挿入しますが、これらの処理はレイテンシー計算の対象外です。以下がコードです。
var AWS = require("aws-sdk");
AWS.config.update({
  region: "us-west-1",
});
const https = require("https");
const agent = new https.Agent({
  keepAlive: true,
  maxSockets: Infinity,
});

AWS.config.update({
  httpOptions: {
    agent,
  },
});

const Redis = require("ioredis");
const { performance } = require("perf_hooks");
const tableName = "news";
var params = {
  TableName: tableName,
  IndexName: "section-view_count-index",
  KeyConditionExpression: "#sect = :section",
  ExpressionAttributeNames: {
    "#sect": "section",
  },
  ExpressionAttributeValues: {
    ":section": process.env.SECTION,
  },
  Limit: 10,
  ScanIndexForward: false,
};
const docClient = new AWS.DynamoDB.DocumentClient();

module.exports.load = (event, context, callback) => {
  let start = performance.now();
  docClient.query(params, (err, result) => {
    if (err) {
      console.error(
        "Unable to scan the table. Error JSON:",
        JSON.stringify(err, null, 2)
      );
    } else {
      // レスポンス受信完了:ここでレイテンシーを確定
      let latency = performance.now() - start;
      let response = {
        statusCode: 200,
        headers: {
          "Access-Control-Allow-Origin": "*",
          "Access-Control-Allow-Credentials": true,
        },
        body: JSON.stringify({
          latency: latency,
          data: result,
        }),
      };
      // リアルタイムの動的データをシミュレートするため、上位10件にランダムスコアを設定
      result.Items.forEach((item) => {
        let view_count = Math.floor(Math.random() * 1000);
        var params2 = {
          TableName: tableName,
          Key: {
            id: item.id,
          },
          UpdateExpression: "set view_count = :r",
          ExpressionAttributeValues: {
            ":r": view_count,
          },
        };
        docClient.update(params2, function (err, data) {
          if (err) {
            console.error(
              "Unable to update item. Error JSON:",
              JSON.stringify(err, null, 2)
            );
          }
        });
      });
      // レイテンシーをヒストグラムに記録
      const client = new Redis(process.env.LATENCY_REDIS_URL);
      client.lpush("histogram-dynamo", latency, (resp) => {
        client.quit();
        callback(null, response);
      });
    }
  });
};
FaunaDBへのクエリ
FaunaDBへの接続とクエリにはfaunadbライブラリを使用しました。その他の部分はDynamoDBのコードとほぼ同じ構成です。レイテンシー最小化のためコネクションを維持し、perf_hooksライブラリでレスポンス時間を計測します。FaunaDBに上位10件の記事を問い合わせる直前に時刻を記録し、レスポンスを受け取った時点でレイテンシーを算出。その後、スコアのランダム更新とレイテンシー値のRedisへの送信を行いますが、これらは計測対象外です。以下がコードです。
const faunadb = require("faunadb");
const Redis = require("ioredis");
const { performance } = require("perf_hooks");
const q = faunadb.query;
const client = new faunadb.Client({
  secret: process.env.FAUNA_SECRET,
  keepAlive: true,
});
const section = process.env.SECTION;

module.exports.load = async (event) => {
  let start = performance.now();
  let ret = await client
    .query(
      // 「select from news where section = 'world' order by view_count limit 10」に相当するFauna API
      q.Map(
        q.Paginate(q.Match(q.Index("section_by_view_count"), section), {
          size: 10,
        }),
        q.Lambda(["view_count", "X"], q.Get(q.Var("X")))
      )
    )
    .catch((err) => console.error("Error: %s", err));
  console.log(ret);
  // レスポンス受信完了:ここでレイテンシーを確定
  let latency = performance.now() - start;
  const rclient = new Redis(process.env.LATENCY_REDIS_URL);
  await rclient.lpush("histogram-fauna", latency);
  await rclient.quit();

  let result = [];
  for (let i = 0; i < ret.data.length; i++) {
    result.push(ret.data[i].data);
  }

  // リアルタイムの動的データをシミュレートするため、上位10件に非同期でランダムスコアを設定
  ret.data.forEach((item) => {
    let view_count = Math.floor(Math.random() * 1000);
    client
      .query(
        q.Update(q.Ref(q.Collection("news"), item["ref"].id), {
          data: { view_count },
        })
      )
      .catch((err) => console.error("Error: %s", err));
  });

  return {
    statusCode: 200,
    headers: {
      "Access-Control-Allow-Origin": "*",
      "Access-Control-Allow-Credentials": true,
    },
    body: JSON.stringify({
      latency: latency,
      data: {
        Items: result,
      },
    }),
  };
};
Redisへのクエリ
Upstash上のRedisへの接続と読み取りにはioredisライブラリを使用しました。Sorted Setからのデータ取得にはZREVRANGEコマンドを使っています。レイテンシーを最小化するため、Redisクライアントを関数の外側で生成し、コネクションを再利用する形にしました。DynamoDBやFaunaDBの場合と同様に、スコアの更新と、ヒストグラム集計用のもう一つのRedis DBへのレイテンシー送信を行います。以下がコードです。
const Redis = require("ioredis");
const { performance } = require("perf_hooks");
const client = new Redis(process.env.REDIS_URL);
module.exports.load = async (event) => {
  let section = process.env.SECTION;
  let start = performance.now();
  let data = await client.zrevrange(section, 0, 9);
  let items = [];
  for (let i = 0; i < data.length; i++) {
    items.push(JSON.parse(data[i]));
  }
  // レスポンス受信完了:ここでレイテンシーを確定
  let latency = performance.now() - start;
  // リアルタイムの動的データをシミュレートするため、上位10件にランダムスコアを設定
  for (let i = 0; i < data.length; i++) {
    let view_count = Math.floor(Math.random() * 1000);
    await client.zadd(section, view_count, data[i]);
  }
  // await client.quit();
  // レイテンシーをヒストグラムに記録
  const client2 = new Redis(process.env.LATENCY_REDIS_URL);
  await client2.lpush("histogram-redis", latency);
  await client2.quit();
  return {
    statusCode: 200,
    headers: {
      "Access-Control-Allow-Origin": "*",
      "Access-Control-Allow-Credentials": true,
    },
    body: JSON.stringify({
      latency: latency,
      data: {
        Items: items,
      },
    }),
  };
};
ヒストグラムの計算
ヒストグラムの計算にはhdr-histogram-jsライブラリを使用しました。これはGil Tene氏によるhdr-histogramライブラリのJavaScript実装です。以下は、レイテンシー値を受け取ってヒストグラムを算出するLambda関数のコードです。
const Redis = require("ioredis");
const hdr = require("hdr-histogram-js");

module.exports.load = async (event) => {
  const client = new Redis(process.env.LATENCY_REDIS_URL);
  let dataRedis = await client.lrange("histogram-redis", 0, 10000);
  let dataDynamo = await client.lrange("histogram-dynamo", 0, 10000);
  let dataFauna = await client.lrange("histogram-fauna", 0, 10000);
  const hredis = hdr.build();
  const hdynamo = hdr.build();
  const hfauna = hdr.build();
  dataRedis.forEach((item) => {
    hredis.recordValue(item);
  });
  dataDynamo.forEach((item) => {
    hdynamo.recordValue(item);
  });
  dataFauna.forEach((item) => {
    hfauna.recordValue(item);
  });
  await client.quit();
  return {
    statusCode: 200,
    headers: {
      "Access-Control-Allow-Origin": "*",
      "Access-Control-Allow-Credentials": true,
    },
    body: JSON.stringify(
      {
        redis_min: hredis.minNonZeroValue,
        dynamo_min: hdynamo.minNonZeroValue,
        fauna_min: hfauna.minNonZeroValue,
        redis_mean: hredis.mean,
        dynamo_mean: hdynamo.mean,
        fauna_mean: hfauna.mean,
        redis_histogram: hredis,
        dynamo_histogram: hdynamo,
        fauna_histogram: hfauna,
      },
      null,
      2
    ),
  };
};
測定結果
最新の結果は検証用サイトで確認できます。最新のヒストグラムデータにもアクセス可能です。サイトが稼働している限り、データの収集とヒストグラムの更新を継続していきます。
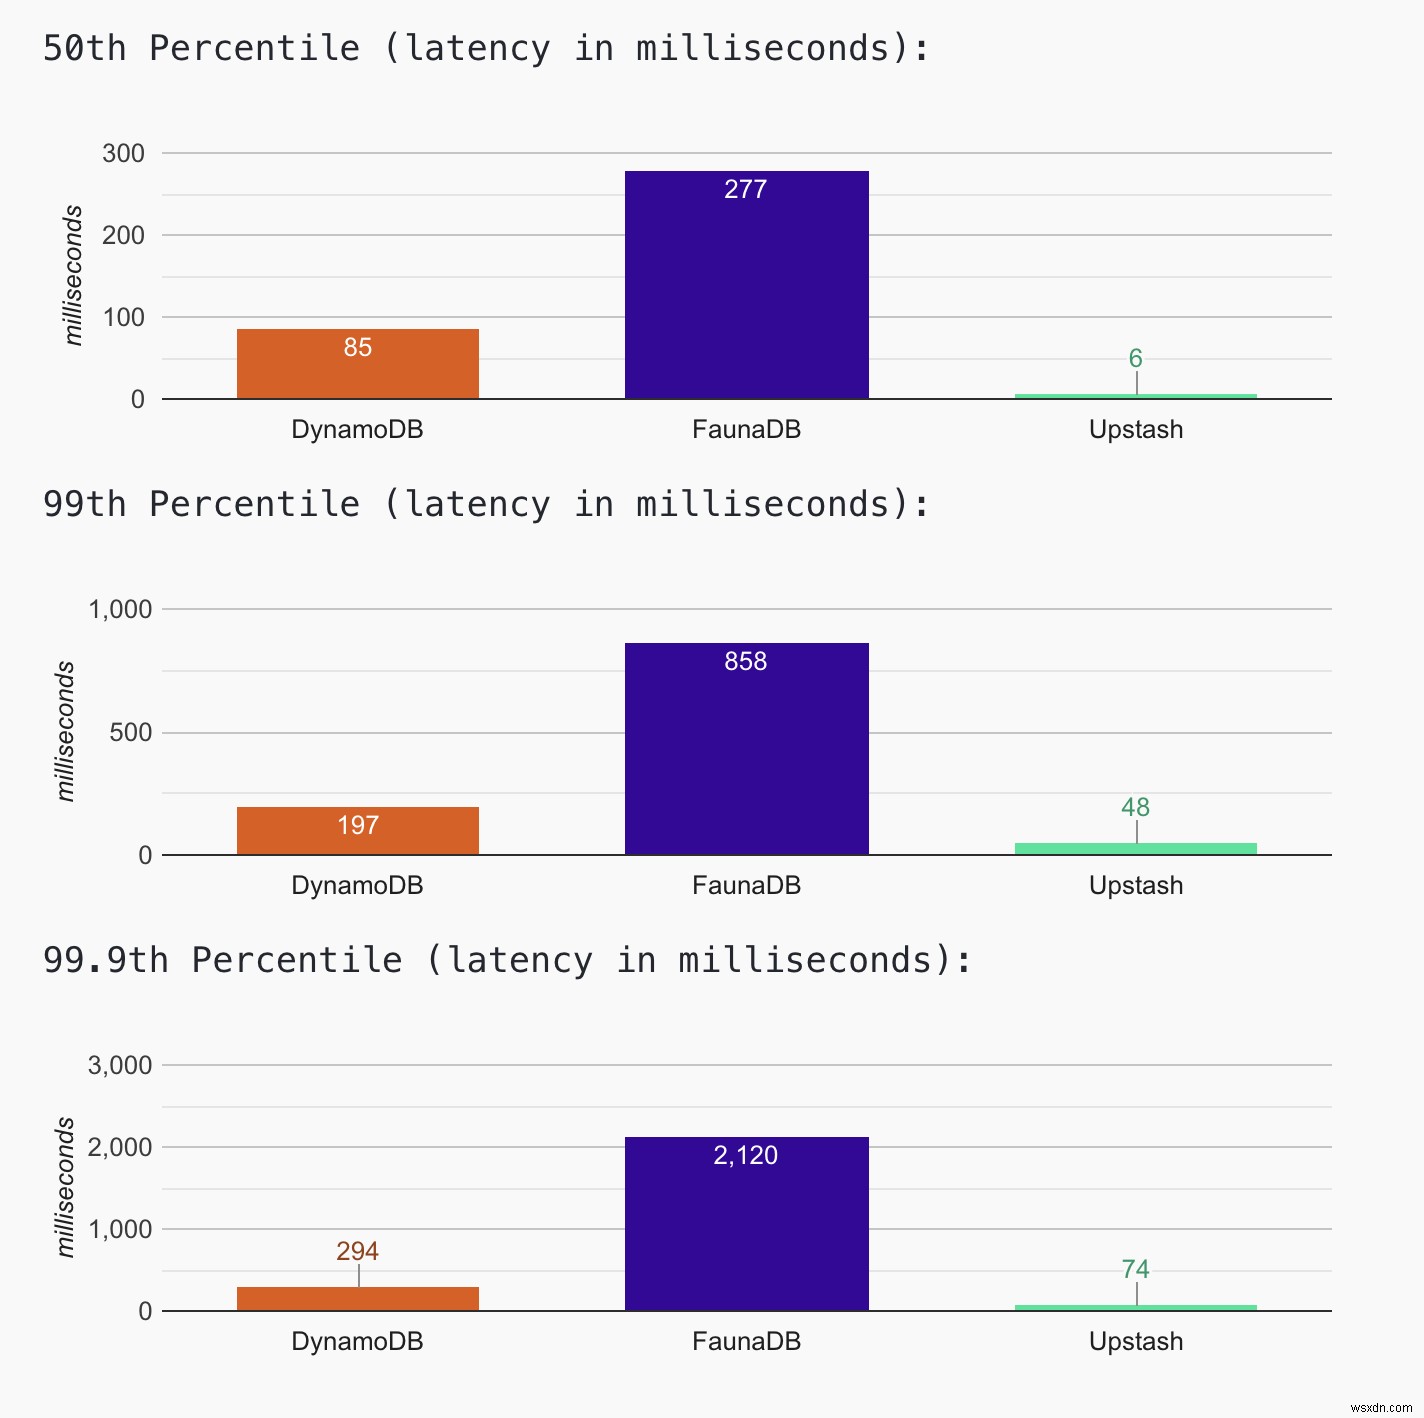
2021年4月12日時点の結果では、Upstashが最も低いレイテンシー(99パーセンタイルで約50ms)を示し、FaunaDBが最も高いレイテンシー(同約900ms)となりました。DynamoDBは同約200msという結果です。
コールドスタートの影響
今回はクエリ部分のみを計測対象としていますが、それでもコールドスタートの影響は避けられません。クライアント接続を再利用する形でコードを最適化しており、Lambdaコンテナがホットな状態で稼働している間はこの恩恵を受けられます。しかし、AWSがコンテナを破棄した場合(コールドスタート発生時)、コードはクライアントを再作成する必要があり、これがオーバーヘッドになります。検証用サイトでページを更新してみると、Upstashでは約1ms、DynamoDBでは約7msまでレイテンシーが低下することが確認できます。
なぜFaunaDBは遅いのか(このベンチマークにおいて)
FaunaDBのステータスページでは数百ミリ秒台のレイテンシーが公表されているため、私の設定に大きな欠陥があるとは考えていません。このレイテンシー差の背景には、次の2つの要因があると推測されます。
強い整合性(Strong Consistency): デフォルトでは、DynamoDBとUpstashはどちらも読み取り時に結果整合性(eventual consistency)を提供します。一方FaunaDBは、Calvinに基づく強い整合性と分離性を提供しており、強い整合性にはどうしてもパフォーマンス上のオーバーヘッドが伴います。
グローバルレプリケーション: UpstashとDynamoDBでは、データベースとLambda関数を同一のAWSリージョンに配置できます。しかしFaunaDBでは、データが世界中にレプリケートされるため、リージョンを選択するオプションがありません。データベースクライアントが世界中に分散しているならこれは利点になりますが、バックエンドを特定のリージョンにデプロイしている場合は、余分なレイテンシーが発生してしまいます。
Redisはサブミリ秒のはずでは?なぜそうならないのか
AWS Lambda関数内で新しいRedis接続を作成すると、顕著なオーバーヘッドが発生します。このアプリケーションは安定したトラフィックを受けていないため、多くの場合AWS Lambdaは接続を再作成(コールドスタート)します。その結果、ヒストグラム内の大多数のレイテンシー値には接続作成時間が含まれています。15秒ごとにサイトをフェッチするジョブを実行したところ、Upstashのレイテンシーは約1msまで低下しました。ページを更新すれば同様の効果を確認できます。サーバーレスアプリケーションを低レイテンシー向けに最適化する方法については、弊社ブログ記事も参考にしてください。
今後の予定
Upstashでは、データを複数のアベイラビリティゾーンにレプリケートするPremiumプランを近日中にリリース予定です。ゾーンレプリケーションの効果を検証できるよう、この結果も比較に追加する予定です。
フィードバックがあれば、TwitterまたはDiscordでお知らせください。
アップデート
このベンチマークおよびFaunaのパフォーマンスについて、HackerNewsで活発な議論が行われました。寄せられた提案を反映してFaunaDBアプリケーションを再起動したため、ヒストグラム内のFaunaDBのレコード数が他より少なくなっています。
-
サーバーレス・エッジ時代のグローバルデータベース──Upstash Global Database徹底解説
近年、アプリケーションのデプロイにおいて、サーバーレスアーキテクチャとエッジコンピューティングが急速に普及しています。しかし、サーバーレス関数やエッジ関数の中でアプリケーションの状態やデータを保存するのは、まったく別の話です。データベースへの接続管理、複数拠点からの高速なデータアクセスの実現など、乗り越えるべき課題が数多くあります。サーバーレスアクセスに対応したデータベースサービスは限られており、さらにエッジ関数にも適したものとなると、ごくわずかしか存在しません(詳細な分析はこちらの記事をご覧ください)。Upstashでは、創業当初から低レイテンシかつリクエスト単位の従量課金モデルを採用したサ
-
サーバーレスデータベース徹底比較:DynamoDB vs Firestore vs MongoDB vs Cassandra vs Redis vs FaunaDB
はじめに 本記事は、2021年4月に公開したブログ記事の続編です。 私たちは、一般的なWebユースケースとサーバーレス関数を用いて、主要なサーバーレスデータベースのパフォーマンスを比較するサンプルアプリケーションを構築しました。比較対象は、DynamoDB、MongoDB(Atlas)、Firestore、Cassandra(Datastax Astra)、FaunaDB、Redis(Upstash)の6つです。 アプリケーションおよびソースコードは公開しているので、ぜひご確認ください。 測定内容と方法 今回比較したのは、各データベースで上位10件のニュース記事を取得する際のレイテンシです。