
DynomiteデータベースをRedis Enterprise Active-Activeデータベースに移行すべき理由
2009年の誕生以来、Redis OSS(オープンソース版)は非常に活発なオープンソースコミュニティを形成してきました。その周辺には数多くのツールやユーティリティが開発されており、非分散型データストア向けのピアツーピア地理分散レイヤーであるDynomiteもその一つです。
DynomiteはNetflixのエンジニアチームによって開発され、オープンソースとして公開されました。特定のニーズに対する優れたソリューションを提供してきましたが、ここ数年は効果的なメンテナンスが行われていません。さらに、DynomiteによるRedis OSSインスタンスの分散モデルのせいで、Redis OSSの一部機能、コマンド、データ型(Pub/Sub、Streamsなど)が利用不可になったり、制限されたりしています。
こうした背景から、当社では組織のDynomiteデータベースからRedis Enterpriseクラスターへの移行を支援してきました。
DynomiteとRedis Enterpriseのアーキテクチャ比較
まず、DynomiteとRedis Enterpriseそれぞれのアーキテクチャを簡単に説明します。
Dynomite
一般的なDynomiteクラスターは以下のような特徴を持ちます:
- 複数のデータセンターにまたがる構成
- 1つのデータセンターはラックのグループで構成
- ラックはノードのグループで、各ラックがデータセット全体を保持し、そのラック内の複数ノードにパーティション分割
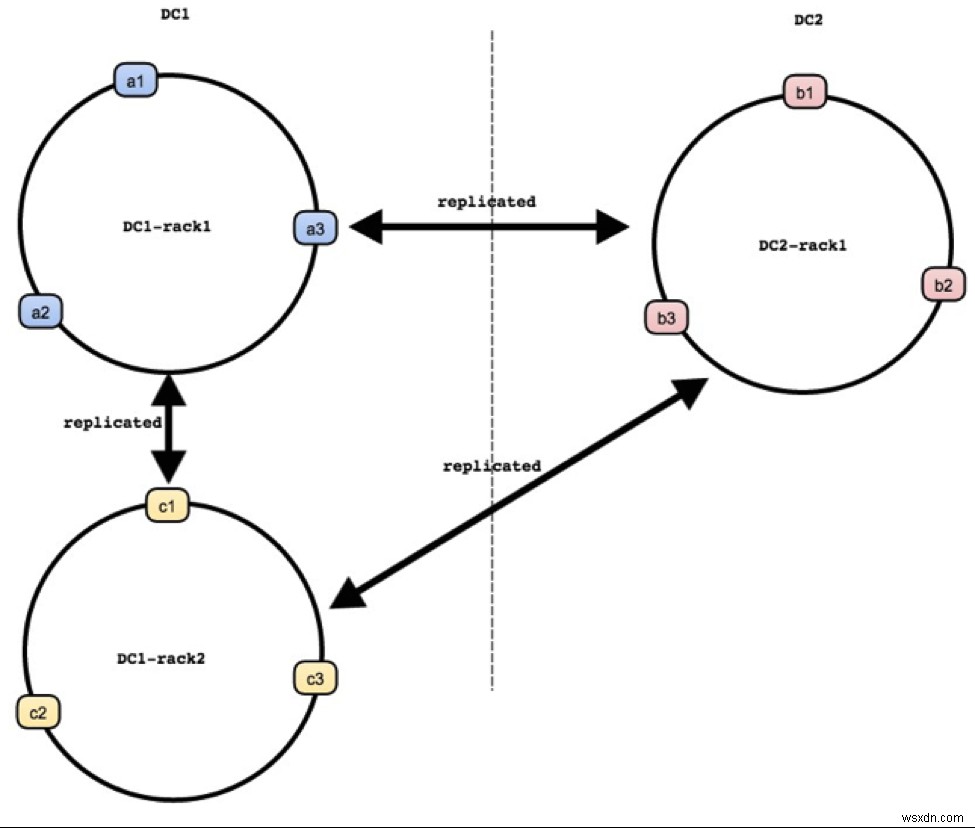
Dynomiteはピアツーピア分散レイヤーであるため、クライアントはDynomiteクラスター内の任意のノードに書き込みトラフィックを送信できます。対象データを担当するノードであれば、そのローカルRedis OSSサーバープロセスにデータが書き込まれ、その後、全データセンターの他のラックに非同期でレプリケートされます。担当ノードでない場合、そのノードはコーディネーターとして機能し、同じラック内のデータ担当ノードに書き込みを転送します。さらに、他のラックおよびデータセンターの対応するノードにも書き込みがレプリケートされます。
Redis Enterprise
Redis Enterpriseクラスターもデータを異なるRedisインスタンス(シャード)に分散しますが、主に2つの重要な違いがあります:
- 1つのノードに複数のシャードを配置可能だが、高可用性のためにプライマリとレプリカは同一ノードに配置されない
- 各プライマリシャードに対してレプリカは1つのみ。クライアントはプライマリシャードでデータ操作を行い、レプリカはプライマリ障害時の高可用性確保のために存在
Redis Enterpriseクラスターのもう一つの重要な構成要素は「管理パス」と呼ばれ、クラスターマネージャー、プロキシ、REST API/UIで構成されます。クラスターマネージャーはクラスターのオーケストレーション、データベースシャードの高可用性ノードへの配置、障害検知を担当します。プロキシはRedis Enterpriseのクラスタートポロジーをアプリケーションから隠蔽し、クラスター内の各データベースに対して単一の不変エンドポイントを提供します。また、コマンドの多重化とパイプライン処理により、クライアント接続のスケーリングも支援します。
以下は一般的なRedis Enterpriseクラスターの構成図です:
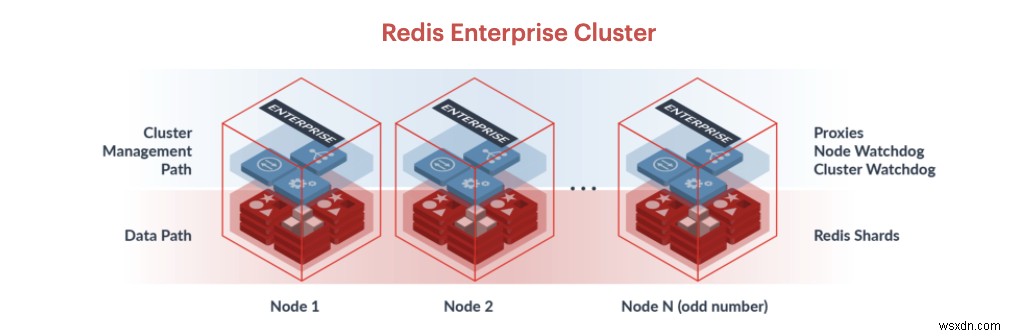
Redis EnterpriseのActive-Active機能を使用すると、複数のクラスターにまたがるグローバルデータベースを作成できます。これらのクラスターは通常、世界中の異なるデータセンターに配置されます。Active-Activeデータベースに書き込むアプリケーションはローカルインスタンスのエンドポイントに接続します。アプリケーションがローカルインスタンスに行ったすべての書き込みは、強力な結果整合性を持って他のすべてのインスタンスにレプリケートされます。
Active-Activeレプリケーションは地理分散ソリューションとして多くの利点を提供します。その一つが、シンプルなRedis Enterpriseデータ型から複雑なデータ型まで、シームレスな競合解決が可能な点です。これについては後述します。
DynomiteとRedis Enterpriseのトポロジーを理解したところで、これらが開発者とDevOpsにとって何を意味するかを見ていきましょう。
DynomiteかRedis Enterpriseか:開発者にとっての違い
Dynomiteが積極的にメンテナンスされていないこと以外にも、開発者の観点から組織がRedis Enterpriseへ移行すべき主な理由は3つあります:
- Dynomite使用時はRedisの機能が制限され、より複雑になる
- Dynomiteには地理分散書き込み競合を効果的に処理する仕組みがない
- Redisから受けられるサポート
最初の2つについて詳しく見ていきます。
制限され複雑なRedis OSS
ご存知の通り、Redis OSSは単なるキー・バリューストアではありません。文字列キーを文字列値に関連付けるだけでなく、リスト、セット、ハッシュ、ストリームなど、さまざまな種類の値をサポートするデータ構造サーバーです。これらをRedis OSSの「コアデータ型」と呼びます。
また、Redis OSSは「モジュール」と呼ばれる動的ライブラリによって拡張可能です。モジュールを使用すると、コア内部で実行可能な機能と同様の新しいRedisコマンドを迅速に実装できます。代表的なモジュールには、クエリ、セカンダリインデックス、全文検索を提供するRediSearchや、Redis OSSを強力なドキュメントストアに変えるRedisJSONがあります。
前述の通り、一部のRedis OSSコマンドとデータ型はDynomiteによって利用不可または制限されます。以下は主な比較です(網羅的ではありません):
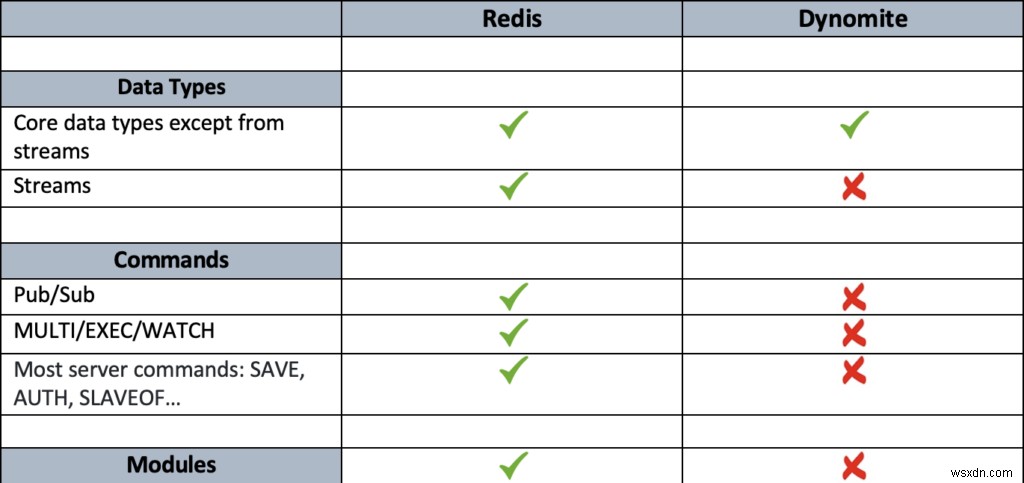
Dynomiteでサポートされる/されないコマンドの完全なリストはこちらで確認できます。
一方、Redis OSSと並行してメンテナンスされているRedis Enterpriseでは、モジュールを使用したマルチモデル操作が可能で、コアRedis OSSデータ構造を完全にプログラマブルかつ分散的に実行できます。
競合解決機能の不在
DynomiteはAPシステムであり、3つの整合性オプションを提供します。どのオプションを選択しても、Dynomiteは非同期書き込み競合を「Last Write Wins(最終書き込み勝利)」戦略で解決する点に注意が必要です。これは、特に地理分散書き込みの文脈では、無関係なタイムスタンプによって更新が失われる原因となり得ます。
一方、Redis EnterpriseのActive-Activeアーキテクチャは、CRDT(Conflict-Free Replicated Data Types:競合フリー複製データ型)と呼ばれるRedis OSSコマンドとデータ型の代替実装に基づいています。CRDTはベクトルクロックを使用してイベントの順序を管理します。任意の2つのレプリカが同じ更新セットを受信した場合、数学的に妥当なルールを採用することで、決定論的に同じ状態に収束することを保証します。さらに、因果整合性を有効化することも可能です。
したがってRedis Enterpriseでは:
- 同時書き込みの結果がルールセットに基づいて予測可能
- アプリケーションは同時書き込みや競合解決を意識する必要なし
- データセットは最終的に単一の一貫した状態に収束
実装されているルールと競合解決の例については、こちらで確認できます。
DynomiteかRedis Enterpriseか:DevOpsにとっての違い
次に、以下の観点からDynomiteとRedis EnterpriseをDevOpsの視点で比較します:
- 高可用性
- スケーラビリティ
- デプロイ容易性
高可用性
Dynomiteラック内でノード障害が発生すると、そのラックへの読み書きが不可能になります。つまり、ローカルで書き込むアプリケーションは、別のラックへのフェイルオーバーを自力で処理する必要があります。Javaで開発されている場合、NetflixのDynoクライアントがローカルDynomiteノード障害時のリモートラックへのフェイルオーバーを処理できます。
さらに、障害ノードが復旧した際、障害中にリモートラックで書き込まれたデータがそのノードに欠落している状態になります。AWSオートスケーリンググループ内でデプロイしている場合、NetflixのDynomite Managerを使用して、AWSオートスケーリンググループ内でのノード置換とウォームアップを自動化できます。
ではRedis Enterpriseの高可用性はどうでしょうか?
ノード障害時、そのノード上のすべてのプライマリシャードに対して数秒以内のフェイルオーバーが発生し、レプリカがプライマリに昇格します。この自動フェイルオーバー機構により、データ提供が最小限の中断で継続されます。
この仕組みにより:
- Redis Enterpriseプロキシがデータベースの単一エンドポイント(フェイルオーバー時も不変)を維持するため、アプリケーションの再設定は不要
- 「replica_ha」オプションにより、レプリカがプライマリに昇格すると、利用可能な他のノード上に自動的に新しい同期済みレプリカシャードが作成される
これらのメカニズムにより、Redis Enterpriseは99.99%の稼働率を、Active-Active展開では99.999%の稼働率を保証します。
スケーラビリティ
Dynomiteでは、レイテンシの面から見ても良好なパフォーマンスを維持しながらRedis OSSをスケールできます。ベンチマーク結果で確認できますが、Dynomiteを使用している方ならすでにご存知でしょう。
スケーラビリティの観点での主な違いは以下の通りです:
- 管理容易性
- 標準搭載の接続管理
- リソース最適化
管理容易性
AWSオートスケーリンググループ内でDynomite Managerを使用していない場合、実行中のDynomiteラックにホストを追加するには通常、以下が必要です:
- Java Dynoクライアントを使用した「二重書き込み」手法の活用。アプリケーションが旧/小規模クラスターと新/拡張クラスターの両方に書き込み、数日後にトラフィックを新クラスターのみにルーティングしてアクティブ化
- 旧/小規模クラスターから新/拡張クラスターへのデータベース移行
一方、Redis Enterpriseでは:
- スケールアップ: クラスターにノードを追加せずにデータベースにシャードを追加可能。クラスターに十分な未使用リソースがある場合に有効。1ノード ≠ 1Redisインスタンスであることを思い出してください。データベースのリシャーディングは、Redis Enterprise UIから数クリックで、またはREST APIを活用して実行可能。ダウンタイムやサービス中断なしで実行され、データベースのエンドポイントが変更されないためアプリケーションからは透過的
- スケールアウト: クラスターにノードを追加。データベースにシャードを追加するためにより多くの物理リソースが必要な場合に有効。Redis Enterprise Cloud(フルマネージドDBaaS)では、組織はこのステップを心配する必要がありません。Redisがインフラとリソースのプロビジョニングおよび管理を代行します。詳細は本記事の「デプロイオプション」を参照
数年前にRedisが実施したベンチマークでは、Redis Enterpriseが40のAWSインスタンス上で、サブミリ秒レイテンシで2億ops/sec以上を実現した記録があります。
接続管理
Redisにおける接続管理といえば、JedisやLettuceなどのRedisクライアントがいかに接続プーリングとパイプライン処理を扱うかがまず思い浮かびます。Netflixも例外ではなく、自社のDynoクライアントでこれらの機能を実装していました。
Redis Enterpriseではこれらの機能が標準で提供されます。プロキシ自体がクラスター内のシャードへの永続接続を確立し、それらをクライアントで共有します。また、シャードへの複数の永続接続上でリクエストをスケジューリングし、多重化とパイプライン処理をRedis側で行うことでパフォーマンスを最適化します。
さらに、プロキシはマルチスレッドで動作し、クライアント接続のバーストに自動的にスケール対応します。
リソース最適化
まず、Redis Enterpriseクラスター内では1台のマシン ≠ 1つのRedisインスタンスであり、各プライマリシャードは最大1つのレプリカしか持てないことを思い出してください。
次に、Redis Enterpriseはマルチテナント対応です。つまり、1つのRedis Enterpriseクラスターで数百の完全に分離されたデータベースを提供できます。Dynomiteで同等のことを実現するのは容易ではありません。Redis Enterpriseのマルチテナント機能はマルチモデル機能と相性が良く、マイクロサービスの文脈では、各々が独自のレプリケーション、スケーリング、永続化、モジュール設定を持つ、目的に最適化されたさまざまなデータベースを1組のノード上で運用することが可能です。
最後に、Redis Enterpriseには「Redis on Flash(RoF)」機能があります。RoFにより、データベースがRAMと専用フラッシュメモリ(SSD/NVMe)の両方を使用できるようになり、オールRAMデータベースと比較して70%以上のコスト削減で、RAM並みのレイテンシとパフォーマンスを維持しながら、はるかに大規模なデータセットを扱えます。
デプロイオプション
Dynomiteはコンテナ、またはUbuntu、RHEL、CentOSを実行するマシンにデプロイ可能です。デプロイは常にセルフマネージドであり、インフラとリソースを自前で用意し、クラスターを管理する必要があります。さらに前述の通り、Dynomite Managerの機能を活用するには、DynomiteをAWSオートスケーリンググループ内にデプロイする必要があります。
一方、Redis Enterpriseには多数のデプロイオプションがあり、大きく2つのグループに分類できます:
- セルフマネージドソリューション: Redis Enterpriseソフトウェアを自社でダウンロード、インストール、デプロイ。Linuxインストーラー(複数ディストリビューション対応)、Amazon Machine Image(AMI)、Dockerコンテナ、Kubernetes、Red Hat OpenShift、Google Kubernetes Engine(GKE)、Azure Kubernetes Service(AKS)、Amazon Elastic Kubernetes Service(EKS)など、豊富な選択肢があります。
- マネージドソリューション: Redis Enterprise Cloudは、3大パブリッククラウドプラットフォーム(Google Cloud、AWS、Azure)上でフルマネージドクラウドサービス(DBaaS)として提供されます。Redisが専用環境をホストし、必要なリソースを用意するため、ユーザーはプライベート/パブリックエンドポイントを持つデータベースを作成し、アプリケーションから利用できます。
-
Nuxt 3とサーバーレスRedis(Upstash)で始めるページ訪問カウント実装
Nuxt 3とサーバーレスRedis(Upstash)で始めるページ訪問カウント実装 アプリケーションの利用状況を追跡したり、リソース利用を制限したり、キャッシュからデータを取得してパフォーマンスを向上させたりする必要がある場合、Redisがその答えとなります。Redisはインメモリのキー・バリュー型データベースであり、オープンソースで「Remote Dictionary Server」の略称です。 この記事では、サーバーレスRedisサービスであるUpstashと、Vue SSRフレームワークの最新ベータ版であるNuxt 3を組み合わせた基本的なアプリケーション構築を通じて、Redisの基礎
-
Redis MOVEコマンドの使い方 – キーを別のデータベースへ移動する方法
このチュートリアルでは、Redisデータストア上でキーをあるデータベースから別のデータベースへ移動する方法を解説します。キーの移動には、redis-cliで使用できるMOVEコマンドを利用します。 MOVEコマンドは、現在選択されているデータベース(ソース)から指定したキーを削除し、そのキーを移動先(デスティネーション)のデータベースに挿入するために使用されます。なお、以下の場合は操作が実行されず、戻り値として0が返されます。 指定したキーがソースデータベースに存在しない場合 同じ名前のキーがすでに移動先のデータベースに存在する場合 構文 Redis MOVEコマンドの基本構文は以下のとお