
RediSearch 2.0登場:2.4倍の高速化を実現した新アーキテクチャの全貌
Redis向けのリアルタイムセカンダリインデックスであり、フルテキスト検索機能を備えたRediSearchは、最も成熟した多機能なRedisモジュールの一つです。その人気は日々高まっており、ここ数ヶ月でRediSearchのDockerプル数は500%も急増しました。急速に拡大するユーザーベースからは、リアルタイム在庫管理からエフェメラルサーチまで、多彩で興味深いユースケースが生まれています。
この勢いをさらに加速させるべく、私たちはRediSearch 2.0のパブリックプレビューを発表します。RediSearch 2.0は、開発者体験の向上と、これまでで最もスケーラブルなバージョンとなることを目標に設計されました。RedisのActive-Active地理分散技術をサポートし、ダウンタイムなしでスケール可能であるほか、Redis on Flashへの対応(現在プライベートプレビュー中)も含まれています。これらの目標をパフォーマンスを損なうことなく達成するため、RediSearch 2.0のためにまったく新しいアーキテクチャを作り上げました。その結果、RediSearch 2.0はRediSearch 1.6比で2.4倍の速度を実現しています。
RediSearch 2.0の新アーキテクチャの内部
Redisデータベース内にリッチなクエリ・集計エンジンを持つことで、キャッシュ用途にとどまらない幅広い新しいユースケースが可能になります。RediSearchを使えば、複雑なクエリでデータへアクセスする必要がある場面でも、Redisをプライマリデータベースとして利用できます。さらに、Redisならではの世界最高レベルの速度、信頼性、スケーラビリティはそのまま維持され、データの更新やインデックス作成のためにコードに複雑さを追加する必要もありません。
RediSearch 2.0では、インデックスとデータを同期させる仕組みを再設計しました。従来のようにFT.ADDコマンドを使ってインデックス経由でデータを書き込むのではなく、RediSearchがハッシュに書き込まれたデータを追跡し、同期的にインデックスを作成する方式に変わっています。この再設計に伴うAPIの変更点については、RediSearch 2.0が最初のマイルストーンに到達した際の以前の記事で詳しく解説しました。
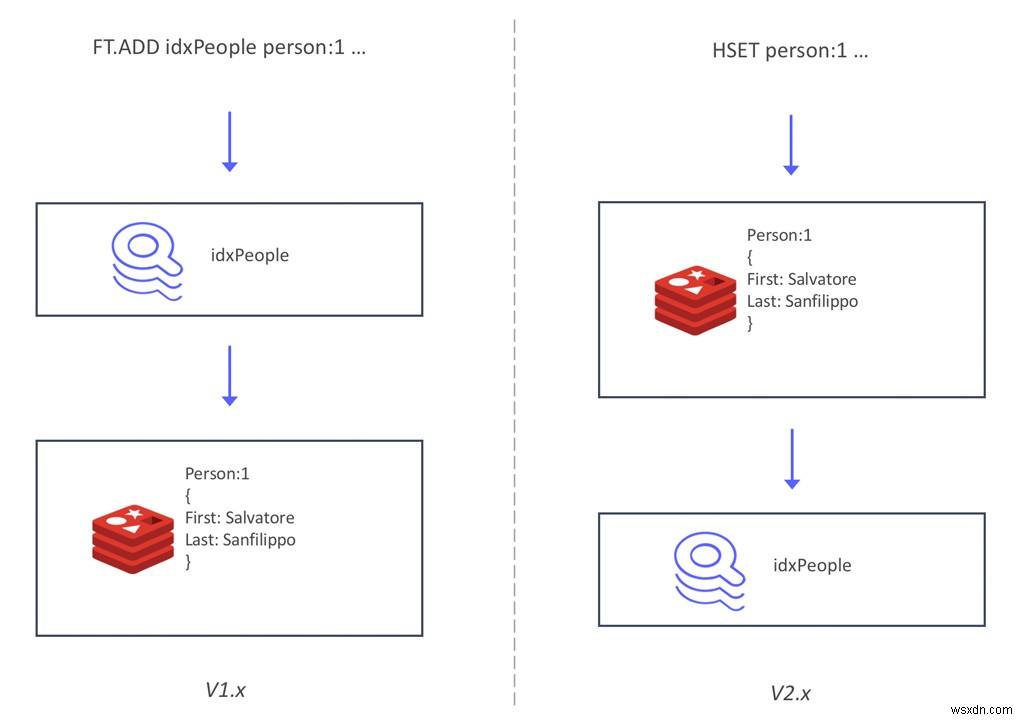
この新アーキテクチャには、主に2つの大きなメリットがあります。
1つ目は、既存データの上にセカンダリインデックスを作成するのがかつてないほど簡単になったことです。既存のRedisデータベースにRediSearchを追加し、インデックスを作成してすぐにクエリを実行できます。データの移行や、インデックスへのデータ登録用の新しいコマンドの使用は一切不要です。これにより、RediSearch初心者の学習曲線が大きく緩やかになり、既存のRedisデータベースに対して、再起動すら必要とせずにインデックスを作成できるようになりました。
さらに、データのインデックス方法を刷新するとともに、インデックスをキースペースの外に移動させました。これにより、競合のないレプリケートデータ型(CRDT)に基づくRedis EnterpriseのActive-Active技術が実現可能になります。2つの転置インデックスを競合なしにマージすることは困難ですが、Redisにはハッシュについて実績のあるCRDT実装がすでに存在します。つまり、この新アーキテクチャの2つ目の大きなメリットは、RediSearch 2.0をさらにスケーラブルにしたことです。RediSearchがハッシュを追跡し、インデックスがキースペース外に移されたことで、Active-Activeの地理分散データベース上でRediSearchを実行できるようになりました。
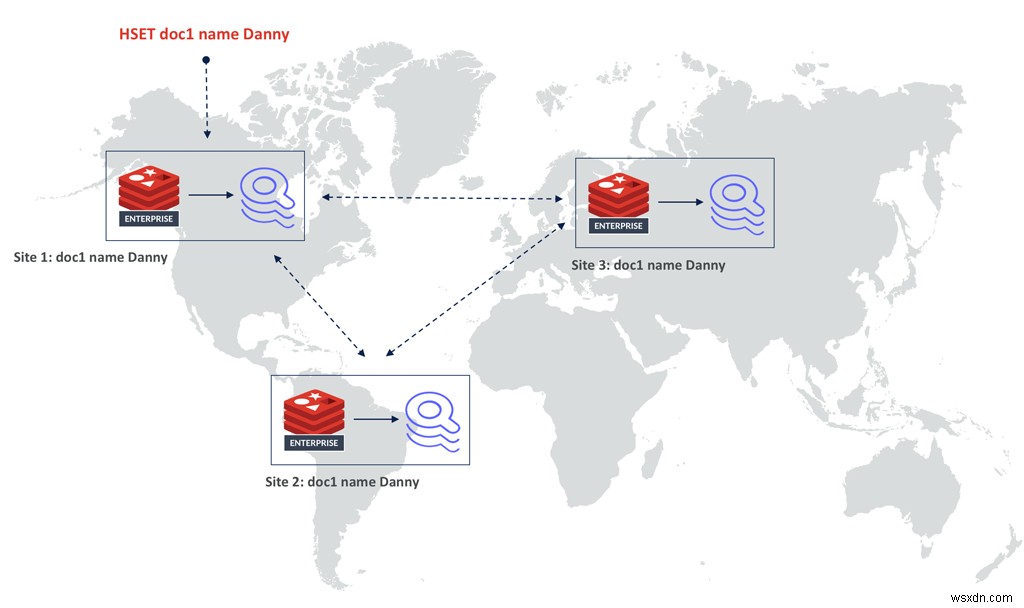
ドキュメントは、強い結果整合性(strongly eventual consistency)のモデルに基づいて、レプリケーションセット内のすべてのデータベースに複製されます。各レプリカでは、RediSearchがハッシュに対するすべての更新を単純に追跡するため、すべてのインデックスも同様に強い結果整合性を保ちます。
オープンソースRedis向けOSSクラスタ対応
スケーラビリティの向上をRedis Enterpriseユーザーだけに限定したくなかったため、オープンソースのRedisクラスタAPIを使用して、単一のインデックスを複数シャードにまたがってスケールさせる機能を追加しました。従来、単一のRediSearchインデックスとそのドキュメントは、1つのシャード上に置かれる必要がありました。これは、オープンソース版Redisにおけるデータセットサイズとスループットが、単一のRedisプロセスが処理できる範囲に制限されることを意味します。Redis Enterpriseでは、クラスタ化されたデータベース内にドキュメントを分散配置し、クエリ時に結果を集約することが可能でした。このファンアウトと集約を担うのは「コーディネーター」と呼ばれるコンポーネントで、現在ではRedis Source Available Licenseの下で一般公開されており、オープンソースのRedisクラスタでもRedis Enterpriseと同様に動作します。その結果、RediSearch史上最もスケーラブルなバージョンが誕生しました。
数字で見るパフォーマンス
RediSearch 2.0の取り込み(インジェスト)性能を評価するため、フルテキスト検索ベンチマーク(FTSB)スイートに、公開されているNYCタクシーデータセットを追加しました。このデータセットは、テキスト、タグ、地理情報、数値といった豊富なデータ型と大量のドキュメントを含むことから、業界全体で広く利用されています。
このベンチマークは書き込み性能に焦点を当てており、ニューヨーク市のイエローキャブの乗車記録データを使用しています。具体的には2015年1月のデータセットを採用し、平均500バイトのドキュメントを1,200万件以上ロードします。ベンチマークの詳細な仕様については、GitHub上のFTSBを参照してください。
すべてのベンチマークは、自社のベンチマークテスト基盤を通じてプロビジョニングされたAmazon Web Servicesのインスタンス上で実行しました。テストは15シャード構成の3ノードクラスタで、RediSearch Enterpriseのバージョン1.6と2.0を用いて実施しています。ベンチマーククライアントと、RediSearchを有効化したデータベースを構成する3ノードは、それぞれ別個のc5.9xlargeインスタンス上で稼働しました。
RediSearch 2.0はRedisのハッシュ変更を追跡して自動的にインデックスを作成できるため、FT.ADDコマンドとHSETコマンドの両方のバリアントをベンチマークに追加しました。アップグレードを容易にするため、非推奨となったFT.ADDコマンドはRediSearch 2.0においてHSETコマンドへ再マッピングされています。以下の2つのグラフは、RediSearch 1.6と2.0それぞれの全体的な取り込みレートとレイテンシを示したもので、いずれもサブミリ秒のレイテンシを維持しています。
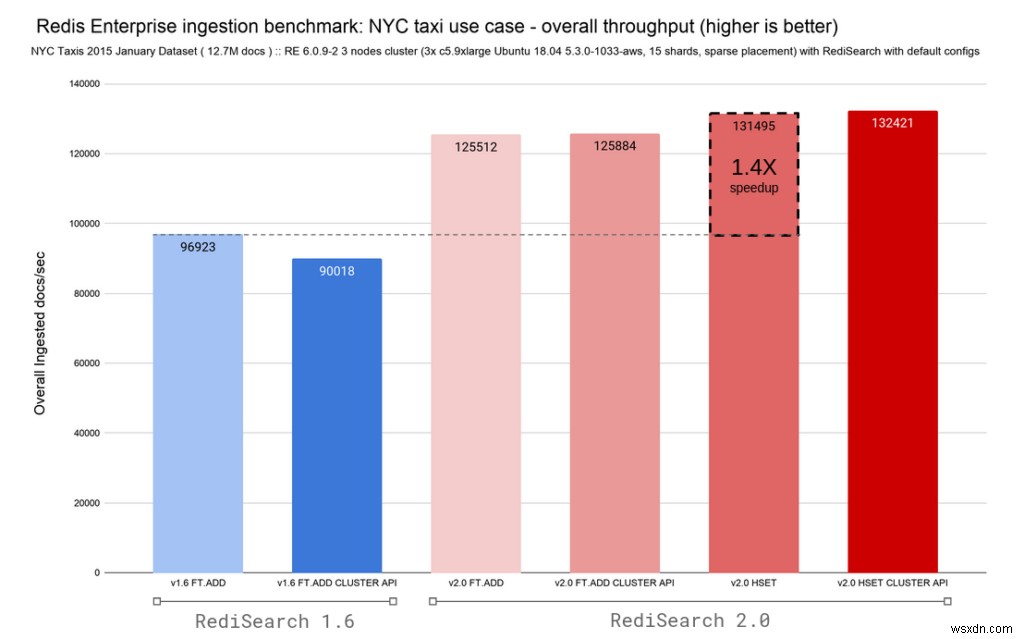
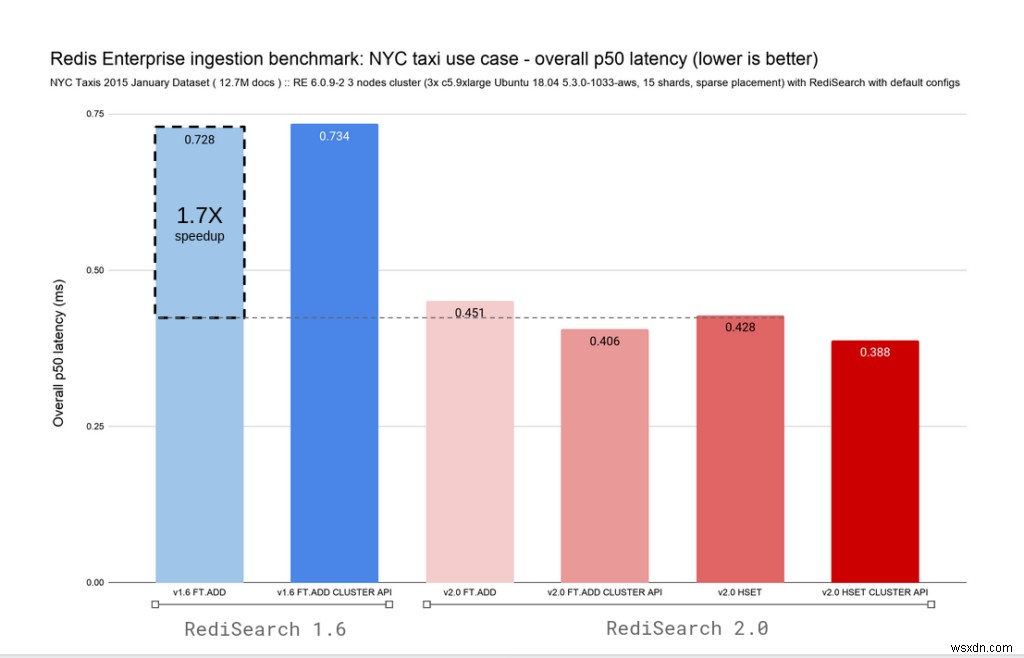
RediSearchは常に高速でしたが、今回のアーキテクチャ変更により、毎秒9万6千件だったインデックス作成速度が毎秒13万2千件に向上し、p50取り込みレイテンシは0.4ミリ秒を記録。書き込みスケーリングが劇的に改善されました。
スループットの向上だけでなく、個々の取り込み処理も高速化されています。アーキテクチャ変更による全体的な改善に加え、OSS Redis Cluster APIの機能を活用すれば、検索データベースの取り込みを線形にスケールさせることが可能です。
スループットとレイテンシの両面での改善を合わせると、RediSearch 2.0はRediSearch 1.6比で最大2.4倍の高速化を実現しています。
RediSearch 2.0の今後の展望
まとめると、RediSearch 2.0は、これまでにリリースされた中で最も高速かつスケーラブルな、すべてのRedisユーザー向けのバージョンです。加えて、新アーキテクチャにより、Redis内の既存データに対するインデックス作成をシームレスに行えるようになり、Redisデータを別のRediSearch対応データベースへ移行する必要性もなくなりました。この新アーキテクチャにより、RediSearchはStreamsやStringsなど他のデータ構造も追跡して自動インデックス化できるようになります。今後のリリースでは、RedisJSONのネストされたデータ構造のような、さらなるデータ構造との連携が可能になる予定です。
今後も開発者体験をさらに高める機能を追加していく予定です。次回は、検索クエリをプロファイリングし、クエリ実行時にどこでパフォーマンスボトルネックが発生しているのかを把握しやすくする新しいコマンドが登場します。お楽しみに。
さっそく始めてみませんか?Tug Grallによる「Getting Started with RediSearch 2.0」のブログ記事をぜひご覧ください。その後、GitHubのチュートリアルの手順に従うか、Redis Enterprise Cloud Essentialsで無料のデータベースを作成してみてください。(なお、RediSearch 2.0のパブリックプレビューは、Redis Enterprise Cloud Essentialsのムンバイおよびオレゴンの2リージョンで利用可能です。)
-
MongoDB Compass(コンパス)とは?特徴・エディション・基本的な使い方を徹底解説
本記事では、MongoDB®の公式GUIツールであるMongoDB Compassについて、その概要からインストール方法、基本的な操作まで詳しく解説します。 MongoDB Compassの概要 MongoDB Compassは、MongoDBクエリ構文の専門知識がなくても、視覚的なインターフェースを通じてデータベースを分析・理解できる強力なツールです。データの可視化による探索だけでなく、以下のような高度な機能も備えています。 クエリパフォーマンスの最適化 インデックスの管理 ドキュメントバリデーション(スキーマ検証)の実装 これにより、開発者だけでなく、運用担当者やデータアナリストなど、
-
Fastly ComputeでUpstash Redisを活用する方法
この記事では古いバージョンのFastly CLIを使用しています。最新の手順については、こちらの記事をご確認ください。 この記事では、Fastly Compute@Edge上で動作するシンプルなアプリケーションを作成します。このアプリケーションはUpstash Redisにアクセスし、ページビュー数を記録します。 モチベーション エッジコンピューティングは、近年最も注目されているトレンドのひとつです。CloudflareやFastlyといったCDNサービスは、ユーザーが自社のエッジインフラストラクチャ上でアプリケーションを実行できるようにしました。これにより、開発者はグローバルに分散した高