
速く、速く!Redisのパフォーマンスを体系的に改善する方法
Redisは、パフォーマンスを最大限に重視して開発されているインメモリデータストアです。私たちはリリースごとに、安定性と高速性を兼ね備えた製品をお届けできるよう最善を尽くしています。
それでもなお、Redisの効率をさらに高めたい場合や、パフォーマンスの退行(リグレッション)を調査したい場合には、パフォーマンスをモニタリング・分析するための簡潔で体系的な手法が必要です。本記事では、そのような最適化の実際の事例をご紹介します。
その結果、ストリームの取り込み性能を約20%向上させることに成功しました。この改善は、Redis v7.0からすでに利用できます。
標準的なSPECベンチマークの活用
最適化の詳細に入る前に、どのようなプロセスで改善点にたどり着いたのか、その全体像を簡単にご説明します。
前述のとおり、私たちの目的はRedisのパフォーマンス退行や、CPU上での性能改善の余地を特定することです。そのために、パフォーマンスおよびオブザーバビリティに関する要件や期待値について、企業間・コミュニティ間で共通の標準を整備する必要があると考えました。
具体的には、SPECのベンチマークをブランチやタグごとに継続的に実行し、プロファイリングツールやプローバの出力、クライアント側の出力を含むパフォーマンスデータを、「ゼロタッチ」の完全自動モードで解釈しています。
使用しているツールはすべてオープンソースで、memtier_benchmark、redis-benchmark、Linux perf_events、bcc/BPFトレーシングツール、そしてBrendan Gregg氏のFlameGraphリポジトリなど、広く使われているツールやフレームワークを基盤としています。
Redisでのプロファイラの活用方法についてさらに詳しく知りたい方は、非常に詳細な「Performance engineering guide for on-CPU profiling and tracing」(on-CPUプロファイリングとトレーシングのためのパフォーマンスエンジニアリングガイド)を参照することをお勧めします。
重複した計算を排除してパフォーマンスを向上
最初のステップが整い次第、私たちはプロファイリングツールやプローバの出力の解析を開始しました。その中で興味深いパターンが見られたのが、ストリームへのデータ取り込みベンチマークでした。このベンチマークは、以下のようなコマンドを使って、単純にストリームへデータを書き込むものです。
XADD key * field value
観察したところ、IDを指定せずにストリームへ追加する際、SDS(Simple Dynamic Strings)の作成・解放・sdslen処理で重複した作業が発生しており、CPUサイクルの約10%を消費していることがわかりました。詳細は、次の2つのperfレポートの出力をご覧ください。
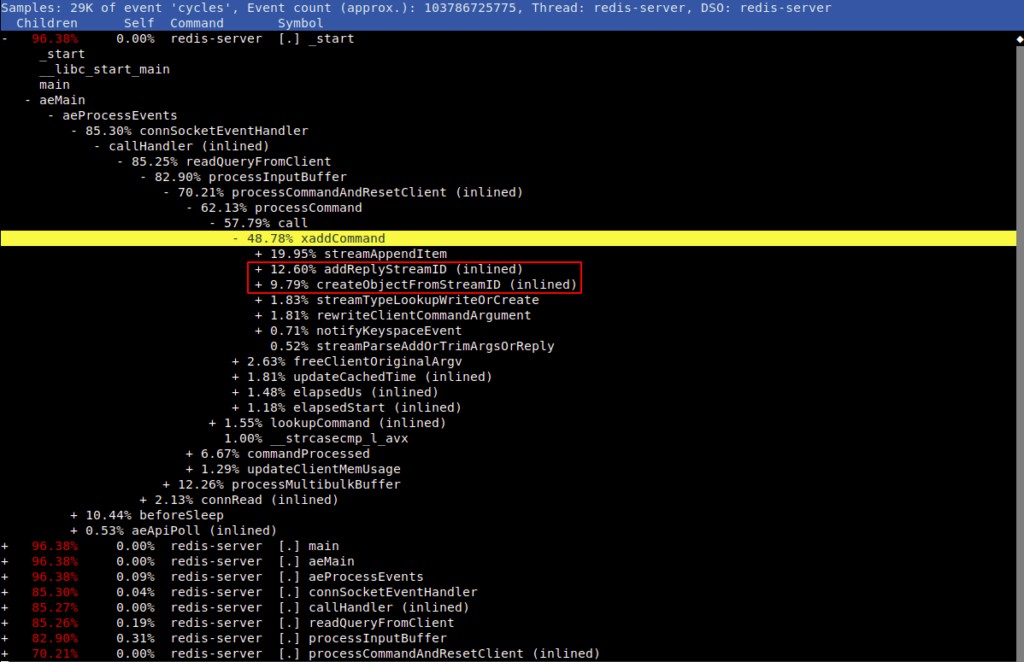
同じ入力に対して、sdscatfmtと_sdsnewlenがそれぞれ2回呼び出されていました。
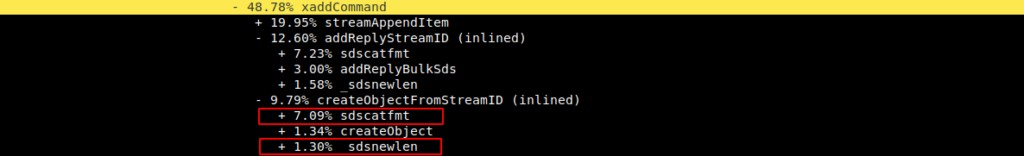
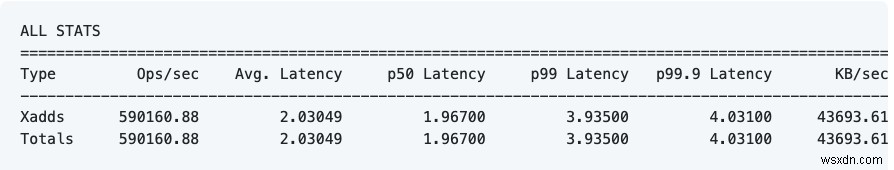
この発見により、ストリームの取り込みを約9〜10%最適化できました。以下のベンチマーク結果でその効果を確認できます。
unstableブランチのベースライン(6b403f5):
本PRの最初のコミット(重複作業の回避):
重複したメモリ割り当ての排除によるさらなる高速化
このユースケース改善への当初の取り組みは、コアチームメンバーの一人であるOranによるさらなる分析につながりました。彼は、同じコードブロック内の非効率なメモリ管理によって、CPUサイクルがさらに無駄になっていることに気づいたのです。今回の問題は、空のSDSを割り当てた後、再度割り当て直していたというものでした。呼び出し回数を減らせば、さらなる速度向上が期待できます。
2番目のコミット(再割り当ての回避):
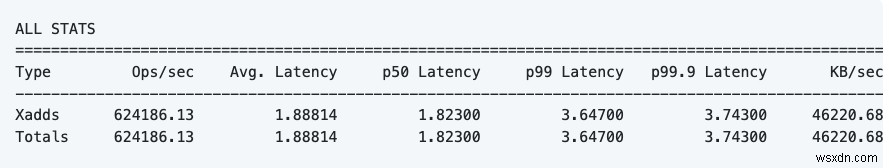
実測された改善効果
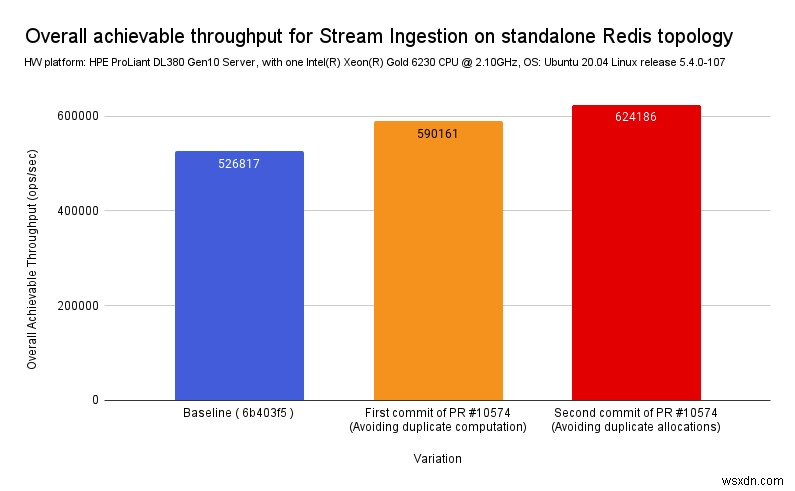
予想どおり、中間計算を再利用することで、内部関数内の冗長な計算とメモリ割り当てを削減できました。その結果、Redisストリーム全体のCPU時間を約20%削減することに成功しました。
これは、体系的かつシンプルな改善の積み重ねが、Redisのようにすでに深く最適化されたコードであっても、大幅なパフォーマンス向上をもたらしうる好例だと私たちは考えています。
私たちの目標は、Redisのパフォーマンスに対する可視性をさらに拡大することです。業界や学界を問わず、組織・個人を問わず皆様からの貢献を歓迎します。
測定しなければ、改善もできません。
-
Redis LLENコマンドの使い方 – データストア内のリストの長さを取得する方法
このチュートリアルでは、Redisデータストア内のキーに保存されたリスト値の長さ(要素数)を取得する方法を解説します。この目的のために使用するのが、RedisのLLENコマンドです。 LLENコマンドとは LLENコマンドは、指定したキーに保存されているリスト値の長さ(要素数)を返します。もしキーがRedisデータストアに存在しない場合、そのキーは空のリストとして解釈され、0が返されます。 また、キーは存在するものの、そのキーに保存されている値がリスト型ではない場合にはエラーが発生する点に注意してください。 構文 Redis LLENコマンドの基本構文は以下のとおりです。 redis host
-
Redis SETRANGEコマンドの使い方 – 文字列値の一部を更新する方法
このチュートリアルでは、Redisデータストア内の指定したキーに保存された文字列値の一部を更新する方法を解説します。そのために、RedisのSETRANGEコマンドを使用します。 SETRANGEコマンドとは SETRANGEコマンドは、開始オフセット(start offset)を受け取り、その位置から文字列値の上書きを行います。開始オフセットが現在の文字列値の長さよりも大きい場合は、指定されたオフセットの位置に届くまで文字列値がゼロバイト(0x00)でパディングされます。インデックスはゼロベースで扱われるため、0は先頭の文字、1は2番目の文字を意味します。 また、指定したキーがRedisデー