
階層型データベースモデルとは?仕組み・メリット・デメリットを徹底解説
階層型データベースモデルの概要
階層型モデルは、各レコードが必ず1つの親を持つツリー構造でデータを表現するデータベースモデルです。同じ親を持つ兄弟ノードの順序を維持するためにソートフィールドが用意されており、データは整理された形で管理されます。このモデルはもともと、IBMのIMS(Information Management System)に代表される、初期のメインフレーム向けデータベース管理システム(DBMS)のために設計されたものです。
階層構造では、2種類以上のデータ間において「1対1」および「1対多」のリレーションシップを表現できます。この構造は、目次や入れ子になった整列済み情報のように、現実世界における多くの関係性を記述する際に非常に有効です。
また、階層構造はストレージ上のレコードの物理的な配置順序としても利用されます。ユーザーはポインタを使用してデータ構造をたどりながら、シーケンシャルアクセスと組み合わせてレコードへアクセスします。そのため、各レコードへの完全なパスが含まれていない場合には、一部のデータベース操作に階層構造は適していません。
この種のデータベースでは、データは階層的に構成され、一般的に逆さの木(逆木構造)として実装されます。構造の「ルート」はデータベース内の単一のテーブルであり、その他のテーブルはルートから枝分かれするブランチ(枝)として機能します。下図は典型的な階層型データベースの構造を示したものです。
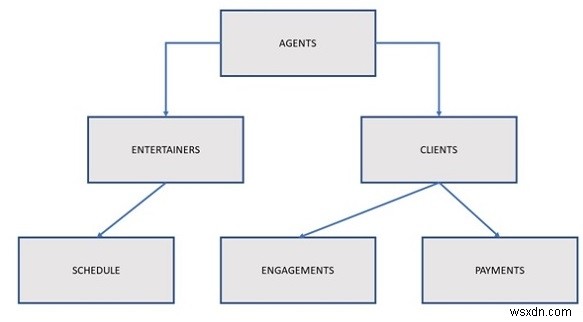
Agentsデータベースの具体例
上の図では、エージェントが複数の演芸者(エンターテイナー)のブッキングを担当し、それぞれの演芸者が自身のスケジュールを持っています。エージェントの役割は、エンターテイメントのニーズを持つ複数のクライアントを管理することです。クライアントはエージェントを通じて出演契約を申し込み、サービスの対価としてエージェントに支払いを行います。
親子関係によるテーブルのリンク
このデータベースモデルにおけるリレーションシップは「親/子」という用語で表されます。この関係では、1つの親テーブルに対して1つ以上の子テーブルを関連付けられますが、1つの子テーブルに関連付けられる親テーブルは1つだけです。テーブル同士は、ポインタやインデックスによって明示的にリンクされるか、あるいはテーブル内のレコードの物理的な配置によって結び付けられます。
ユーザーはルートテーブルを出発点として、ツリーを下っていくことで目的のデータへアクセスします。複雑な手順なしにデータへアクセスするためには、あらかじめデータベースの構造をよく把握しておく必要があります。
階層型データベースのメリット
- テーブル構造間に明示的なリンクが存在するため、ユーザーはデータを非常に高速に取得できます。
- 参照整合性が組み込まれており自動的に強制されます。そのため、子テーブルのレコードは必ず親テーブルの既存レコードにリンクされなければならず、親テーブルのレコードが削除されると、紐づく子テーブルの全レコードも同時に削除されます。
階層型データベースのデメリット
- 親テーブルのどのレコードにも関連しないレコードを子テーブルに格納したい場合、登録が困難になり、ユーザーは親テーブルに追加のエントリを作成しなければなりません。
- 複雑なリレーションシップをサポートできず、冗長性の問題も抱えています。複数の場所でデータが一貫性なく記録されると、不正確な情報が生成される恐れがあります。
冗長性の問題:具体例
前述の図のデータベースを例に考えてみましょう。子テーブル(Entertainers=演芸者)のレコードは、必ず親テーブル(Agents=エージェント)のレコードに関連付けられている必要があるため、演芸者がAgentsテーブルで特定のエージェントに割り当てられるまで、Entertainersテーブルに新しいレコードを入力することはできません。
さらに、この種のデータベースは冗長データの問題を抱えています。例えば、クライアントと演芸者の間に多対多の関係があるとします。1人の演芸者は多くのクライアントのために出演し、1人のクライアントは多くの演芸者を雇います。こうした関係は階層型データベースでは簡単にモデル化できないため、開発者はSchedule(スケジュール)テーブルとEngagements(契約)テーブルの両方に冗長なデータを導入せざるを得ません。
- Scheduleテーブルには、どの演芸者が誰のためにどこで出演するのかを示すため、氏名・住所・電話番号といったクライアントの情報が格納されることになります。このデータはClients(クライアント)テーブルにも保存されているため、冗長です。
- Engagementsテーブルには、特定のクライアントのためにどの演芸者が出演するのかを示すため、氏名・電話番号・演芸者の種類といった演芸者の情報が格納されることになります。このデータもEntertainersテーブルにすでに保存されているため、冗長です。
このような冗長性の最大の問題点は、ユーザーが同一のデータを場所ごとに異なる形式で入力してしまう可能性が生まれ、結果として不正確な情報につながり得ることです。
冗長性の問題を解決する方法
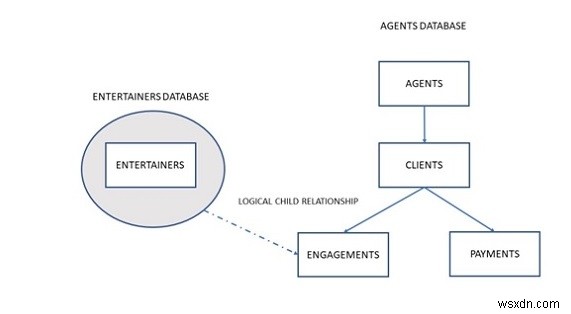
この問題は、演芸者専用の階層型データベースと、エージェント専用の階層型データベースを別々に作成することで解決できます。EntertainersデータベースにはEntertainersテーブルのデータのみを格納し、改訂版のAgentsデータベースにはAgents・Clients・Payments・Engagementsの各テーブルのデータを格納します。AgentsデータベースのEngagementsテーブルと、EntertainersデータベースのEntertainersテーブルとの間に「論理的な子関係」を定義できるため、物理的にデータを重複させる必要はありません。
この関係を設定しておけば、「特定のクライアントがブッキング済みの演芸者の一覧」や「特定の演芸者の出演スケジュール」といったさまざまな情報を取得できます。全体像は下図の通りです。
歴史的背景と現在の位置づけ
階層型データベースは、1970年代のメインフレームで使用されていたテープストレージシステムと非常によく適合しており、そうしたシステムを基盤とする組織のデータベースとして広く普及しました。高速かつ直接的なデータアクセスを提供し、多くの場面で有用でしたが、データの冗長性やデータ間の複雑な関係といった深刻化する問題に対処するには、新しいデータベースモデルが必要であることは明らかでした。
このモデルの背後にある考え方は、特定の種類のデータ格納には有効ですが、汎用性は決して高くなく、限定的な用途にとどまります。
例えば、企業において各従業員が特定の部署に所属して報告を行うケースを考えてみましょう。この場合、部署を親レコードとし、個々の従業員をその親レコードへリンクされた子レコードとして表現する、といった階層構造が自然に成立します。
-
ピボットテーブルのデータモデルで計算フィールド(メジャー)を作成する方法
ピボットテーブルのデータモデルで計算フィールドを作成したいとお考えの方に向けて、この記事では具体的な手順を詳しく解説します。計算フィールドの基本概念から、実際の作成・削除・数式確認の方法まで、実例を交えてわかりやすくご紹介します。 計算フィールドとは? 計算フィールド(Calculated Field)は、ピボットテーブルやピボットグラフに組み込める重要な機能で、「メジャー(Measure)」とも呼ばれます。計算フィールドはDAX数式を使用して作成されるフィールドです。ピボットテーブルの作成後に、元のデータセットにはない追加の指標(例:ボーナス額や利益率など)を計算したい場合に、この計算フィ
-
Excelでデータモデルを作成する3つの方法|リレーションシップ・Power Query・Power Pivot
データモデルは、Excelでのデータ分析に欠かせない機能です。データモデルを活用すると、テーブルなどのデータをExcelのメモリ上に読み込み、共通の列を基準に複数のデータ同士を関連付けることができます。各テーブル間のつながり(関係性)こそが、「データモデル」という言葉が示す「モデル」の正体です。Excelにはデータモデルを作成するための方法が複数用意されており、本記事では3つの異なるアプローチをわかりやすく解説します。 Excelでデータモデルを作成する3つの便利な方法 本記事では、Excelでデータモデルを作成する3つの実用的な手法をご紹介します。まず「リレーションシップ」ダイアログを使う