
C++でN分木をシリアライズ・デシリアライズする方法
N分木(N-ary tree)を与えられたとき、それをシリアライズ(直列化)し、さらにデシリアライズ(復元)する必要があります。シリアライズとは、データ構造やオブジェクトをビット列に変換する処理のことで、これによりファイルやメモリバッファに保存でき、後で同じ環境または別のコンピュータ環境で元の構造を再構築できます。
ここでは、N分木をシリアライズ・デシリアライズするためのアルゴリズムを設計します。N分木とは、根付き木(rooted tree)の一種で、各ノードが持つ子ノードの数がN以下である木のことです。
例えば、次のような入力が与えられた場合を考えます。
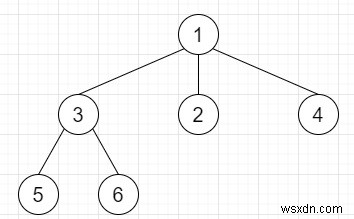
この場合、出力は次のようになります。
- シリアライズ結果:
1 #3 2 4 #5 6 ##### - デシリアライズされた木:
1[3[5, 6], 2, 4]
アルゴリズムの解説
この問題を解くために、以下の手順で処理を進めます。
1. createVector()関数
シリアライズされた文字列 s を受け取り、2次元配列に変換する補助関数です。
- 2次元配列 ret と、一時的な整数配列 tempv、一時的な文字列 temp を用意します。
- 文字列 s を先頭から1文字ずつ走査します。
- 空白でも '#' でもない文字であれば、temp に連結します。
- 空白文字であれば、temp を整数に変換して tempv の末尾に追加し、temp を空にします。
- '#' であれば、tempv を ret の末尾に追加し、temp を空にして tempv をクリアします。
- 最後に、ret の末尾にある空の配列(要素数0)をすべて削除します。
- ret を返します。
2. serialize()関数
木を文字列に変換する関数です。
- 結果を格納する文字列 ret を空文字で初期化します。
- root が null の場合は、そのまま空文字を返します。
- キュー q を用意し、root を挿入します。
- ret に根の値、空白、そして '#' を連結します。
- キューが空になるまで以下を繰り返します(BFS:幅優先探索)。
- キューの先頭要素を curr として取り出します。
- curr の子ノードを順に走査し、子が存在すればその値を ret に連結してキューに挿入します。各子の後に空白を追加します。
- 各ノードの処理が終わったら、ret に '#' を連結します。
- ret を返します。
3. deserialize()関数
文字列から木を復元する関数です。
- data が空文字列の場合は null を返します。
- createVector() を使って data を2次元配列 v に変換します。
- v[0][0] の値を持つ新しいノードを根として作成し、キューに挿入します。
- インデックス i を1から始め、キューが空でなく i が v のサイズ未満である間、以下を繰り返します。
- キューの先頭要素を curr として取り出します。
- v[i] の各要素 j に対して、新しいノード temp を作成し、curr の子として追加し、さらにキューに挿入します。
- i を1増やします。
- 根ノード ret を返します。
実装例
理解を深めるために、以下のC++の実装を見てみましょう。
#include <bits/stdc++.h>
using namespace std;
class Node {
public:
    int val;
    vector<Node*> children;
    Node() {}
    Node(int _val) {
        val = _val;
    }
    Node(int _val, vector<Node*> _children) {
        val = _val;
        children = _children;
    }
};
string n_ary_to_str(Node *root){
    string ret = "";
    if(root){
        ret = ret + to_string(root->val);
        if(root->children.size() > 0){
            ret += "[";
            for(Node* child : root->children){
                ret += n_ary_to_str(child) + ", ";
            }
            ret += "]";
        }
    }
    return ret;
}
class Codec {
public:
    vector<vector<int>>createVector(string s) {
        vector<vector<int>> ret;
        vector<int> tempv;
        string temp = "";
        for (int i = 0; i < s.size(); i++) {
            if (s[i] != ' ' && s[i] != '#') {
                temp += s[i];
            }
            else if (s[i] == ' ') {
                tempv.push_back(stoi(temp));
                temp = "";
            }
            else if (s[i] == '#') {
                ret.push_back(tempv);
                temp = "";
                tempv.clear();
            }
        }
        while (!ret.empty() && ret.back().size() == 0)
        ret.pop_back();
        return ret;
    }
    string serialize(Node *root) {
        string ret = "";
        if (!root)
            return ret;
        queue<Node *> q;
        q.push(root);
        ret += to_string(root->val);
        ret += " ";
        ret += "#";
        while (!q.empty()) {
            Node *curr = q.front();
            q.pop();
            for (int i = 0; i < curr->children.size(); i++) {
                if (curr->children[i]) {
                    ret += to_string(curr->children[i]->val);
                    q.push(curr->children[i]);
                }
                ret += " ";
            }
            ret += "#";
        }
        return ret;
    }
    Node *deserialize(string data) {
        Node *ret;
        if (data.size() == 0)
            return NULL;
        vector<vector<int>> v = createVector(data);
        ret = new Node(v[0][0]);
        queue<Node *> q;
        q.push(ret);
        int i = 1;
        while (!q.empty() && i < v.size()) {
            Node *curr = q.front();
            q.pop();
            for (int j = 0; j < v[i].size(); j++) {
                int node = v[i][j];
                Node *temp = new Node(node);
                curr->children.push_back(temp);
                q.push(temp);
            }
            i++;
        }
        return ret;
    }
};
main() {
    Codec ob;
    Node n5(5), n6(6);
    Node n3(3); n3.children.push_back(&n5); n3.children.push_back(&n6);
    Node n2(2), n4(4);
    Node n1(1); n1.children.push_back(&n3); n1.children.push_back(&n2);
    n1.children.push_back(&n4);
    cout << "Given Tree: " << n_ary_to_str(&n1) << endl;
    string ser = ob.serialize(&n1);
    cout << "Serialize: " << ser << endl;
    Node *deser = ob.deserialize(ser);
    cout << "Deserialized Tree: " << n_ary_to_str(deser);
}
入力
Node n5(5), n6(6);
Node n3(3); n3.children.push_back(&n5); n3.children.push_back(&n6);
Node n2(2), n4(4);
Node n1(1); n1.children.push_back(&n3); n1.children.push_back(&n2);
n1.children.push_back(&n4);
出力
Given Tree: 1[3[5, 6], 2, 4]
Serialize: 1 #3 2 4 #5 6 #####
Deserialized Tree: 1[3[5, 6], 2, 4]
この実装では、幅優先探索(BFS)を活用することで、N分木の構造を階層ごとに '#' で区切った文字列として保存しています。デシリアライズ時には、同じくBFSの順序でノードを復元するため、元の木構造を正確に再現できます。この手法は、二分木だけでなく任意の分岐数を持つ木構造にも応用可能です。
-
C++でDFSを使ってn分木のすべての葉ノードを出力する方法
問題の概要 この問題では、n分木(n-ary tree)の辺情報を格納した2次元配列が与えられます。配列の各要素は木の辺を表しており、この配列から構成されるn分木のすべての葉ノード(リーフノード)を出力することが求められます。 n分木とは、各ノードが最大でn個の子を持つことができる木構造のことです。つまり、あるノードは1個、2個……n個までの子ノードを持つ可能性があります。 入出力例 Input: edge[][] = {{5,8}, {5,6}, {8,1}, {8,4}, {6,7}} Output: 1 4 7 解説 − 辺配列をもとに木を構築すると、次のような構造になります。 この
-
Pythonで二分探索木(BST)をシリアライズ・デシリアライズする方法
シリアライズとデシリアライズとは? 本記事では、二分探索木(BST:Binary Search Tree)をシリアライズおよびデシリアライズするアルゴリズムをPythonで設計する方法を解説します。 シリアライズ(直列化)とは、データ構造やオブジェクトをビット列や文字列へ変換し、ファイルやメモリバッファへの保存、あるいはネットワーク越しの送信を可能にする処理のことです。一方、デシリアライズ(逆直列化)は、シリアライズされたデータから元のデータ構造を復元する逆のプロセスを指します。 例として、次のような二分木を考えてみます。 [5, 2, 9, 1, 3, 7] この場合、処理結果は以下のように