
JavaScriptで連結リストの各ノードの「次に大きい値」を効率的に求める方法
問題概要
JavaScriptで、連結リストの先頭ノード(head)を唯一の引数として受け取る関数を作成することを考えます。
この連結リストには数値データが格納されており、リスト内の各ノードには「次に大きい値(next larger value)」が存在する場合があります。ノードiに対して next_larger(node_i) とは、j > i かつ node_j.val > node_i.val を満たすノードの中で、j が最小になるような node_j.val のことです。そのような j が存在しない場合、次に大きい値は 0 となります。
つまり私たちの関数は、リスト内の各要素に対応する「次に大きい要素」を格納した配列を生成して返す必要があります。
入力例
例えば、次のような連結リストが与えられたとします。
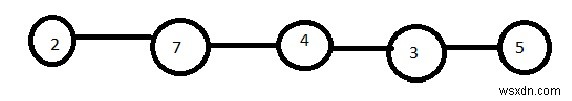
この場合、期待される出力は以下の通りです。
const output = [7, 0, 5, 5, 0];
出力の解説
リストは [2, 7, 4, 3, 5] となっています。先頭の 2 の次に大きい要素は 7、7 より大きい要素は後続に存在しないため 0、4 の次に大きいのは 5、3 の次に大きいのも 5、そして最後の 5 より大きい要素はないため 0 となります。
解法のアプローチ:スタックを活用したO(n)アルゴリズム
各ノードについて後続ノードをすべて調べる素朴な方法もありますが、その場合計算量は O(n²) となり非効率です。そこで単調スタック(monotonic stack)を利用すると、リストを一度走査するだけで O(n) で解くことができます。
基本的な考え方は次の通りです。
- スタックには「インデックスとノードの値のペア」を保存し、値が降順になるように管理します。
- 新しいノードの値がスタックの先頭(top)の値より大きい場合、そのペアを取り出し(pop)、対応するインデックスの答えとして現在の値を記録します。
- これにより、「まだ次に大きい値が見つかっていないノード」だけが常にスタックに残ります。
実装コード
実際のコードは以下の通りです。
class Node{
    constructor(data){
       this.data = data;
       this.next = null;
   };
};
class LinkedList{
    constructor(){
       this.head = null;
       this.size = 0;
   };
};
LinkedList.prototype.add = function(data){
    const newNode = new Node(data);
    let curr
    if(this.head === null){
       this.head = newNode;
    }else{
       curr = this.head;
       while (curr.next) {
          curr = curr.next;
       }
       curr.next = newNode;
   };
    this.size++;
};
const list = new LinkedList();
list.add(2);
list.add(7);
list.add(4);
list.add(3);
list.add(5);
const nextGreater = (head) => {
    const arr = [];
    const res = [];
    let curr = head;
    let currentIndex = 0
    while(curr){
       while (arr.length > 0 && curr.data > arr[arr.length - 1][1]) {
          const [index] = arr.pop();
          res[index] = curr.data;
       };
       arr.push([currentIndex, curr.data]);
       currentIndex += 1;
       curr = curr.next;
   };
    for(let i = 0; i < currentIndex; i++){
       if(res[i] === undefined){
          res[i] = 0;
       };
   };
    return res;
};
console.log(nextGreater(list.head));
出力結果
コンソールには以下のように出力されます。
[ 7, 0, 5, 5, 0 ]
コードのポイント
- arr(スタック):「インデックスと値」のペアを保持し、リストを走査しながら値の降順を維持します。
- res(結果配列):次に大きい値が確定したノードから順に値が書き込まれます。
- 最終ループ:走査終了時点でもスタックに残っているノード(= 次に大きい値が存在しないノード)には
0を代入します。
各ノードは最大で1回プッシュされ、1回ポップされるため、全体の時間計算量は O(n)、空間計算量も結果配列を除けば O(n) となり、非常に効率的です。
-
JavaScriptの二分木(バイナリツリー)とは?基本概念と重要用語を徹底解説
二分木(バイナリツリー)は、データの格納を目的として使用される特殊なデータ構造です。最大の特徴は、各ノードが持てる子ノードの数が2つまでという条件にあります。二分木は、整列済み配列と連結リストの両方の長所を兼ね備えた構造です。検索はソートされた配列と同等の速さで行え、データの挿入や削除も連結リストと同様に高速に実行できます。そのため、大量のデータを効率的に扱いたい場合に非常に有用なデータ構造といえます。以下は、二分木の構造を示したイラストです。図には、このあと解説する重要な用語も含まれています。二分木における重要な用語二分木を理解するうえで押さえておきたい、主要な用語を以下にまとめました。パス
-
【JavaScript入門】Symbolを使ってオブジェクトごとに一意のIDを作成する方法
はじめにJavaScriptでオブジェクトごとに一意のIDを作成したい場合、Symbol()を使うのが最も簡単かつ確実な方法です。Symbolは呼び出されるたびに必ず新しい一意の値を生成するため、たとえ同じ説明文字列を渡しても、二度と同じ値にはなりません。以下は、各オブジェクトに対して一意のIDを作成するサンプルコードです。実装例<!DOCTYPE html> <html lang="en"> <head> <meta charset="UTF-8" /> <meta name="viewp