
Tecton×Redis Enterprise Cloudで実現する高速・低コストのリアルタイム機械学習
リアルタイム機械学習(ML)アプリケーションは、今やあらゆる場面で活躍しています。クレジットカード取引のその場での承認や、お気に入りのストリーミングサービスにおける即時のパーソナライズド レコメンデーションの生成などがその代表例です。こうしたアプリケーションには遅延は許されません。超低遅延の推論(100ミリ秒以下)を実現するには、常に最新のデータへライブでアクセスできることが不可欠です。開発者や企業が大規模MLアプリケーション向けのコスト効率の高いリアルタイム機能を手に入れられるよう、TectonとRedis Enterprise Cloudのファーストクラスな統合を発表いたします。
Redis Enterprise Cloudは、Redisの中でも最高峰のエディションであり、あらゆるクラウドベンダー環境において最高水準のパフォーマンス、スケーラビリティ、コスト効率を提供します。Redisは、Stack Overflowの年間開発者調査において5年連続で「最も愛されているデータベース」に選ばれています。金融サービス、eコマース、ゲーム業界で広く採用されており、サブミリ秒という厳しいレイテンシ要件や高可用性要件を満たしてきた確かな実績があり、リアルタイムMLアプリケーションのニーズに理想的に適合します。
Tectonは、MLプロジェクトの本番環境への投入までの時間を短縮したい企業向けのリーディング フィーチャーストアです。その基盤となっているのは、UberのすべてのMLアプリケーションを支えるプラットフォーム「Uber Michelangelo」を構築した経験です。Tectonは、本番MLアプリケーションのためのデータパイプラインと特徴量を運用・管理するシステムであり、典型的なユースケースとしては、不正検知、リアルタイム レコメンデーション、動的価格設定、パーソナライゼーションなどが挙げられます。
TectonのFeature StoreがRedis Enterprise Cloudと統合され、オンラインサービングに対応したことで、低遅延・高スループットのMLユースケースを本番化することが、これまで以上に簡単かつコスト効率よく行えるようになりました。大規模に運用するTectonユーザー向けのベンチマーク分析では、Redis EnterpriseはAmazon DynamoDBと比較して3倍高速なレイテンシを実現しながら、同時に14分の1のコストで運用できることが示されています(詳細はTectonのブログをご覧ください)。本記事では、Redis EnterpriseとTectonがどのように連携するのかを詳しく見ていきます。
TectonとRedisの連携の仕組み
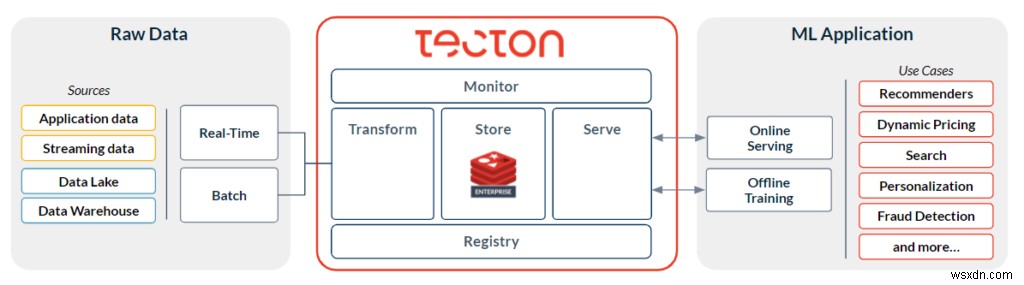
リアルタイムMLを実現するためにTectonとRedisがどこで組み合わさるのかを理解するため、不正検知のようなMLユースケースを本番化するステップを見てみましょう。
- まず、生データが必要です(例:特定ユーザーの過去のすべての取引履歴+現在進行中の取引データ)。このデータは、企業内のさまざまなデータウェアハウスやデータストリームに分散しているのが一般的です。
- モデル用の特徴量を生成するには、それらのデータソースに接続し、特徴量をもたらすデータ変換を定義・実行する必要があります。たとえば、「過去6か月間のユーザーの平均取引額を算出し、現在の取引額と比較する」といった特徴量が考えられます。
- 最終的に、リアルタイム予測を行うMLモデルへ特徴量を提供する必要があります。ユーザーに遅延を感じさせないよう、100ミリ秒未満のレイテンシでこれを行うことが求められます。
TectonのFeature Storeは、これらのステップを処理するために設計されており、特徴量変換やデータパイプラインのオーケストレーションにかかる作業をすべて抽象化することで、データサイエンスチームやデータエンジニアリングチームがモデル構築に集中できるようにします。ただし、Tecton自体はコンピュートエンジンでもデータベースでもありません。代わりに、顧客がすでに利用しているインフラストラクチャの上に位置づけられるため、自社に最適なMLスタックを自由に構築できます。
Redis Enterprise Cloudは、そうしたインフラストラクチャ コンポーネントの一つであり、TectonのFeature Storeが使用するオンラインストアの新しい高性能な選択肢をお客様にもたらします。
オンラインストアとオフラインストアの使い分け
TectonのFeature Storeは、MLにおける2つの主要なアクセスパターンをサポートしています。1つはモデルトレーニング用に数百万行もの履歴データを取得すること、もう1つは本番環境で稼働するモデルに特徴量を提供するために、わずか数ミリ秒で単一行を取得することです。これらのユースケースは、パフォーマンスとコストのトレードオフの観点で大きく異なるため、オフラインとオンラインの特徴量取得に対して、それぞれ異なるタイプのデータベースをサポートしています。
オフラインフィーチャーストアについては、TectonはS3をサポートしています。S3はコスト効率に優れたストレージであり、モデルトレーニングのためのオフライン特徴量提供のニーズに応じて柔軟にスケールできます。一方、オンラインフィーチャーストアについては、TectonはDynamoDB(オンデマンド容量モード)とRedis Enterprise Cloudのどちらかを選択できる柔軟性をお客様に提供するようになりました。
トレーニング・サービング スキューの解消
このようなデュアルデータベース方式がない場合、多くの組織ではオフラインのトレーニング用とオンラインのサービング用に、別々のデータパイプラインを実装することになります。しかし、パイプラインの実装方法のわずかな違いが、モデルのパフォーマンスを完全に損なう原因になり得ます。トレーニング時にモデルが参照するデータと、本番環境で遭遇するデータが一致しなくなるからです。この不一致は「トレーニング・サービング スキュー」と呼ばれ、デバッグに膨大な時間を要する厄介な問題です。
TectonのFeature Storeは、オフライン環境とオンライン環境全体のデータを調整して常に同期状態を保つことで、トレーニング・サービング スキューを自動的に解消します。ユーザーはまずオフラインストアのみを使ってバッチ推論から始め、オンライン推論の準備が整った時点で、コードを1行更新するだけでオンラインストアへのデータのマテリアライズを開始できます。
TectonユーザーにとってのRedis Enterprise Cloudのメリット
大規模に運用するTectonユーザーにとって、Redis Enterprise Cloudを使用する主なメリットの1つは、パフォーマンスとコスト削減です。高スループットでのオンライン特徴量提供に関するベンチマーク分析によると、Tecton上ではRedisはDynamoDBよりも3倍高速で、14倍低コストでした。
さらに、Redis Enterprise Cloudは、現在および将来の低遅延ストレージニーズに対応できる優れた運用機能も備えています。99.999%のアップタイムSLAによる高可用性に加え、複数のデータベース永続化、バックアップ、リカバリーオプションを提供します。大規模な特徴量データセットを扱うお客様は、オンラインフィーチャーストアをDRAMとSSDに階層化することで、さらなるコスト削減を実現できます。
始め方
まだRedis Enterprise Cloudをご利用でない場合は、こちらからアカウント登録が可能です。Tectonユーザーには、レイテンシを最小限に抑えるため、AWS上にRedis Enterprise Cloudをデプロイすることをお勧めします。TectonはAWS上でネイティブに動作し、Redis Enterprise Cloudとのピアリング接続を確立できるためです。今後、Tectonは他のクラウドベンダープラットフォームのネイティブサポートも追加する予定です。
Tectonユーザーではない方で、詳細に関心がある場合は、こちらからTectonの無料トライアルにご登録いただけます。
-
Nuxt 3とサーバーレスRedis(Upstash)で始めるページ訪問カウント実装
Nuxt 3とサーバーレスRedis(Upstash)で始めるページ訪問カウント実装 アプリケーションの利用状況を追跡したり、リソース利用を制限したり、キャッシュからデータを取得してパフォーマンスを向上させたりする必要がある場合、Redisがその答えとなります。Redisはインメモリのキー・バリュー型データベースであり、オープンソースで「Remote Dictionary Server」の略称です。 この記事では、サーバーレスRedisサービスであるUpstashと、Vue SSRフレームワークの最新ベータ版であるNuxt 3を組み合わせた基本的なアプリケーション構築を通じて、Redisの基礎
-
ビッグデータ・データマイニング・機械学習の違いとは?基礎から徹底解説
ビッグデータ・データマイニング・機械学習の違いとは?基礎から徹底解説テクノロジーは目覚ましいスピードで進化しており、私たちは複雑に絡み合うデータのネットワークへと足を踏み入れつつあります。その一方で、世界中の企業はビッグデータ、データマイニング、機械学習といった革新的なテクノロジーの導入によって、事業の大転換を図ろうとしています。では、なぜ世界中のビジネスがこれらの技術の導入に躍起になっているのでしょうか?それぞれの基本的な概念とは何か、そして互いにどのような違いがあるのかを見ていきましょう。なぜビッグデータ、データマイニング、機械学習が必要なのか?データ需要の高まりと競争の激化により、各企業