
RediSearch 2.0、最初のマイルストーンに到達 ― データ自動インデックス化の新アーキテクチャ
RediSearch 2.0の開発における最初のマイルストーンとなるリリースをお知らせできることを大変うれしく思います。RediSearchはリアルタイム検索エンジンで、Redis上のデータに対してクエリを実行し、幅広い種類の複雑な問い合わせに答えることができます。
このマイルストーンは「2.0-M01」と呼ばれ、インデックスとデータの同期方法が再設計されたことを示しています。従来のようにFT.ADDコマンドを使ってインデックス経由でデータを書き込む必要はなくなり、RediSearchがハッシュに書き込まれたデータを追跡して、自動的にインデックス化するようになりました。
この大きなメリットは、アプリケーションコードを一切変更することなく、既存のRedisインスタンスにRediSearchを追加し、セカンダリインデックス(副次索引)を作成できる点です。RediSearchモジュールをロードしてスキーマを定義するだけで、既存のデータに対して即座にRediSearchを使い始められます。RediSearch 2.0の一般提供(GA)は今年の秋を予定しています。
注意:この新機能には、APIに対するいくつかの変更(下記参照)が含まれています。可能な限り後方互換性を維持するよう努めていますが、今回の場合はそれが不可能でした。ユーザーからのフィードバックを集めながら、今後調整と修正を行っていく予定です。
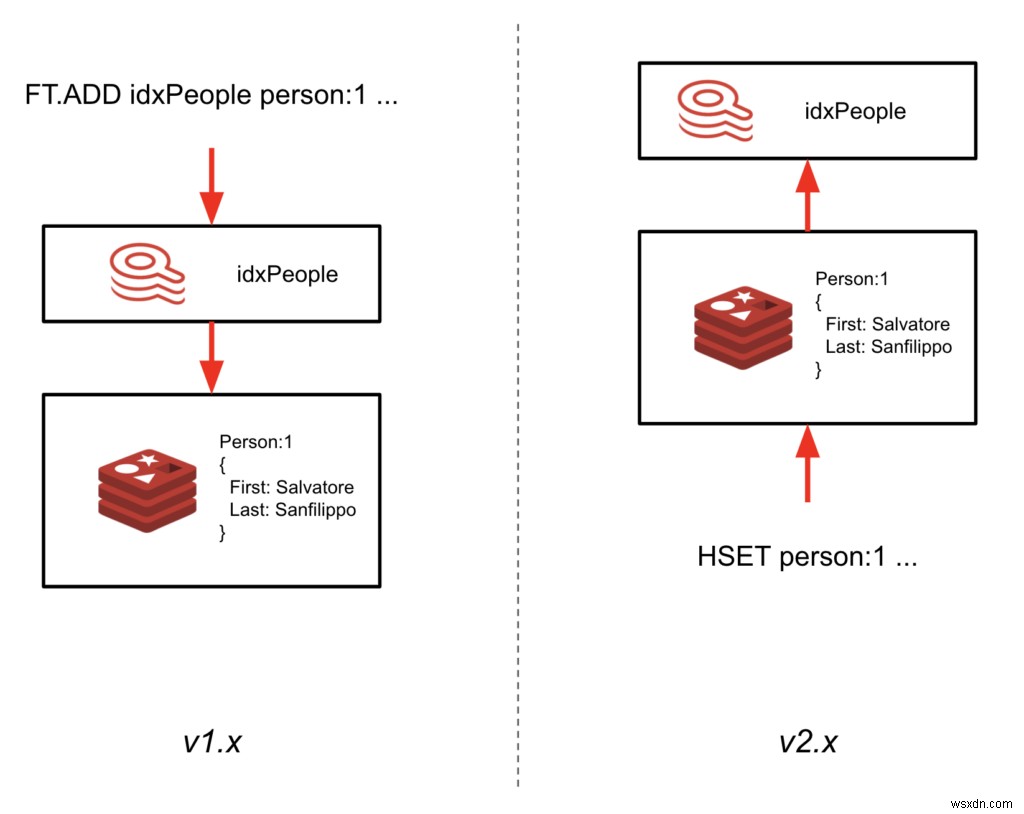
APIの主な変更点
前述のとおり、このRediSearch 2.0マイルストーンには、APIに関する以下のような変更が含まれています。
- インデックスがキースペースに存在しなくなった:たとえば、データベース内のインデックス一覧を取得するためにインデックスキー(idx:<index名>)を使っていた場合、それは動作しなくなります。その代わり、データベース内のすべてのインデックスを返す新しいコマンドFT._LISTが用意されました。
- インデックスはプレフィックス/フィルターを指定して作成する必要がある:これらは、どのドキュメントをRediSearchが自動的にインデックス化するかを指定するものです。単純なプレフィックスから、複雑なフィルター式まで柔軟に指定できます。
- アップグレードは不可:旧バージョンのRediSearchで作成したRDBファイルは、RediSearch 2.0では読み込めません。現時点では、データセット全体を再インデックス化する必要があります。ただし、GAリリースに向けてアップグレード手順の整備を進めています。
- Redis 6以降でのみ動作する。
- FT系コマンドがRedisの同等コマンドへマッピングされた:これにより、既存のアプリケーションでもRediSearch 2.0を引き続き利用できます。マッピングは以下のとおりです。
- FT.ADD ⇒ HSET
- FT.DEL ⇒ DEL(デフォルトはDD)
- FT.GET ⇒ HGETALL
- FT.MGET ⇒ HGETALL
- 転置インデックス自体はRDBに保存されなくなった:これは永続化がサポートされなくなったという意味ではありません。RediSearchはインデックス定義をRDBに保存し、Redisの起動後にバックグラウンドでデータを再インデックス化します。FT.INFOコマンドでインデックス作成状況を確認すれば、再インデックスの完了タイミングを把握できます。
新しいAPI
API最大の変更点は、インデックスの作成方法です。RediSearch 2.0では、FT.CREATEコマンドを使ってインデックスを作成します。APIに追加された部分は、以下の例で黄色くハイライトされています。
FT.CREATE {index}
    ON {structure}
     [PREFIX {count} {prefix} [{prefix} ..]
     [FILTER {filter}]
     [LANGUAGE_FIELD {lang_field}]
     [LANGUAGE {lang}]
     [SCORE_FIELD {score_field}]
     [SCORE {score}]
     [PAYLOAD_FIELD {payload_field}]
   [TEMPORARY {seconds}]
   [MAXTEXTFIELDS]
   [NOOFFSETS] [NOHL] [NOFIELDS] [NOFREQS]
   [STOPWORDS {num} {stopword} ...]
   SCHEMA {field} [TEXT [NOSTEM] [WEIGHT {weight}] [PHONETIC {matcher}] | NUMERIC | GEO | TAG [SEPARATOR {sep}] ] [SORTABLE][NOINDEX] ...
ここから、いくつかの詳細を見ていきましょう。
- ON {structure}:現在はHASHのみをサポートしています。
- PREFIX {count} {prefix}:どのキーをインデックス化するかを指定します。複数のプレフィックスを指定することも可能です。この引数は省略可能で、デフォルトは*(すべてのキー)です。
- FILTER {filter}:RediSearchの集計式言語をフルに活用できるフィルター式です。@__keyを使えば、直前に追加・変更されたキーにアクセスできます。
- LANGUAGEとSCORE:インデックス化される全ドキュメントのデフォルトの言語とスコアを上書きできます。
- LANGUAGE_FIELD、SCORE_FIELD、PAYLOAD_FIELD:ドキュメントごとの言語やスコアを設定したり、ペイロードをドキュメント内のフィールドとして扱ったりできます。
その他の制限事項と変更点
RediSearch 2.0-M01マイルストーンには、ほかにも次のような更新が含まれています。
- NOSAVEはサポートされなくなりました。
- ハッシュを更新すると、ドキュメント全体が再インデックス化されます(キースペース通知では、どのフィールドが変更されたかが判別できないため)。そのため、部分更新は低速になります。こうしたケースでのパフォーマンス改善策については、現在も検討を進めています。
- フィールド名が大文字・小文字を区別するようになりました。たとえば「FOO」と宣言したフィールドを「foo」としてインデックス化しても機能しません。
- FT.ADDコマンドは、次のようにHSETへマッピングされます。
FT.ADD idx doc1 1.0 LANGUAGE eng PAYLOAD payload FIELDS f1 v1 f2 v2
は、次のように変換されます。
HSET doc1 __score 1.0 __language eng __payload payload f1 v1 f2 v2
つまり、マッピングが期待どおりに機能するようにするには、インデックス側のスコア・言語・ペイロードの各フィールドを、それぞれ__score、__language、__payloadという名前にしておく必要があります。
- FT.ADDHASHはサポートされなくなりました。代わりにHSETを使用してください。
- FT.OPTIMIZEはサポートされなくなりました。インデックスの最適化は、RediSearchのガベージコレクション機能が担当します。
まとめ
私たちはこの変更をとても楽しみにしています。既存のRedisデータベースにRediSearchをロードすれば、ハッシュとして保存されている既存データをそのままインデックス化でき、ドキュメント操作の際にアプリケーションロジックを更新する必要がなくなるからです。本マイルストーンリリースは、GitHubからソースコードを取得するか、1:99:1タグのRediSearch Dockerイメージを使って試すことができます。このバージョンはまだ本番運用には適していませんが、皆さまからのフィードバックを早めに収集したいと考えています。ご意見や不具合報告は、GitHubリポジトリまたはRedisコミュニティフォーラムまでお寄せください。
-
RediSearch 2.0登場:2.4倍の高速化を実現した新アーキテクチャの全貌
Redis向けのリアルタイムセカンダリインデックスであり、フルテキスト検索機能を備えたRediSearchは、最も成熟した多機能なRedisモジュールの一つです。その人気は日々高まっており、ここ数ヶ月でRediSearchのDockerプル数は500%も急増しました。急速に拡大するユーザーベースからは、リアルタイム在庫管理からエフェメラルサーチまで、多彩で興味深いユースケースが生まれています。 この勢いをさらに加速させるべく、私たちはRediSearch 2.0のパブリックプレビューを発表します。RediSearch 2.0は、開発者体験の向上と、これまでで最もスケーラブルなバージョンとなるこ
-
RediSearchを実践しよう:Azure Cache for RedisとGoで作るリアルタイムツイート検索アプリ
Redisは、シンプルなStringから強力な抽象化であるRedis Streamsまで、多彩なデータ構造を備えています。ネイティブなデータ型だけでも多くの用途に対応できますが、特定のユースケースでは追加の工夫が必要になることがあります。その代表例がセカンダリインデックス(二次インデックス)の活用です。キーによる検索・参照にとどまらず、より高度なクエリ機能を実現したい場合には、セカンダリインデックスが求められます。Sorted SetやListなどを駆使して実現することも可能ですが、いくつかのトレードオフを考慮する必要があります。そこで登場するのがRediSearchです。Redisモジュール