
C++で解く「ユニークな二分探索木 II」― 再帰で全パターンのBSTを生成する方法
整数 n が与えられたとき、1 から n までの値を格納する、構造的にユニークな二分探索木(BST)をすべて生成することを考えます。例えば、入力が 3 の場合、生成される木は以下のようになります。
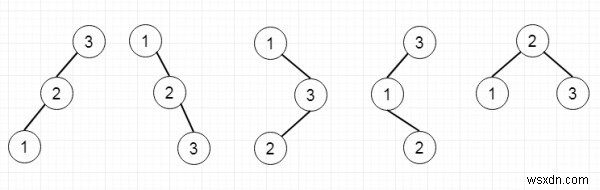
解法のアプローチ
この問題は再帰(バックトラッキング)を用いることで効率的に解けます。二分探索木の性質上、ある値 i を根にしたとき、左部分木には i より小さい値が、右部分木には i より大きい値が属します。この性質を利用して、各値を根とした場合の左右の部分木を再帰的に生成していきます。
アルゴリズムの手順
- low と high を引数に取る再帰関数 generate() を定義します。
- 結果を格納するためのノードリスト temp を用意します。
- low > high の場合は null を temp に挿入して返します(空の木を表します)。
- i を low から high までループさせます。
- left_subtree := generate(low, i - 1)
- right_subtree := generate(i + 1, high)
- current := i
- j を 0 から left_subtree のサイズまでループ
- k を 0 から right_subtree のサイズまでループ
- 値 current を持つ新しいノード curr_node を作成する
- curr_node の左の子 := left_subtree[j]
- curr_node の右の子 := right_subtree[k]
- curr_node を temp に追加する
- k を 0 から right_subtree のサイズまでループ
- temp を返します。
- 最初に generate(1, n) を呼び出すことで、すべての木を生成します。
実装例(C++)
理解を深めるために、以下の実装を見てみましょう。
#include <bits/stdc++.h>
using namespace std;
class TreeNode{
    public:
        int val;
        TreeNode *left, *right;
        TreeNode(int data){
            val = data;
            left = right = NULL;
        }
};
void insert(TreeNode **root, int val){
    queue<TreeNode*> q;
    q.push(*root);
    while(q.size()){
        TreeNode *temp = q.front();
        q.pop();
        if(!temp->left){
            if(val != NULL)
                temp->left = new TreeNode(val);
            else
                temp->left = new TreeNode(0);
            return;
        }
        else{
            q.push(temp->left);
        }
        if(!temp->right){
            if(val != NULL)
                temp->right = new TreeNode(val);
            else
                temp->right = new TreeNode(0);
            return;
        }
        else{
            q.push(temp->right);
        }
    }
}
TreeNode *make_tree(vector<int> v){
    TreeNode *root = new TreeNode(v[0]);
    for(int i = 1; i<v.size(); i++){
        insert(&root, v[i]);
    }
    return root;
}
void tree_level_trav(TreeNode*root){
    if (root == NULL) return;
        cout << "[";
    queue<TreeNode *> q;
    TreeNode *curr;
    q.push(root);
    q.push(NULL);
    while (q.size() > 1) {
        curr = q.front();
        q.pop();
        if (curr == NULL){
            q.push(NULL);
        }
        else {
            if(curr->left)
                q.push(curr->left);
            if(curr->right)
                q.push(curr->right);
            if(curr == NULL || curr->val == 0){
                cout << "null" << ", ";
            }
            else{
                cout << curr->val << ", ";
            }
        }
    }
    cout << "]"<<endl;
}
class Solution {
public:
    vector<TreeNode*> generate(int low, int high) {
        vector <TreeNode*> temp;
        if(low > high){
            temp.push_back(NULL);
            return temp;
        }
        for(int i = low;i<=high;i++){
            vector <TreeNode*> leftSubtree = generate(low,i-1);
            vector <TreeNode*> rightSubtree = generate(i+1,high);
            int current = i;
            for(int j = 0;j<leftSubtree.size();j++){
                for(int k =0;k<rightSubtree.size();k++){
                    TreeNode* currentNode = new TreeNode(current);
                    currentNode->left = leftSubtree[j];
                    currentNode->right = rightSubtree[k];
                    temp.push_back(currentNode);
                }
            }
        }
        return temp;
    }
    vector<TreeNode*> generateTrees(int n) {
        if(!n){
            vector <TreeNode*> r;
            return r;
        }
        return generate(1,n) ;
    }
};
main(){
    Solution ob;
    vector<TreeNode*> v = ob.generateTrees(3);
    for(int i = 0; i<v.size(); i++)
        tree_level_trav(v[i]);
}
入力
3
出力
[1, 2, 3]
[1, 3, 2]
[2, 1, 3]
[3, 1, 2]
[3, 2, 1]
出力の各行は、生成された木をレベル順(幅優先)走査で表現したものです。n = 3 の場合、5 通りの異なる構造が得られていることがわかります。
計算量について
構造的にユニークな二分探索木の総数はカタラン数で与えられます。n = 3 の場合のカタラン数は 5 であり、出力の行数と一致します。時間計算量および空間計算量は生成される木の総数に依存し、概ね O(4n / √n) のオーダーとなります。
-
C++プログラムにおける二分探索(バイナリサーチ)の基本と実装
二分探索(バイナリサーチ)とは二分探索は「半区間探索」「対数探索」「バイナリチョップ」とも呼ばれる検索アルゴリズムで、ソート済みの配列の中から目的の値が存在する位置を効率的に見つけ出します。基本的な仕組みは非常にシンプルです。まず、探したい値(ターゲット値)を配列の中央の要素と比較します。一致しなかった場合は、ターゲット値が存在し得ない半分を丸ごと排除し、残りの半分に対して同様の比較を繰り返します。この「中央との比較」と「範囲の絞り込み」を続け、ターゲット値が見つかるか、検索範囲が空になる(=配列にその値が存在しない)かのどちらかで処理が終了します。アイデア自体は簡単ですが、正しく実装するには
-
C#で二分探索(バイナリサーチ)を実装する方法|仕組みと計算量を解説
二分探索とは二分探索(バイナリサーチ)は、ソート済みの配列を対象とした高速な検索アルゴリズムです。探索したい値を配列の中央にある要素と比較し、一致しなかった場合は、その値が存在し得ない側の半分の領域を丸ごと除外します。この操作を残りの半分に対して繰り返すことで、効率よく目的の値を見つけ出します。例えば、下図のような配列から「62」という値を探す場合を考えてみましょう。中央の要素との比較結果から、62が存在するのは右側の領域だけであることが分かるため、左半分は完全に除外され、以降は右半分のみが探索対象となります。二分探索の計算量二分探索における各ケースの計算量は以下の通りです。最悪時間計算量O(