
データベースのライフサイクルとは?分析から保守までの5つのフェーズを解説
データベースのライフサイクルは、問題点と目的を分析・定義する段階から始まります。システム開発において、データベースがどのように計画され、構築され、運用されていくのかを理解することは、効率的な情報管理の基盤となります。
以下の図は、実現可能性調査(フィージビリティスタディ)を含む分析フェーズから始まるデータベースのライフサイクルを示したものです。
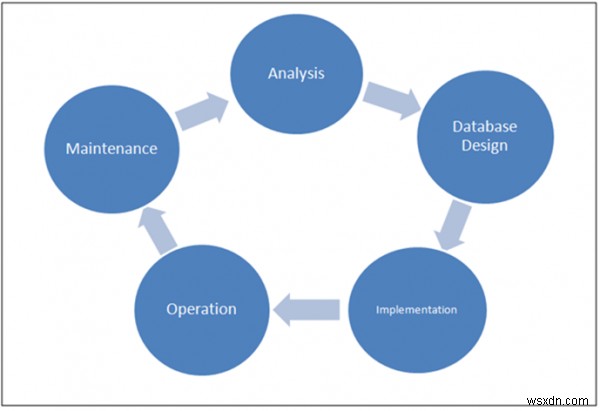
それでは、ライフサイクルを構成する各ステップを順番に見ていきましょう。
1. 分析(Analysis)
最初のフェーズでは、現在稼働しているシステムの動作状況を分析し、課題や問題点を明確に定義します。同時に、新システムが達成すべき目標(オブジェクティブ)もこの段階で策定します。ここでの分析の質が、後続のすべての工程に影響を与えるため、非常に重要なステップです。
2. データベース設計(Database Design)
設計フェーズでは、最終的な成果物がユーザーの要求とシステム要件を満たせるよう、具体的な設計作業を行います。テーブル構造、データ型、インデックス、リレーションシップなどを決定し、性能と拡張性の両立を目指します。
3. 実装(Implementation)
実装フェーズでは、設計仕様に基づいて実際にデータベースを構築します。スキーマの作成、アプリケーションの開発、テストなどを通じて、設計通りのシステムを形にしていきます。
4. 運用(Operation)
実装が完了すると、データベースは本番環境で稼働を開始します。ユーザーによるデータの登録・参照・更新などが日常的に行われ、システムが実際の業務を支える段階に入ります。
5. 保守(Maintenance)
最後のフェーズでは、DBA(データベース管理者)がバックアップやリカバリ(障害復旧)を含む保守作業を実施します。継続的な監視とチューニングを行うことで、データベースを安定した状態で長期的に運用できるようにします。必要に応じて、再び分析フェーズへ戻り、改善サイクルを回していくこともあります。
-
分散データベース管理システム(DDBMS)の主要な構成要素を解説
分散データベースとは分散データベースのデータは、複数の場所に分散して格納されています。つまり、データは同一拠点内の異なるシステムに保存されることもあれば、地理的に離れた複数のシステムに保存されることもあります。しかしながら、ユーザーから見れば、データベースはあたかも一つの統合された存在であるかのように振る舞います。データが複数の場所に保存されているという事実は、ユーザーに対して透過的(トランスペアレント)になっているのです。分散データベースの構成要素分散データベースは、主に以下の要素で構成されています。ユーザー(Users)グローバルスキーマ(Global Schema)データベースモジュール
-
データベースにおけるN項関係(N-ary Relationship)とは?種類と具体例を徹底解説
リレーションシップ(関係)とはリレーションシップ(関係)は、エンティティ関係図(ER図)を構成する重要な要素のひとつで、2つの異なるエンティティ間のつながりを表します。N項関係(N-ary Relationship)における「N」は、その関係に関与するエンティティの数を示しています。数自体は任意ですが、実務で特によく使われるのは、エンティティの数がそれぞれ1つ、2つ、3つである単項(unary)、2項(binary)、3項(ternary)の関係です。以下、それぞれの関係について詳しく見ていきましょう。単項関係(Unary Relationship)同じ種類のエンティティ同士に関係が成り立つ場