
Redisで実現するリアルタイム証券取引プラットフォームの構築――数百万口座に対応するデータモデル設計
ポートフォリオは、資産運用・ウェルスマネジメント業界の根幹を成す存在です。ハリー・マーコウィッツが現代ポートフォリオ理論を提唱して以来、資産運用の専門家たちは、一定のリスク水準におけるリターン最大化を追求し続けてきました。そして今日、この世界には何百万人もの個人投資家が参入し、投資の風景を一変させています。こうした新たなプレイヤーの台頭は、ネット証券会社、取引所、清算機関を支える取引インフラ技術に甚大な影響を及ぼしています。
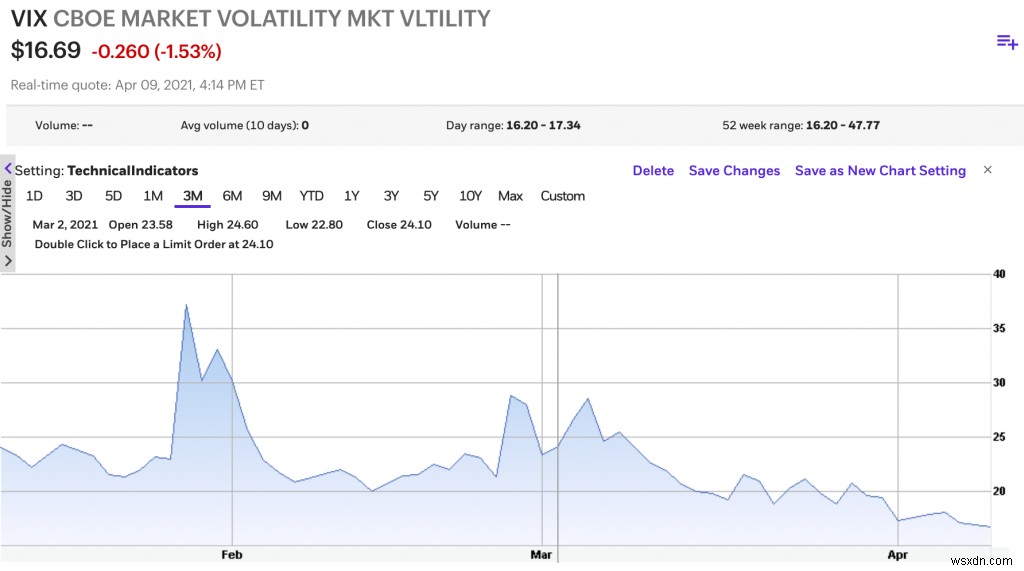
その象徴的な例が、2021年1月のGameStop株の狂騒です。個人投資家によるGameStop株の売買が記録的水準に達し、AMCエンターテインメントなどの「ミーム株」にも資金が殺到しました。VIX指数で測ると、わずか数取引日の間に市場全体のボラティリティが76%以上も上昇したのです。この異常な変動は数千銘柄に価格圧力をもたらし、何百万人もの投資家が同時に自らのポートフォリオへアクセスを試みる一方で、各社のアプリは需要に追いつけなくなりました。投資家は、いざというときに動作しないアプリに対して容赦ありません。
こうした混乱の中で、投資家が常にアクセスできることを求めるデータポイントは次の2つです。
- 現時点でのポートフォリオの総評価額はいくらか?
- 保有する個々の銘柄の損益はどうなっているか?
この2つの答えは、買い・売り・ホールドの判断材料となります。今のような高速化した市場では、わずかな遅延が機会損失や利益の喪失につながります。これらの問いに即答するにはリアルタイムの価格情報が必要ですが、そこには2つの大きな課題があります。
- 数千銘柄の価格を同時に更新すること
- 数百万件の顧客リクエストに同時対応すること
証券の価格は、出来高や個別銘柄・市場全体のボラティリティによって瞬時に変動します。一方、証券会社には数百万の顧客がおり、それぞれが数十銘柄を保有しているかもしれません。顧客がログインした瞬間にポートフォリオを最新価格へ更新し、取引所から価格を受信し続ける限りそれを維持しなければなりません。
要するに、これは「リアルタイムのチャート」を実現するということです。多くの証券アプリは大規模スケールでのこれを実現せず、数百万クライアントへ価格をプッシュするのではなく、最新価格をプルする方式を採っています。たとえば、ポートフォリオ画面に「更新ボタン」があるだけ、といった具合です。
この次世代の課題は容易ではなく、毎秒数百万オペレーションの処理を想定していないディスクベースのデータベースでは解決できません。金融業界の要件に応えるには、容易にスケールし、毎秒数億オペレーションを捌けるデータベースが必要です。ここで登場するのが、インメモリデータベースプラットフォームであるRedis Enterpriseです。本稿で扱う多様な課題に対する解決策となり得ます。
本記事は、金融業界におけるさまざまなリアルタイムユースケースを扱うシリーズの第1回です。各ユースケースの詳細とビジネス上の課題、そしてRedis Enterpriseがその解決に果たす役割を解説します。サンプル設計、データモデル、コード例を提示するとともに、各アプローチの長所・短所についても考察します。
今回の記事では以下を取り上げます。
- Redis Enterprise上で高性能かつスケーラブルな証券ポートフォリオデータモデルを実装するサンプル
- 取引所から受信した最新価格をもとに、ポートフォリオ内の銘柄価格をリアルタイム更新する仕組み
クライアントアプリがポートフォリオを取得し、最新価格を受け取れるようになれば、次のことが可能になります。
- ポートフォリオの総評価額の計算
- 保有銘柄ごとの損益計算
証券ポートフォリオのデータモデル
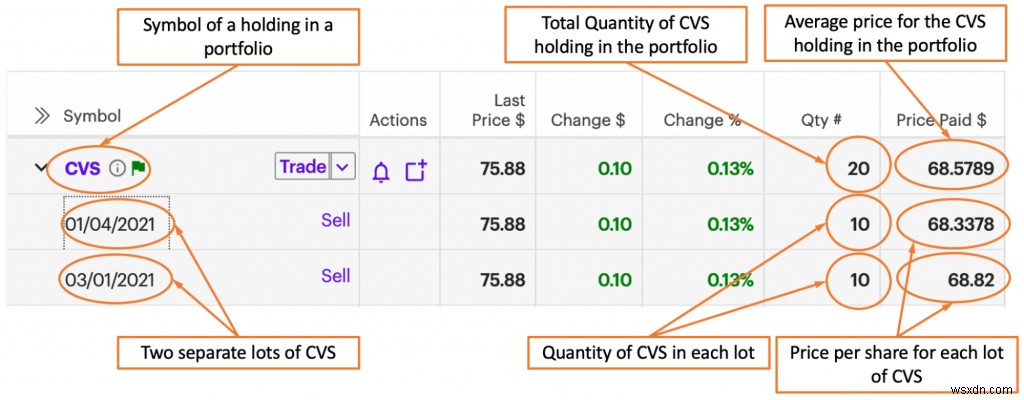
まず、ポートフォリオにおける「ロット(保有単位)」をモデル化しましょう。下図の例では、CVSヘルス(NYSE: CVS)が保有銘柄の一例です。CVSには2つの別個のロットがあり、1つ目は2021年1月4日に、2つ目は2021年3月1日に取得されました。いずれの買い取引でも同じ数量を購入しており、どちらも10株ですが、1株あたりの取得価格は1つ目が68.3378ドル、2つ目が68.82ドルと異なります。ポートフォリオにおけるCVSの合計保有数は20株となり、平均取得単価は (($68.3378 × 10) + ($68.82 × 10)) / 20 = 68.5789ドル/株 として計算されます。
要件の実装
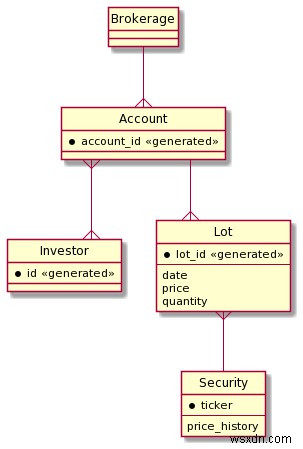
Redisのデータ表現はフラットであり、たとえばSetの中に別のSetを埋め込むことはできません。そのため、ER図で表現されたデータモデルをそのまま実装できるとは限りません。エンティティモデルを素直に実装しても、期待するパフォーマンス特性が得られない可能性があります。実装段階では少し発想を変える必要があります。本セクションでは、Redisで高性能かつスケーラブルな実装を行う際の基本的な設計原則を紹介します。
ここで扱うデータモデルには、次のエンティティが含まれます。
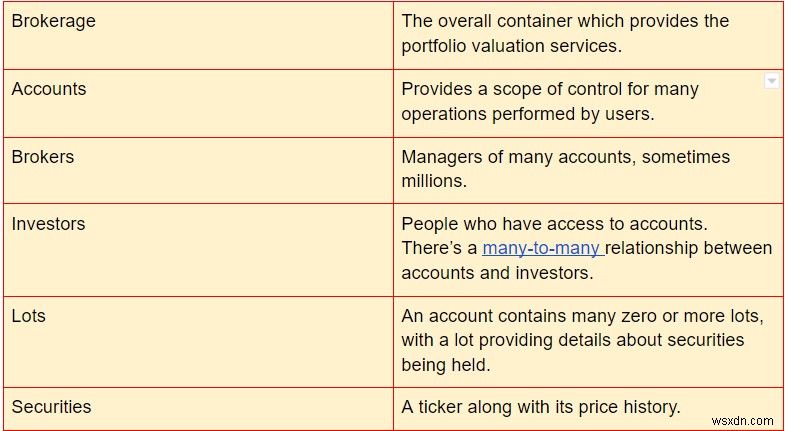
ER図は状況を視覚的に把握するのに役立ちます。ただし、上の図に欠けているのは流入する価格データ群(銘柄の価格履歴には記録されている)と、価格の変化に応じた瞬間的な評価額・損益の算出です。つまりER図が表しているのは、ポートフォリオ評価が行われる文脈となる、比較的静的なデータなのです。
システム全体のアーキテクチャ
このシステムについて考慮すべきポイントは以下の通りです。
- 即時性(レイテンシ)が極めて重要。これが全体を貫く最重要特性です。
- ポートフォリオ価値の計算は、口座固有データ(ロット情報)と口座間で共有されるデータ(証券価格)を組み合わせて行われる。口座固有データは共有データを利用するための文脈である。
- ポートフォリオ価値の計算が必要なのは、投資家がオンラインになっている口座のみ(全口座のごく一部)。
- データは、価格を生成する取引所から、オンライン投資家へポートフォリオ価値を表示するクライアント端末(ブラウザ、モバイルアプリ)へと流れる。
- 特にダイナミックに変動する領域は、入力データの流量とオンライン投資家の数。
これらを踏まえた一般的なアプローチは以下の通りです。
- Redisのインメモリアーキテクチャに依拠し、静的・動的両方のデータへの低レイテンシアクセスを実現する。
- Redisのデータ構造を活用したデータモデリングにより、緩やかに変化する文脈データへの高速アクセスを提供する。
- Redisの通信構造(Streams、Consumer Groups、Pub/Sub)を使って動的データの要件を処理する。
- システム全体のパフォーマンスに影響を与えない範囲で、必要最小限のデータだけを保持する。
- クライアント固有の計算はクライアント側で実行する。これはオンライン投資家の数に応じて自然かつ自動的にスケールし、スケール負荷を大幅に軽減する。
主要な計算コンポーネントとデータフローは以下の通りです。
なお、Redis Enterpriseは複数マシンにまたがる1つ以上のノードで構成され、オンプレミス、Kubernetes、ハイブリッドクラウド、マネージドサービス、あるいはファーストパーティのクラウドネイティブサービスとしてデプロイできます。そして数十万人の投資家が、各自の選んだクライアントでオンラインになることになります。
Redis Enterpriseのコンポーネント
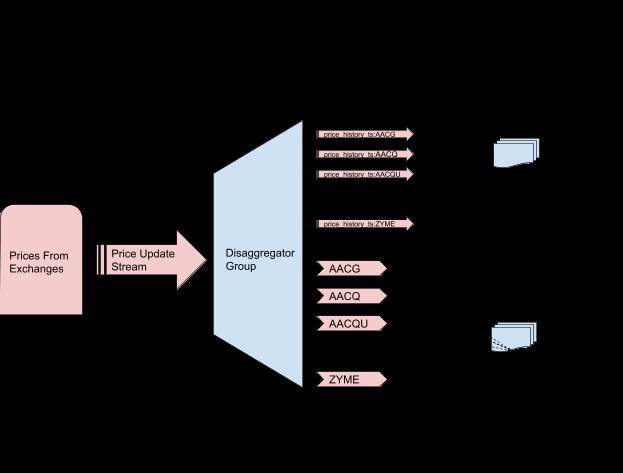
証券の価格更新はRedis Streamsによって受け入れられます。各銘柄の更新は1つのストリームに混在して流れてくるため、データを有用にするには分解が必要です。この分解にはコンシューマグループを使用し、銘柄ごとに2つの構造へデータを振り分けます。
- RedisTimeSeriesデータベース:価格変更履歴の追跡(接続直後のクライアント向けに最新価格の提供も兼ねる)
- Pub/Subブローカーチャネル:当該チャネルを購読しているクライアント(=その銘柄をポートフォリオに含む投資家)へ価格変更通知をプッシュ
この部分のアーキテクチャ詳細は下図の通りです。
このモデルで最も重要なのは、ロットと関連銘柄を表す口座固有データです。ここでは、Redisにおけるデータモデリングの考え方(パフォーマンス重視)を示す例として、2つの実装方式を比較します。他の実装も可能ですが、本稿の目的はRedisでデータを実装する際の全体的な設計原則と思考プロセスを紹介することにあります。
具体例として、次の情報を使用します。
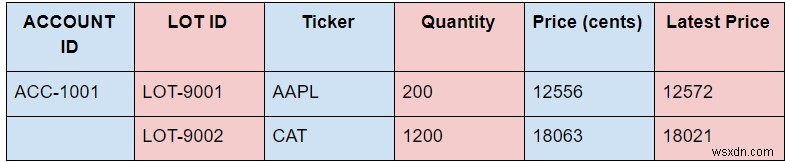
浮動小数点を避け、すべて整数で扱うため、可能な限り小さい通貨単位で価格を保持します。ドルとセントへの変換はクライアント側で行わせることができます。この例では小数点以下2桁の精度の価格を使用します。
データモデルA
最初の実装では、SET(アカウントIDで識別)を使って口座内の全ロットIDを記録し、さらにロットごとに1つのRedis HASH(LOT IDで識別)を用意し、フィールドとしてティッカー、数量、取得価格を格納します。言い換えれば、HASHでLOTエンティティの構造をモデル化し、LOTエンティティの各属性をRedis HASHのフィールドとして表現するのです。
このデータモデルでは、口座ごとのキーがあり、そのバリューとして当該口座の全LOT IDをRedis SETとして格納します。
lotids:<ACCOUNT_ID> SET <LOTID>
さらに、各lotidに対して、ティッカー・数量・取得価格をフィールドとするHASHを持たせます。
lot:<LOTID> HASH <ticker TICKER> <quantity INTEGER> <price INTEGER>
具体的には、次のようにキーを作成します。
127.0.0.1:6379> SADD lotids:ACC-1001 LOT-9001 LOT-9002
(integer) 2
127.0.0.1:6379> HMSET lot:LOT-9001 ticker AAPL quantity 200 price 12556
OK
127.0.0.1:6379> HMSET lot:LOT-9002 ticker CAT quantity 1200 price 18063
OK
RedisTimeSeriesモジュールは、時刻と値のペアの保存・取得を、大量挿入と低レイテンシ読み出しに対応させながら実現します。クライアントが利用する対象ティッカーの最新価格は、対応する時系列キーから取得します。
price_history:<TICKER> TIMESERIES <price INTEGER>
127.0.0.1:6379> TS.GET price_history:APPL
1) (integer) 1619456853061
2) 12572
127.0.0.1:6379> TS.GET price_history:CAT
1) (integer) 1619456854120
2) 18021
さらに、更新を受け取るために価格チャネルを購読します。
<TICKER> SUBSCRIPTION_CHANNEL
クライアントがすべてのデータを取得するには、次の操作を行います。
- lotidsキーに対してSMEMBERSを1回――時間計算量 O(N)(Nはロット数)
- lotキーに対してHGETALLをN回――時間計算量 N × O(1)
- price_historyキーに対してTS.GETをT回――時間計算量 T × O(1)(Tはティッカー数)
- <TICKER>チャネルに対してSUBSCRIBEを1回――時間計算量 O(T)(SUBSCRIBE 1回のコールですべてのチャネルを購読可能)
全体の時間計算量はO(N + T)となります。
具体的には、操作1と2は次のようになります。
127.0.0.1:6379> SMEMBERS lotids:ACC1001
1) "LOT-9001"
2) "LOT-9002"
127.0.0.1:6379> HGETALL lot:LOT-9001
1) "ticker"
2) "AAPL"
3) "quantity"
4) "200"
5) "price"
6) "12556"
127.0.0.1:6379> HGETALL lot:LOT-9002
1) "ticker"
2) "CAT"
3) "quantity"
4) "1200"
5) "price"
6) "18063"
ネットワークレイテンシを最小化するには、パイプライン(クライアント側でのバッチ処理の一種)や、Luaスクリプトの反復利用(SCRIPT LOAD & EVALSHA)を活用します。補足:トランザクションもパイプラインで実装でき、ネットワークレイテンシの削減効果はありますが、これはクライアント固有のものであり、本来の目的はサーバー側での原子性確保にあるため、ネットワークレイテンシ問題の真の解決策ではありません。パイプラインに含めるのは、入出力が互いに独立していなければならないコマンド群です。一方、Luaスクリプトではすべてのキーを事前に指定すること、かつすべてのキーが同一スロットにハッシュされることが求められます(詳細はRedis Enterpriseの公式ドキュメントを参照してください)。
これらの制約を踏まえると、操作のパイプラインへの割り当ては次のようになります。
- パイプライン1:操作#1の単一コマンド
- パイプライン2:操作#2の全Nコマンド
- パイプライン3:操作#3と#4の全Nコマンド
そして、操作ごとに使用するキーが異なり、共通部分がないため同一スロットにハッシュできない以上、Luaスクリプトの使用は不可能です。
このモデルでは、時間計算量はO(N+T)、ネットワークホップは3回となります。
データモデルB
代替案として、LOTエンティティ構造をフラット化し、各属性をアカウントIDで識別されるキーで表現する方式があります。ロットの各属性(数量、ティッカー、価格)ごとに1つのキーを用意します。各HASHのフィールドはLOT IDで、バリューは数量・ティッカー・価格のいずれかに対応します。つまり、次のキーを持つことになります。
tickers_by_lot: <ACCOUNT_ID> HASH <LOTID TICKER>
quantities_by_lot:<ACCOUNT_ID> HASH <LOTID INTEGER>
prices_by_lot:<ACCOUNT_ID> HASH <LOTID INTEGER>
これらのHASHは、データモデルAにおけるLOTIDとLOTのキーを置き換えます。price_historyおよび<TICKER>のキーは同じままです。
キーの作成:
HSET tickers_by_lot:ACC-1001 LOT-9001 AAPL LOT-9002 CAT
HSET quantities_by_lot:ACC-1001 LOT-9001 200 LOT-9002 1200
HSET prices_by_lot:ACC-1001 LOT-9001 12556 LOT-9002 18063
値の取得:
127.0.0.1:6379> HGETALL tickers_by_lot:ACC-1001
1) "LOT-9001"
2) "AAPL"
3) "LOT-9002"
4) "CAT"
127.0.0.1:6379> HGETALL quantities_by_lot:ACC-1001
1) "LOT-9001"
2) "200"
3) "LOT-9002"
4) "1200"
127.0.0.1:6379> HGETALL prices_by_lot:ACC-1001
1) "LOT-9001"
2) "12556"
3) "LOT-9002"
4) "18063"
クライアントが必要な操作は次の通りです。
- lot_quantityキーに対してHGETALLを1回――時間計算量 N × O(1)
- lot_tickerキーに対してHGETALLを1回――時間計算量 N × O(1)
- lot_priceキーに対してHGETALLを1回――時間計算量 N × O(1)
- price_historyキーに対してTS.GETをT回――時間計算量 T × O(1)(Tはティッカー数)
- <TICKER>チャネルに対してSUBSCRIBEを1回――時間計算量 1 × O(T)
全体の時間計算量はO(N+T)で、前述と同じです。
パイプラインの観点から見ると:
- パイプライン1:操作#1、#2、#3の全コマンド
- パイプライン2:操作#4と#5の全Tコマンド
つまり、ネットワークホップを1回削減できました。絶対値としては僅かですが、相対的には33%の改善です。
さらに、キーが既知であるためLuaスクリプトも簡単に使え、特定アカウントの全キーを同一スロットへマッピングできます。操作が単純なのでLuaの詳細には立ち入りませんが、この設計なら少なくともLuaの活用が可能だという点は注目に値します。
簡単なベンチマークでは、データモデルBの方が4.13ms速く実行されました(数千回の実行による計測)。ただし、これはクライアントが口座の初期化を行う際に一度だけ実行される処理なので、全体的なパフォーマンスへの影響はほぼ無視できるでしょう。
まとめ
本記事では、Redisのデータ型を用いたエンティティモデルの2つの実装方式を示しました。また、Redisのデータ型を選択する際には必ず行うべき時間計算量の分析と、ネットワークパフォーマンス改善の検討についても紹介しました。大規模かつ高性能が要求される場面では、これは極めて重要なステップです。今後の記事では、データモデルを拡張しながら、これらのアイデアをさらに掘り下げていきます。
今回は、大規模な証券ポートフォリオ管理におけるビジネス課題の一部を取り上げ、以下を示しました。
- リアルタイムかつスケーラブルな証券ポートフォリオを実現するRedisデータモデル
- ポートフォリオ総評価額と各保有銘柄の損益を算出できる高性能なリアルタイム価格更新システム
この2つの重要機能が揃えば、証券会社のクライアントアプリは、数百万口座に対応するパフォーマンスとスケーラビリティで、リアルタイムのポートフォリオ更新を提供できます。ポートフォリオの総評価額も、保有銘柄ごとの損益も、リアルタイムに表示可能です。このデータモデルとアーキテクチャは、証券にとどまらず、暗号資産(クリプト)や広告取引所など、他のユースケースにも応用できます。
-
Cloudflare WorkersとRedisで実現するエッジコンピューティング活用術
エッジコンピューティングは、近年もっとも注目されている技術のひとつです。CDNがファイルをユーザーの近くに配置できるようにしたのと同じように、エッジコンピューティングはアプリケーションそのものをユーザーの近くで実行できるようにします。これにより、開発者はグローバルに分散され、高いパフォーマンスを発揮するアプリケーションを構築できるようになります。 Cloudflare Workersとステートレス性の課題 現在この分野をリードしている製品がCloudflare Workersです。コールドスタートのないサーバーレス実行環境を提供し、Cloudflareのグローバルネットワークを活かすことで、ア
-
Redis GEORADIUSBYMEMBERコマンドの使い方を実例付きで解説 – Redisチュートリアル
このチュートリアルでは、Redisに保存された地理空間データ(ジオスペーシャル値)の中から、特定の範囲内に含まれる要素を取得する方法を学びます。そのために使用するのが GEORADIUSBYMEMBER コマンドです。 GEORADIUSBYMEMBERコマンドとは GEORADIUSBYMEMBERコマンドは、キーに保存された地理空間値(ソート済みセット)のメンバーのうち、指定したメンバーの経度・緯度と半径の引数から算出される円形エリアの境界内にある1つ以上のメンバーを返すために使用します。このエリアは、指定したメンバーの経度・緯度を円の中心位置とし、指定した単位による半径を円の半径として計