
マージ可能優先度キュー(Meldable Priority Queue)とスキューヒープ(Skew Heap)徹底解説
マージ可能優先度キュー(Meldable Priority Queue)とは
定義
ランダム化マージ可能ヒープ(Randomized Meldable Heap)は、「ランダム化マージ可能プライオリティキュー」とも呼ばれるデータ構造で、優先度キューの一種です。その基盤となる構造はヒープ順序を満たす二分木ですが、二分木の形状に関する厳密な制約は設けられていない点が大きな特徴です。
ランダム化マージ可能ヒープの利点
- 類似のデータ構造と比べて、多くの実用上のメリットを持っています。
- 他のデータ構造と比較して、アルゴリズムがシンプルで理解しやすいアプローチを提供します。
- すべての操作が容易に実装でき、計算量に含まれる定数倍の係数も小さく抑えられます。
- バランス条件を維持する必要がなく、ノード内に親ポインタなどの補助情報(サテライト情報)を保持する必要もありません。
- さらに、この構造は最悪ケースにおいても良好な時間効率を示します。個々の操作の実行時間は、高い確率で対数時間 O(log n) に収まります。
スキューヒープ(Skew Heap)とは
スキューヒープ(自己調整ヒープ:self-adjusting heap とも呼ばれます)は、二分木として実装されるヒープデータ構造です。
スキューヒープの最大の利点は、通常の二分ヒープよりも高速にマージ(併合)できる点にあります。
二分ヒープとは異なり、構造的な制約が存在しないため、木の高さが必ず対数になるという保証はありません。
スキューヒープが満たすべき条件は、次の2つだけです。
- 一般的なヒープ順序(根が最小値であり、各部分木についても再帰的に同様の性質が成り立つこと)を維持する必要があります。ただし、平衡性(最下層以外のレベルがすべて埋まっていること)は要求されません。
- スキューヒープにおける基本操作は「マージ(Merge)」のみです。挿入(insert)や最小値の取り出し(extractMin())といった他の操作も、すべてマージ操作を利用して実装できます。
マージの具体例
まず、次のようなスキューヒープ1を用意します。
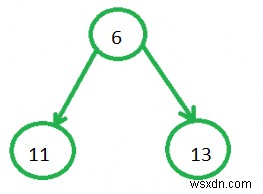
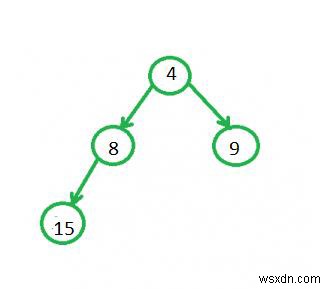
次に、マージ対象となる2つ目のヒープを以下と仮定します。
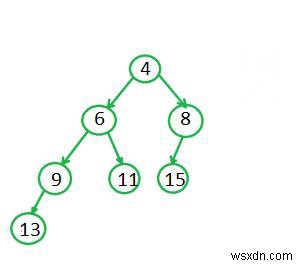
これら2つのヒープをマージすると、最終的に次のような木が得られます。
再帰的なマージ処理の手順
merge(a1, a2)
a1 と a2 を、マージ対象となる2つの最小スキューヒープとします。
a1 の根の値が a2 の根の値より小さいものとします
(そうでない場合は、a1 と a2 を入れ替えれば同じ条件にできます)。

手順:
1. a1->left と a1->right を入れ替える(swap)。
2. a1->left = merge(a2, a1->left) を再帰的に実行する。
このように、スキューヒープのマージは「右の子と左の子を入れ替えながら再帰的に統合する」というシンプルな手順で実現されます。左右の子を毎回入れ替えることで、木が偏って一方向に伸びることを防ぎ、ならし(amortized)計算量で対数時間の性能を実現しています。
-
ペアリングヒープとは?特徴・基本操作・計算量をわかりやすく解説
ペアリングヒープとは ペアリングヒープ(Pairing Heap)は、比較的シンプルな実装でありながら、実用上きわめて優れた償却性能(amortized performance)を発揮することで知られるヒープデータ構造の一種です。 ペアリングヒープは「ヒープ順序」を満たす多分木構造として定義され、簡略化されたフィボナッチヒープとみなすこともできます。 プリム法(Primの最小全域木アルゴリズム)のようなアルゴリズムを実装する際の「堅牢な選択肢」とされており、最小ヒープを前提とした場合、以下の操作をサポートします。 ペアリングヒープの主な操作 find-min(最小値の参照) − ヒープの先
-
Pythonのリストをスタックとキューとして使う方法を徹底解説
本記事では、Python 3.x(およびそれ以前のバージョン)におけるスタック(Stack)とキュー(Queue)という基本的なデータ構造について解説します。それぞれのデータ構造の仕組みや操作方法を、実際のコード例とともにわかりやすく学んでいきましょう。 本記事で扱う主なトピックは以下の通りです。 挿入操作(Push / Enqueue) 削除操作(Pop / Dequeue) 表示・走査(トラバース)操作 前提知識:リストとリスト操作の基礎関連するデータ構造:リスト操作 スタック(Stack)とは スタックでは、オブジェクトが積み重なるように格納され、取り出す際には到着した順序とは逆の順