
RedisリストとTypeScriptで独自のメッセージキューを構築する方法
自分専用のメッセージキューを作ろうとして、思わぬ壁にぶつかった経験はありませんか?もしそうなら、あなたは決して一人ではありません。このチュートリアルでは、Redisのリスト(List)を使ってメッセージキューをゼロから構築していきます。
Redisでメッセージキューを実装する方法には、Streams、Lists、Pub/Subなど複数の選択肢がありますが、本記事では最もシンプルで分かりやすい「リスト」方式に絞って解説します。それでは、実践的なガイドを見ていきましょう。
使用するもの
- Upstash
- 自分の手(と少しのやる気)
必要な環境
- Bun
- 自分の手
Upstash Redisのセットアップ
まずはRedisインスタンスを用意しましょう。Upstashにアクセスし、Create Databaseをクリックするだけで作成できます。その後、ページ下部にスクロールすると接続文字列(コネクションURL)が表示されるので、これを使ってクライアントから接続します。細かい手順は割愛しますが、基本的にはこれだけで準備完了です。
接続文字列の例:
redis://XXXXe@social-XXX-39281.upstash.io:39281プロジェクトの立ち上げ
TypeScriptプロジェクトはBunを使って初期化します。Bunを選ぶ理由は、Node.jsよりも高速であることだけでなく、セットアップが格段に簡単だからです。そしてもちろん、実行速度も驚異的です!🚀
mkdir upstash-mq
cd upstash-mq

bun init
> package name (upstash-mq-tutorial): upstash-mq
> entry point (index.ts):
> Done!

bun add ioredis
プロジェクト構成
 ┣ 📂src
 ┃ ┣ 📂lua-scripts
 ┃ ┃ ┣ 📜add-job.lua
 ┃ ┃ ┗ 📜remove-job.lua
 ┃ ┣ 📜index.ts
 ┃ ┣ 📜job.ts
 ┃ ┣ 📜queue.ts
 ┃ ┗ 📜utils.ts
 ┣ 📜.env
 ┣ 📜.gitignore
 ┣ 📜README.md
 ┣ 📜bun.lockb
 ┣ 📜index.ts
 ┣ 📜package.json
┗ 📜tsconfig.json完成したQueueクラスの全体像は以下のようなイメージになります。
Jobクラスの実装
Jobクラスには、いくつかの重要な要素が必要です。まず、各ジョブのステータスを追跡できるようにします。これにより、「処理すべきか」「再試行すべきか」「完了済みなら別の場所へ移動すべきか」を判断できます。また、各ジョブにはIDとデータを持たせます。データはジェネリック型にすることで、利用者にとって使いやすい設計になります。さらに、各ジョブがどのキューに属しているかを把握できるよう、親キューへの参照とキュー名も保持しておきます。
Jobクラスの骨格は次のとおりです。
type OwnerQueue = {
 redis: Redis;
 queueName: string;
};
export type JobStatuses =
 | "created"
 | "waiting"
 | "active"
 | "succeeded"
 | "failed";

export class Job<T> {
 id: string;
 status: JobStatuses;
 config: OwnerQueue;
 data: T;

 constructor(ownerConfig: OwnerQueue, data: T, jobId = randomUUID()) {
 this.id = jobId;
 this.status = "created";
 this.data = data;
 this.config = ownerConfig;
 }
}dataをジェネリックにするためには、まずJobクラス自体をジェネリックにする必要があります。あとは素直に実装を進めるだけです。ジョブごとに個別のRedisインスタンスを生成することも可能ですが、管理が非常に複雑になってしまいます。
幸い、今回のアプローチではRedisインスタンスをキュー側で一元管理でき、必要に応じて渡すだけで済みます。queueNameも同様の考え方です。ジョブをキューに保存する際に頻繁に使うため、ジョブ自身が親キューを知っている必要があります。
ジョブをキューに保存するために必要なものは2つ、Redisとやり取りするためのLuaスクリプトと、いくつかのユーティリティ関数です。
まずユーティリティから作成しましょう。
import { JobStatuses } from "./job";

const MQ_PREFIX = "UpstashMQ";

export const formatMessageQueueKey = (queueName: string, key: string) => {
 return `${MQ_PREFIX}:${queueName}:${key}`;
};

export const convertToJSONString = <T>(
 data: T,
 status: JobStatuses,
): string => {
 return JSON.stringify({
 data,
 status,
 });
};Redisを使うたびにキュー名を手動で組み立てるのは非効率なので、formatMessageQueueKeyというユーティリティを用意しました。単純に文字列を連結するだけの関数です。加えて、データをRedisに保存するにはシリアライズが必要です。JavaScriptのオブジェクトをそのまま渡すことはできないため、文字列へ変換する必要があります。データはジェネリックなので、ここでも汎用的な関数convertToJSONStringを実装しています。
続いて、最初のLuaスクリプトを追加しましょう。
add-job.lua
--[[
key 1 -> [prefix]:name:jobs
key 2 -> [prefix]:name:waiting
arg 1 -> job id
arg 2 -> job data
]]


local jobId = ARGV[1]
local payload = ARGV[2]

if redis.call("hexists", KEYS[1], jobId) == 1 then return nil end
redis.call("hset", KEYS[1], jobId, payload)
redis.call("lpush", KEYS[2], jobId)

return jobId
これらの操作は、Redisクライアントから個別に呼び出すこともできます。
redis.hexists(jobId)redis.hset(jobId,payload)redis.lpush(jobId,payload)
しかしこの方法では3回の個別コールが発生してしまいます。Redisサーバーとのラウンドトリップを最小限に抑えるため、一連の処理を1回のコールにまとめたいところです。
save()メソッドの追加
 private createQueueKey(key: string) {
 return formatMessageQueueKey(this.config.queueName, key);
 }

 async save(): Promise<string | null> {
 const addJobToQueueScript = await Bun.file("./src/lua-scripts/add-job.lua").text();
 const resJobId = (await this.config.redis.eval(
 addJobToQueueScript,
 2,
 this.createQueueKey("jobs"),
 this.createQueueKey("waiting"),
 this.id,
 convertToJSONString(this.data, this.status)
 )) as string | null;

 if (resJobId) {
 this.id = resJobId;
 return resJobId;
 }
 return null;
}コードはシンプルですが、少し補足しておきます。Luaスクリプトを作成したら、redis.evalを使って呼び出します。Luaスクリプトの実行には必須のメソッドです。redis.evalの引数は次のとおりです。
- 第1引数:実行するスクリプト本体
- 第2引数:キーの数
- 第3・第4引数:キー名
- 最後に:実際の引数(ARGV)
Jobクラスを完成させる前に、将来のためにメソッドをもう2つ追加しておきます。
fromId = async <T>(jobId: string): Promise<Job<T> | null> => {
 const jobData = await this.config.redis.hget(this.createQueueKey("jobs"), jobId);
 if (jobData) {
 return this.fromData<T>(jobId, jobData);
 }
 return null;
 };

private fromData = <T>(jobId: string, stringifiedJobData: string): Job<T> => {
 const parsedData = JSON.parse(stringifiedJobData) as Job<T>;
 const job = new Job<T>(this.config, parsedData.data, jobId);
 job.status = parsedData.status;
 return job;
};現時点ではこれらの関数は不要に見えるかもしれませんが、今後ジョブを処理し始める段階で非常に重要になります。その時点で手元にあるのはジョブのID(jobId)だけなので、ゼロからJobインスタンスを復元する手段が必要になります。まさにfromIdがその役割を担います。Redisからジョブデータを取得し、Jobインスタンスに変換して返すことで、キュー側が後続の処理を行えるようになります。
Queueクラスの実装へ
save()の実装が完了したので、次はQueueクラスの詳細に入りましょう。目標は以下のとおりです。
- 成功・失敗時にデータを保持するか削除するかを選択できるようにする(後で再処理したいケースもあるため)
- 複数のジョブを同時実行できるよう、並行処理(コンカレンシー)を考慮した設計にする
- データ処理用のコールバック関数を渡せるようにし、ジョブの型を自動推論させることで開発者体験を向上させる
- Queue内から
Job.save()を呼び出せるよう、RedisインスタンスとqueueNameを受け渡せるようにする - 必要に応じてキュー全体を破棄したり、特定のジョブを削除したりできるようにする
Queueクラスの定義から始めましょう
export type QueueConfig = {
 redis: Redis;
 queueName: string;
 keepOnSuccess?: boolean;
 keepOnFailure?: boolean;
};

export class Queue extends EventEmitter {
 config: QueueConfig;
 concurrency = 0;
 worker: any;
 running = 0;
 queued = 0;

 constructor(config: QueueConfig) {
 super();
 this.config = {
 redis: config.redis,
 queueName: config.queueName,
 keepOnFailure: config.keepOnFailure ?? true,
 keepOnSuccess: config.keepOnSuccess ?? true,
 };
 }

 createQueueKey(key: string) {
 return formatMessageQueueKey(this.config.queueName, key);
 }
}
Queueクラスは、キュー名、Redisインスタンス、データ保持/削除の設定といった外部からの情報を受け取るconfigを持ちます。Redisの実装は利用者が好みのものを選べるようにしていますが、私たちはUpstashが特にお気に入りです😌。この柔軟性により、既存システムへの組み込みも容易になります。
また、このクラスはEventEmitterを継承しており、何らかのイベントが発生した際に利用者へ通知できるようになっています。
初期化の例:
const queue = new Queue({
 redis: new Redis(process.env.UPSTASH_REDIS_URL),
 queueName: "upstash-rocks",
 keepOnFailure: true,
 keepOnSuccess: true,
});
addメソッド
async add<T>(payload: T) {
 return new Job<T>(this.config, payload).save();
}
addメソッドは、親キューの設定情報とペイロード(Redisに保存されるデータ)を受け取り、ジョブを生成して保存します。
これで次のように書けるようになりました。
const queue = new Queue({
 redis: new Redis(process.env.UPSTASH_REDIS_URL!),
 queueName: "mytest-queue",
 keepOnFailure: true,
 keepOnSuccess: true,
});

const payload = {
 upstash: "best-redis-ever",
};

await queue.add(payload);
次に必要なのは、これらのジョブを処理する仕組みです。
ジョブの処理(Processing)
ここがキューライブラリ実装の中で最も難しい部分です。利用者には同時実行数の指定とワーカー――ジョブの型を推論できるコールバック関数――の提供を求めます。さらに、現在実行中・待機中のジョブ数を追跡する仕組みが必要で、これにより安全に次のジョブをキューから取り出せるようになります。
 async process<TJobPayload>(
 worker: (job: TJobPayload) => void,
 concurrency: number
 ): Promise<void> {
 this.concurrency = concurrency;
 this.worker = worker;
 this.running = 0;
 this.queued = 1;

 this.jobTick();
}ジェネリック型TJobPayloadを受け入れる主な目的は、利用者の開発者体験を向上させることです。キューを使用する際にIntelliSense(補完機能)の恩恵を受けられるようにしたいのです。利用者は{hello: "world"}のようなデータをジョブに保存したことを知っていますが、TypeScriptが正確な補完を提供するには支援が必要です。この仕組みがあることで、TypeScriptに型を伝え、推論させることができるのです。
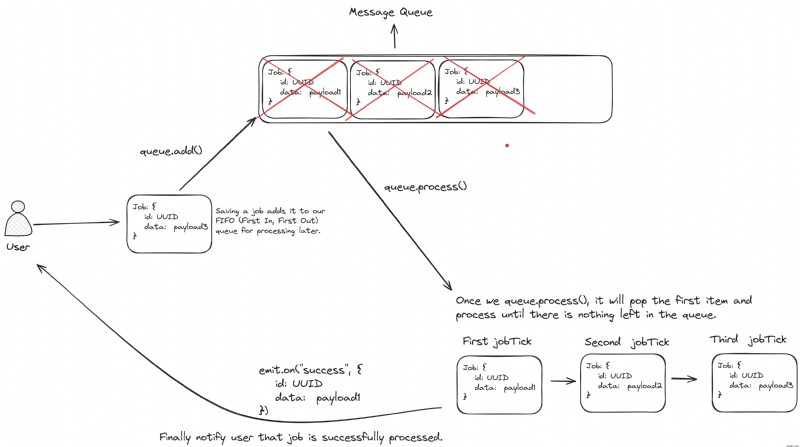
jobTick()に進む前に、処理の流れをしっかり整理しておきましょう。
- キューはFIFO(先入れ先出し)で動作するため、まずキューの右端からジョブをポップします。
- 次に、そのジョブに対してワーカー関数を実行します。
- ジョブが完了したら、結果を利用者へemit(通知)します。
- 最後に
jobTick()を再度呼び出して、次のジョブを処理します。
したがって、jobTick()はこの3つの重要なパートで構成されます。
private jobTick() {
 this.getNextJob()
 .then(async (jobId) => {
 this.running += 1;
 this.queued -= 1;
 if (this.running + this.queued < this.concurrency) {
 this.queued += 1;
 setImmediate(this.jobTick);
 }

 if (!jobId) {
 return;
 }

 const jobCreatedById = await new Job(this.config, null).fromId(jobId);
 if (jobCreatedById) {
 await this.executeJob(jobCreatedById);
 } else {
 console.error(`Job not found with ID: ${jobId}`);
 }
 })
 .catch((error) => {
 console.error("Error in jobTick:", error);
 })
 .finally(() => {
 setImmediate(() => this.jobTick());
 });
}関数ごとに順番に説明していきます。まずはgetNextJob()からです。
 private async getNextJob() {
 try {
 const jobId = await this.config.redis.brpoplpush(
 this.createQueueKey("waiting"),
 this.createQueueKey("active"),
 0
 );
 return jobId;
 } catch (error) {
 console.error("Error fetching the next job:", error);
 throw error;
 }
 }
これは単なるRedisへのコールですが、戦略的な工夫が凝らされています。ブロッキングコールとlpushを組み合わせることで、ラウンドトリップの回数を最小限に抑えています。ブロッキングコールを使う意図は明確で、他のワーカーが同じジョブを同時に処理することを防ぎ、レースコンディションを回避するためです。また、ジョブを「waiting」状態から「active」状態へ移動させることで、後続のステップに備えます。
this.getNextJob().then(async (jobId) => {
 this.running += 1;
 this.queued -= 1;
 if (this.running + this.queued < this.concurrency) {
 this.queued += 1;
 setImmediate(this.jobTick);
 }

 if (!jobId) {
 return;
 }

 const jobCreatedById = await new Job(this.config, null).fromId(jobId);
 if (jobCreatedById) {
 await this.executeJob(jobCreatedById);
 } else {
 console.error(`Job not found with ID: ${jobId}`);
 }
});jobIdを取得したら、実行中ジョブのカウントを1増やし、待機中ジョブのカウントを1減らします。同時に、同時実行数の上限を守りつつ、可能な限り多くの新しいジョブを起動しようとします。
if (this.running + this.queued < this.concurrency) {
 this.queued += 1;
 setImmediate(this.jobTick);
}問題なければ、fromIdを使ってJobインスタンスを復元します。IDからジョブの復元に成功したら、ワーカー関数でジョブを実行します。
次はexecuteJobです。
private async executeJob<TJobPayload>(jobCreatedById: Job<TJobPayload>) {
 let hasError = false;
 try {
 await this.worker(jobCreatedById.data);
 this.running -= 1;
 this.queued += 1;
 } catch (error) {
 hasError = true;
 } finally {
 const [jobStatus, job] = await this.finishJob<TJobPayload>(jobCreatedById, hasError);
 this.emit(jobStatus, job.id);
 return;
 }
}ジョブのデータが手に入ったので、それをworkerに渡します。正常に実行されれば、待機中ジョブのカウントを1増やし、実行中ジョブのカウントを1減らします。このステップは非常に重要で、正しく扱わないと新しいジョブを並行して起動できなくなる可能性があります。ワーカーの実行中にエラーが発生した場合は、単純にhasErrorフラグを立てます。最後に、finishJobにjobCreatedByIdとhasErrorフラグを渡して呼び出し、ステータスとjobIdをemitします。
補足:利用者はこのようにしてイベントを購読できるようになります。
queue.on("succeeded", (jobId) => console.log("Succeeded jobId", jobId));続いてfinishJobです。
private async finishJob<TJobPayload>(
 job: Job<TJobPayload>,
 hasFailed?: boolean
 ): Promise<[JobStatuses, Job<TJobPayload>]> {
 const multi = this.config.redis.multi();

 multi.lrem(this.createQueueKey("active"), 0, job.id);

 if (hasFailed) {
 if (this.config.keepOnFailure) {
 multi.hset(this.createQueueKey("jobs"), job.id, convertToJSONString(job.data, job.status));
 multi.sadd(this.createQueueKey("failed"), job.id);
 } else {
 multi.hdel(this.createQueueKey("jobs"), job.id);
 }
 job.status = "failed";
 } else {
 if (this.config.keepOnSuccess) {
 multi.hset(this.createQueueKey("jobs"), job.id, convertToJSONString(job.data, job.status));
 multi.sadd(this.createQueueKey("succeeded"), job.id);
 } else {
 multi.hdel(this.createQueueKey("jobs"), job.id);
 }
 job.status = "succeeded";
 }

 await multi.exec();
 return [job.status, job];
}ここでの重要ポイントはmulti()の使用です。常にラウンドトリップを最小化したいからです。multiを使うと、Redisはexec()を呼ぶまで実行を遅延させます。利用者がkeepOnFailureやkeepOnSuccessを設定してデータを保持する場合は、ジョブのデータを持つハッシュと、そのデータへアクセスするためのジョブIDリスト(Set)の2つを作成します。これは成功・失敗のどちらの場合でも同じ考え方です。当然ながら、ジョブのステータスも適切に更新します。最後にexecでmultiコマンドを実行し、イベント発火のためにジョブのステータスとジョブ本体を返します。
最後に残り2つのメソッドがありますが、すでに説明済みの概念の組み合わせなので、詳しい解説は割愛します。
 async removeJob(jobId: string) {
 const addJobToQueueScript = await Bun.file("./src/lua-scripts/remove-job.lua").text();
 return await this.config.redis.eval(
 addJobToQueueScript,
 5,
 this.createQueueKey("succeeded"),
 this.createQueueKey("failed"),
 this.createQueueKey("waiting"),
 this.createQueueKey("active"),
 this.createQueueKey("jobs"),
 jobId
 );
 }

 async destroy() {
 const args = ["id", "jobs", "waiting", "active", "succeeded", "failed"].map((key) =>
 this.createQueueKey(key)
 );
 const res = await this.config.redis.del(...args);
 return res;
 }
remove-job.lua
--[[
key 1 -> [prefix]:test:succeeded
key 2 -> [prefix]:test:failed
key 3 -> [prefix]:test:waiting
key 4 -> [prefix]:test:active
key 5 -> [prefix]:test:jobs
arg 1 -> jobId
]]

local jobId = ARGV[1]

if (redis.call("sismember", KEYS[1], jobId) + redis.call("sismember", KEYS[2], jobId)) == 0 then
 redis.call("lrem", KEYS[3], 0, jobId)
 redis.call("lrem", KEYS[4], 0, jobId)
end

redis.call("srem", KEYS[1], jobId)
redis.call("srem", KEYS[2], jobId)
redis.call("hdel", KEYS[5], jobId)
destroy()はキュー全体を完全に消去するためのもので、もう一方はキューから特定のジョブを削除するためのものです。
すべてを実際に動かしてみる
import { sleep } from "bun";
import Redis from "ioredis";

import { Queue } from "./queue";

type Payload = {
 id: number;
 data: string;
};

const queue = new Queue({
 redis: new Redis(process.env.UPSTASH_REDIS_URL),
 queueName: "mytest-queue",
});

async function main() {
 await generateQueueItems(queue, 20);
 console.log("Sleep starting for 5 sec");
 await sleep(5000);

 queue.on("succeeded", (jobId) => console.log("Succeeded jobId", jobId));
 await queue.process<Payload>((job) => {
 console.log("Processing job:", job.data);
 sleep(1000);
 }, 3);
}

main();

async function generateQueueItems(queue: Queue, itemCount: number) {
 for (let i = 0; i < itemCount; i++) {
 const payload = {
 id: i,
 data: `dummy-data-${i}`,
 // テストに応じてプロパティを追加してください
 };
 const jobId = await queue.add(payload);
 console.log(`Added item ${i} with jobId: ${jobId}`);
 }
}
発展課題(ボーナスチャレンジ)
- Redisアクセスとワーカー処理の両方に対して、指数バックオフによるリトライロジックを実装してみよう
- 「少なくとも一度(at least once)」保証の仕組みを開発してみよう
- パフォーマンス向上のため、Service Workerでワーカーを実行してみよう
- スケジュールされたジョブ(遅延実行)を追加してみよう
まとめ
何かを学ぶ最良の方法は実際に作ってみることです。そして、それをUpstash Redisで行えば、さらに学びが深まります。それでは、Happy Coding!
🔗 プロジェクトのGitHubリポジトリはこちら
-
Redisハッシュ入門 – データストア内のハッシュ値を操作する主要コマンド15選
Redisにおけるハッシュ(Hash)は、フィールド名と値のペアを格納できるマップ構造です。Javaのオブジェクトのように、複数の属性を持つデータをひとつのキーで表現できるため、ユーザー情報や商品データなどの管理に非常に便利です。 Redisでは、ハッシュをキーの値として保存でき、保存・管理・取得のためのコマンドが多数用意されています。コマンドの基本構文は以下の通りです。 基本構文 redis host:port> <コマンド名> <キー名> 実行例 Redisハッシュ操作の主なコマンド一覧 Redisデータベースでハッシュ値を管理するための重要なコマンドを、以
-
Next.js にリアルタイム機能を2分で追加できる「Upstash Realtime」とは
Next.js へのリアルタイム機能追加は、なぜこんなに大変なのか 💀 ここでいうリアルタイム機能とは、たとえば次のようなものです。 Vercel AI SDK のリアルタイムストリーミング ライブダッシュボード リアルタイム通知やステータス更新 ライブカーソルや「現在オンライン」のユーザー表示 ファイルアップロードや長時間実行タスクの進捗トラッキング こうした用途に特化した SaaS が存在しないわけではありません。むしろ、すでに複数のサービスが提供されています。しかし、どれも一長一短がありました。 Ably: 料金が高く、価格体系もわかりにくい Pusher: 型安全ではなく、開発