
Redisキャッシュでグローバルデータベースのパフォーマンスを高速化する方法
ソフトウェアアプリケーションの価値は、顧客のニーズにどれだけ応えられるかによって決まります。顧客のニーズを考えるとき、最初に求められるのがアプリケーションの速度とデータの信頼性です。しかし、アプリケーションが成長しグローバルに展開されるにつれて、クエリ量の増加、レイテンシの上昇、地理的に分散したユーザーベースにより、SQLデータベースがパフォーマンスのボトルネックになることが少なくありません。
アプリケーションの成長に伴うこれらの課題に対処するため、まず検討すべき解決策の一つがキャッシュです。キャッシュを導入することで、繰り返されるクエリによるプライマリデータベースへの負荷を軽減し、ユーザーがクエリを送信した際のレイテンシを下げることができます。キャッシュといえば、誰もが同じツールを思い浮かべるのではないでしょうか。そう、Redisです。Redisはデータをキャッシュして負荷を軽減し、アプリケーションを高速化するのに最適なツールです。さらにUpstashは、グローバルに分散されたRedisレプリケーションを提供しており、通常のキャッシュよりもはるかに高速なアプリケーションを実現できます。
この記事では、Global RedisとSQLデータベースを統合する技術的なメリットを探り、レイテンシとスケーラビリティへの影響について考察した上で、PostgreSQLおよびMySQLでGlobal Redisを使用する実践的な例を紹介します。
キャッシュのメリット
まず、なぜキャッシュを使うべきなのかを見ていきましょう。
この記事で取り上げるキャッシュの主なメリットは2つあります。データベース負荷の軽減と、ユーザーへのレイテンシ低減です。
データベース負荷の軽減
SQLデータベースは構造化データや複雑なクエリの管理に優れていますが、高負荷状態ではボトルネックになりがちです。商品詳細、ユーザープロフィール、頻繁にアクセスされる設定など、同じデータに対する大量の重複クエリは、CPUとI/Oリソースを大きく消費します。これらの結果をキャッシュすることで、データベースに到達するクエリ数を大幅に減らし、トランザクション処理や更新といったより重要なタスクにデータベースのリソースを集中させることができます。
具体例を挙げます。
- キャッシュなしの場合: Webサイトの人気機能が毎日数百万件もの同一のデータベースクエリを生成し、他の操作のパフォーマンスを低下させます。
- キャッシュありの場合: 頻繁にアクセスされるクエリ結果をRedisのような高速キャッシュに保存することで、データベースへのクエリ率を90%以上削減できます。
レイテンシの低減
データベース負荷の軽減は、システムの健全性を保ちデータの信頼性を確保するためのものでした。キャッシュはまた、ユーザーのリクエストやクエリにかかる時間も改善します。
アプリケーションが同じデータについて何度もデータベースにクエリを発行すると、データ取得には常に時間がかかります。特にこれらのクエリがデータベースに大きな負荷をかけている場合、遅延はさらに悪化します。これは、リアルタイムのデータアクセスが必要なアプリケーションや、大量のクエリを処理するアプリケーションにとって特に深刻な問題であり、わずかな遅延でもパフォーマンスに大きな影響を与えます。
キャッシュは、頻繁にアクセスされるデータをメモリに保存することでこの問題を解決します。メモリからの取得は、データベースへのクエリよりもはるかに高速です。繰り返されるリクエストにおけるデータベースクエリへの依存を減らすことで、ネットワークの往復を最小限に抑え、複雑なクエリ実行による計算オーバーヘッドを回避できます。その結果、レスポンスタイムは劇的に改善され、高負荷時や分散環境においても、アプリケーションはより速く一貫性のあるパフォーマンスを提供できるようになります。
一般的なキャッシュ戦略
アプリケーションのパフォーマンス最適化で使われる2つの主要なキャッシュ戦略、キャッシュアサイド(cache-aside)とライトスルー(write-through)を理解することも重要です。それぞれのアプローチには、アプリケーションの要件に応じたユースケースとトレードオフがあります。
キャッシュアサイドは最も一般的なキャッシュ手法です。この手法では、アプリケーションがまずキャッシュからデータを確認します。データがキャッシュに存在しない場合(キャッシュミス)、データベースからデータを取得し、今後の利用に備えてキャッシュに書き込みます。
以下は、キャッシュアサイドの仕組みを示す簡単な図です。この記事を読む前に、どこかで見たことがある方も多いかもしれません。
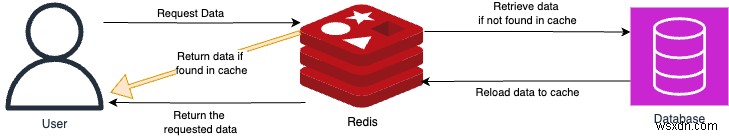
このキャッシュ方式の利点は、キャッシュサイズが最適化され、必要に応じてユーザーの要求に応じてキャッシュデータが再読み込みされる点です。一方、欠点としては、TTL(有効期限)が切れてキャッシュがクリアされるとデータが利用できなくなる点が挙げられます。その場合、ユーザーがそのデータを要求したときにキャッシュが再読み込みされます。このとき、そのユーザーはクエリの完了を待つ必要があります。ただしもちろん、次回以降のリクエストでは再びキャッシュからデータを取得できるようになります。
ライトスルー戦略では、データベースへのすべての書き込み操作が即座にキャッシュにも書き込まれます。これにより、キャッシュは常にデータベースの最新データと同期された状態になります。
以下は、ライトスルーキャッシングの簡単な図です。
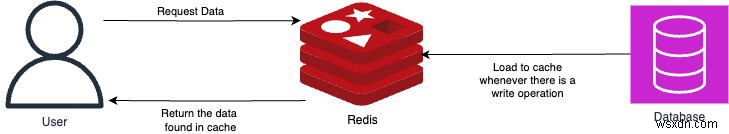
この戦略では、キャッシュとデータベース間のデータ整合性が保証され、ユーザーからのリクエストを待つことなくデータが既に利用可能になっているため、どのリクエストも高いレイテンシを経験しません。しかし、欠点としては、必要かどうかに関わらずすべてのデータがキャッシュに含まれる点があります。さらに、すべての書き込み操作でキャッシュにもデータが書き込まれるため、書き込み時にレイテンシが発生します。
Global Redisとは?Global Redisのメリット
次に、SQLデータベースのパフォーマンスをさらに改善する方法を見ていきましょう。
レイテンシのもう一つの原因は、データベースの所在地です。多くの場合、プライマリデータベースは特定のリージョンに配置されています。しかし、データストアまでの距離による遅延を最小限に抑えるには、データに最も近い場所からアクセスできるようにする必要があります。
この問題は、Upstashが提供するグローバル分散型Redisを使用することで防ぐことができます。
Global Redisは、複数の地理的なロケーションにデータをレプリケートする分散キャッシュソリューションであり、グローバルに分散したアプリケーションに低レイテンシのアクセスを保証します。
それでは、Global Redisの作成方法を簡単に見てみましょう。まず、Upstashコンソールにログインします。
ログイン後、ここでRedisデータベースを作成できます。Upstashは、読み取りレプリカを配置できる複数のロケーションを提供しています。
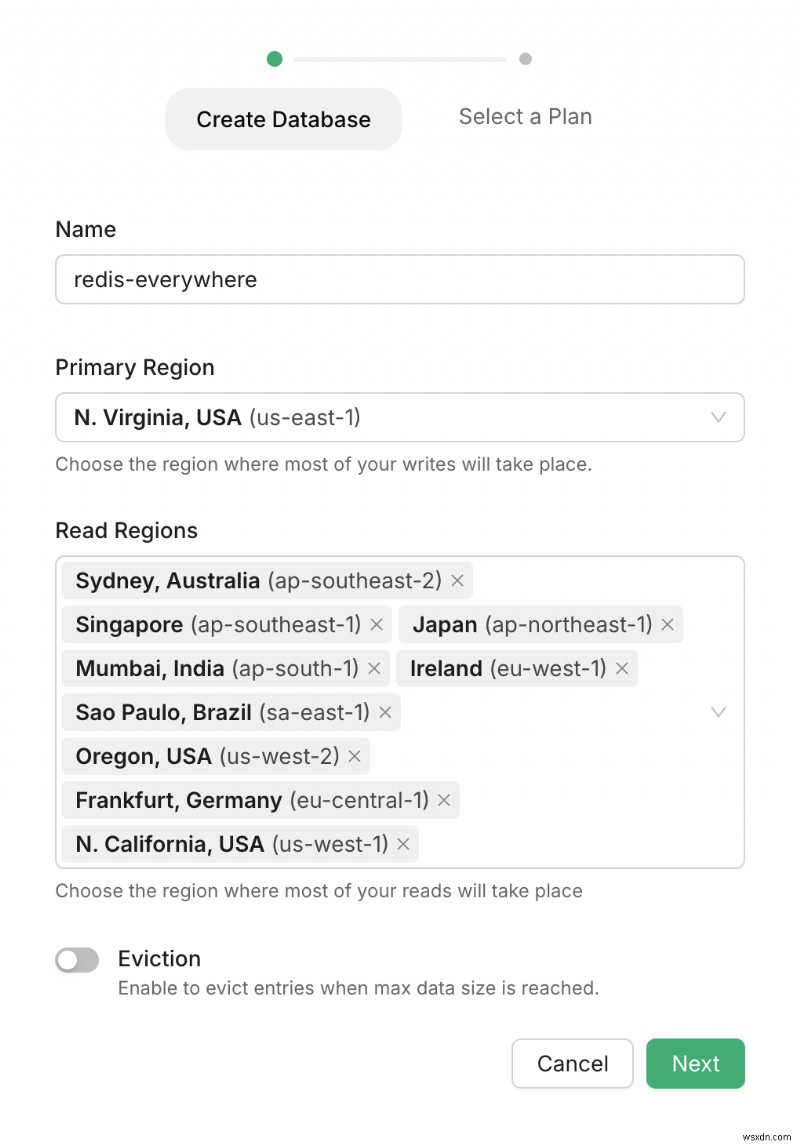
読み取りロケーションを選択したら、プランを選択し、最後にRedisデータベースを作成します。以上で完了です!
コンソールでは、データベース作成後でもリージョンの追加・削除が可能です。
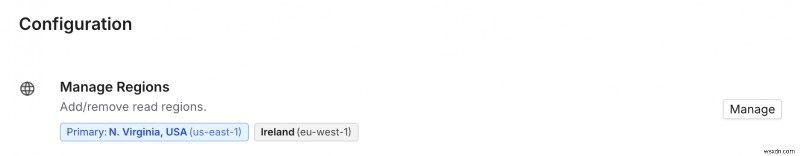
Global Redisデータベースは、主にグローバルに分散しているアプリケーションや、エッジで動作するアプリケーションで利用されています。
グローバル分散アプリケーションにおける低レイテンシ
グローバルに分散したシステムでは、ユーザーと中央のデータベースやキャッシュとの物理的な距離により、レイテンシがボトルネックになることがよくあります。Global Redisは、複数の地理的に分散したノードにデータをレプリケートすることで、この問題に対処します。
ユーザーがデータをリクエストすると、最も近いキャッシュノードがリクエストに応答するため、ネットワークの移動時間が大幅に短縮されます。このローカライズされたアクセスにより、ユーザーの所在地に関係なく、高速なレスポンスタイムと一貫したユーザー体験が実現します。
例えば、ユーザーが東京にいる一方で、データベースがダブリンにある場合、その距離がレスポンスの遅延を引き起こします。しかし、Upstash Redisの読み取りレプリカがヨーロッパにあれば、リクエストは最も近い読み取りレプリカ、この場合はヨーロッパのレプリカにルーティングされます。
エッジランタイム(Cloudflare Workersなど)向けの低レイテンシデータ
エッジランタイムとは、エンドユーザーに近いネットワークのエッジでコードを実行するために設計された環境です。エッジランタイムは、アプリケーションロジックを世界中の複数のエッジロケーションに分散させます。このアーキテクチャにより、ユーザーとリクエスト実行地点との物理的な距離が最小化され、レイテンシが大幅に削減され、パフォーマンスが向上します。
エッジランタイムは計算をユーザーの近くに置きますが、ユーザー固有の情報、セッショントークン、設定などを取得するなど、ほとんどの操作では依然としてデータへのアクセスが必要です。キャッシュ層がない場合、各リクエストは依然として中央データベースへの往復を必要とし、レイテンシ削減のメリットの多くが失われてしまいます。ここでGlobal Redisが重要な役割を果たします。頻繁に使用されるデータをエッジにレプリケートすることで、低レイテンシのアクセスを保証します。
サンプルコード1:Node.jsとPostgreSQL
Global Redisでのキャッシングは非常に効果的です。次に、Upstash RedisとPostgreSQLデータベースでキャッシュアサイド戦略を実装するコードサンプルを見てみましょう。
まず、データストアへの接続に使用するSDKをインストールします。
npm install pg @upstash/redis
依存関係のインストールが完了したら、Upstash RedisとPostgresに接続できます。
const { Redis } = require('@upstash/redis'); // Upstash Redis SDK
const { Client } = require('pg');

const redis = new Redis({
 url: <UPSTASH_REDIS_REST_URL>,
 token: <UPSTASH_REDIS_REST_TOKEN>,
})

const client = new Client({
 user: 'username',
 password: 'password',
 host: 'host',
 port: 'port_number',
 database: 'database_name',
});

client.connect();
次に、データアクセス層に関数を記述します。この関数は、必要に応じて変更できます。
例えば、WebサイトでuserIdごとにユーザー情報を表示したいとしましょう。この場合、userIdを引数として受け取る関数が必要です。
async function getUserData(userId) {
 // 最初にキャッシュを確認
 const cachedData = await redis.get(userId);
 if (cachedData) {
 console.log('Cache hit');
 return JSON.parse(cachedData);
 }
 // キャッシュミスの場合はデータベースへフォールバック
 console.log('Cache miss');
 const query = 'SELECT * FROM users WHERE id = $1';
 const { rows } = await client.query(query, [userId]);
 await redis.set(userId, JSON.stringify(rows), { EX: 300 }); // 5分間キャッシュ
 return rows;
}
これで完成です!この関数は、まずリクエスターのリージョンに最も近いRedisデータベースにユーザー情報が存在するかどうかを確認します。存在しない場合は、PostgreSQLデータベースから要求されたデータをクエリし、返されたデータをUpstash Redisのプライマリリージョンに書き込みます。プライマリリージョンに書き込まれたデータは、自動的にすべての読み取りレプリカにコピーされます。
サンプルコード2:PythonとMySQL
次に、別の例を見てみましょう。今回は同じキャッシュ実装を行いますが、メインデータベースはMySQLです。また、Pythonベースのアプリケーションでどのように動作するかを確認するため、この関数をPythonで記述します。
いつものように、まずデータベースへの接続に使用する依存関係をインストールします。
pip install upstash-redis mysql-connector-python
次に、クライアントを初期化して接続します。
import upstash_redis
import mysql.connector
import json

# Upstash Redisクライアントの初期化
redis_client = upstash_redis.Redis(
 url='<your-upstash-redis-url>',
 token='<your-upstash-token>'
)

# MySQLクライアントの初期化
db = mysql.connector.connect(
 host="<your-mysql-host>",
 user="<your-mysql-user>",
 password="<your-mysql-password>",
 database="<your-database-name>"
)

cursor = db.cursor(dictionary=True)
接続の準備ができました。次に、前のセクションで実装したのと同様の関数を実装します。
def get_user_data(userId):
 # キャッシュからデータを確認
 cache_data = redis_client.get(key)
 if cache_data:
 print("Cache hit")
 return json.loads(cache_data)

 # キャッシュミスの場合はMySQLデータベースにクエリ
 print("Cache miss")
 cursor.execute("SELECT * FROM users WHERE key = %s", (userId))
 result = cursor.fetchone()
 if result:
 # TTLを1時間としてデータをキャッシュに保存
 redis_client.set(key, json.dumps(result), ex=3600)
 return result
まとめ
Global Redisをアーキテクチャに統合することで、特にグローバルに分散した環境において、SQLベースのアプリケーションで大幅なパフォーマンス向上を実現できます。低レイテンシのアクセス、データベース負荷の軽減、エッジランタイムとの互換性により、Global RedisはSQLデータベースを使用するアプリケーションのパフォーマンス課題に対応できます。
この記事では、Global Redisによるキャッシングのメリットを解説し、いくつかの実装例を見てきました。これらは基本的な例にすぎず、ニーズに応じてさらに拡張することが可能です。
この記事が、Global Redisの力を活用し始める良い出発点になれば幸いです。
-
RedisのRANDOMKEYコマンド徹底解説 – データストアからランダムなキーを取得する方法
このチュートリアルでは、redis-cliでRANDOMKEYコマンドを使用して、Redisデータストアに現在保存されているキーの中からランダムに1つ取得する方法を解説します。RANDOMKEYは、データベース内に存在するキーの中から任意の1つを選んで返すシンプルなコマンドです。キーの内容や値は返さず、キー名のみが返される点に注意してください。また、既存のキーやデータに対して一切の変更を加えないため、安全に利用できます。構文redis host:port> RANDOMKEY戻り値データストアから選ばれたランダムなキー名(文字列)データストアが空の場合は nil(null)使用例まず、い
-
Redis UNSUBSCRIBEコマンド徹底解説 – Pub/Subで複数チャネルの購読を解除する方法
このチュートリアルでは、redis-cliを使ってRedisメッセージブローカー(Pub/Sub)システム上の複数のチャネルから購読を解除する方法を解説します。 UNSUBSCRIBEコマンドとは UNSUBSCRIBEコマンドは、Redisメッセージブローカーシステムにおいて、クライアントを1つ以上の指定したチャネルから購読解除するために使用します。チャネルを何も指定しなかった場合は、そのクライアントが購読中のすべてのチャネルから一括で購読解除されます。また、購読解除された各チャネルごとにメッセージが1件ずつ返されます。 構文 RedisのUNSUBSCRIBEコマンドの基本構文は以下のとお