
RediSearch 2.0登場――インタラクティブな検索体験を備えたモダンアプリ構築を加速
RediSearch 2.0がついに一般提供開始
本日、Redis向けの強力なクエリ、インデックス作成、全文検索エンジン「RediSearch 2.0」の一般提供(GA)開始をお知らせします。2020年9月よりパブリックプレビューとして提供されてきたRediSearch 2.0は、モダンアプリケーションの構築から全文検索、リアルタイム分析まで、幅広いユースケースで採用する顧客を着実に増やしています。RediSearch 2.0はまったく新しいアーキテクチャを採用し、従来のRediSearch 1.6の2倍以上の処理速度を実現。さらに、Redis EnterpriseのActive-Active地理分散構成とRedis on Flashにも対応しました。
RediSearchが重要である理由
現代の組織では、大量の構造化データと非構造化データが日々生成されています。しかし、その多くはディスクベースの低速なデータベースに保存されており、モダンアプリケーションに求められるリアルタイム体験を支えられないのが実情です。RediSearchは、Redisのデータセットを簡単にインデックス化し、完全分散型でリアルタイムにクエリや集計を「Redisの速度」で実行できるようにすることで、こうしたパフォーマンスのボトルネックを解消します。
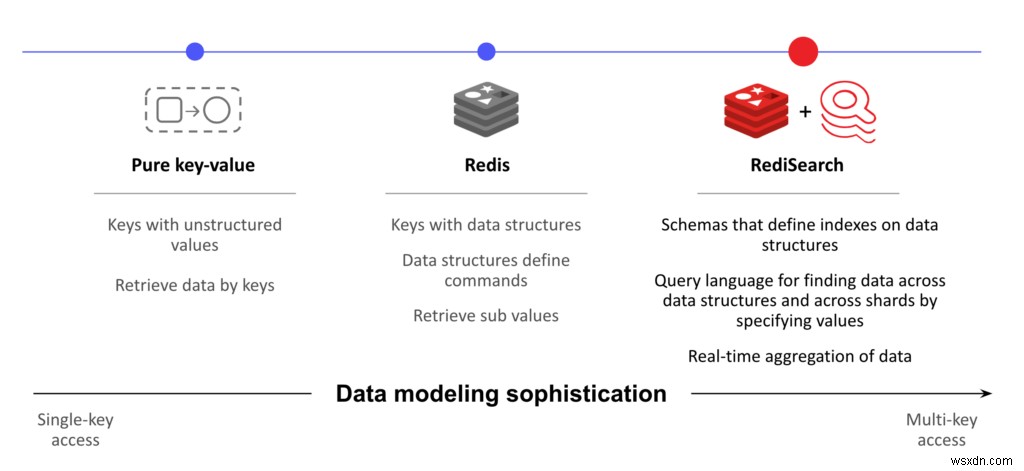
上図のように、RediSearchはキーの値部分に対して、全文検索、地理位置情報、数値、タグといった複数のインデックス戦略を提供することで、Redisにより高度なデータモデリングをもたらします。インデックスがない場合、Redisはすべてのクエリに対してSCAN操作を実行する必要があり、非常に低速かつ非効率です。また、これらのインデックスを手動で作成・管理するのは複雑で、ミスが発生しやすくなります。RediSearchはユーザーに代わってインデックスを管理し、クラスタ化されたデータベース内の複数のデータ構造を横断したクエリを可能にします。
技術スタックにRediSearchを追加することで、データ基盤がシンプルになり、リッチな検索体験によってアプリケーションを拡張でき、Redisが持つ分析力を最大限に引き出せます。開発者は、複数の技術、クエリ言語、データモデル、後付けの検索エンジンを行き来することなく、モダンアプリケーションを構築できるようになります。
RediSearchの使い方
C言語で記述されたRediSearchは、Trie(トライ木)などのインメモリデータ構造と最新の分散インデックス・クエリアルゴリズムを活用し、パフォーマンスを最優先に設計されています。その結果、既存の検索エンジンよりも5〜10倍高速に動作します(RediSearchの速度について詳しくは、「Search Benchmarking: RediSearch vs. Elasticsearch」をご覧ください)。低レイテンシのインデックス作成とデータクエリにより、頻繁に更新されるデータセットにも最適です。そして新しいRediSearch 2.0は、前バージョン比で2.4倍の高速化を達成しています。
RediSearchを使えば、Redis上の複数のデータ型のデータセットに対して素早くインデックスを作成できます(現在はハッシュに対応しており、今後はJSON、続いてStreamsへの対応も予定しています)。軽量なインデックス作成・削除のため、増分インデックス方式を採用している点も特長です。豊富なクエリ言語により、データを超高速で照会し、複雑な集計を実行したり、プロパティ、数値範囲、地理的距離によるフィルタリングを行ったりすることができます。
さらにRediSearchは、中国語、スペイン語、ロシア語、フランス語、ドイツ語など多数の言語に対応した全文インデックスと、ステミングベースのクエリ拡張をサポートしています。「ファジー」検索技術を活用したオートコンプリート候補の実装により、ユーザーの検索体験を一段と向上させることも可能です。
今回のリリースにより、RediSearchはこれまで以上にスケールしやすくなりました。RediSearch 2.0では、数百台のサーバー規模で数十億件のドキュメントをクエリ・インデックス化するまで迅速に拡張できます。Redis on Flashに対応しているため、コスト効率の高い運用も実現できます。また、Redis EnterpriseのActive-Active技術を活用すれば、地理的に分散された複数レプリカ間で99.999%(ファイブナイン)の可用性を確保しながらグローバルに展開でき、読み取り操作(クエリや集計)も書き込み操作(インデックス作成など)も、コンフリクト解決を意識することなく、ローカル環境のRediSearchと同等の速度で実行できます。
実世界でのRediSearch活用事例
さまざまなデータ型やデータ構造を横断したインデックス作成、クエリ、全文検索を可能にすることは、ユーザーがデータの力を引き出すうえで不可欠です。スケーリングの制限なく完全分散型で、サブミリ秒のレイテンシでこれらのクエリを実行できるRediSearchの能力は、まさにゲームチェンジャーといえるでしょう。
当社の顧客は、レガシーアプリケーションの高速化にとどまらず、次世代のリアルタイムアプリケーション構築にもRediSearchを活用しています。たとえばGoMechanicは、RediSearchを使って1,000万点の自動車部品データベースを横断的に検索しています(詳細はRediSearch 2.0のプレスリリースをご覧ください)。多くのeコマースアプリでは、カタログ内の数百万点の商品を対象としたインタラクティブな検索を提供し、ファジー検索によるオートコンプリート候補でユーザー体験を高めています。
RediSearchの一時的な検索機能により、インデックス作成は非常に軽量で、同一データベース内に数千のインデックスを持つことも可能です。たとえば、顧客の購入履歴に基づいてインデックスを素早く作成し、不要になった時点で失効させるといった柔軟な運用ができます。ある健康保険会社では、RediSearchを活用してウェブサイトやアプリ上で地理空間クエリを実行できるようにし、ユーザーが近隣の適切な医療機関を見つけられるようにしています。これらのユースケースはすべて、すでに大規模な本番環境で稼働中です。
RediSearch 2.0を始めよう
RediSearch 2.0を活用して、アプリケーションモダナイゼーションの取り組みを加速させましょう。すぐに試してみたい方は、RediSearchクイックスタートページをご覧ください。
-
Grafana用Redisデータソースで構築した実用的なアプリケーション3選
【2021年3月29日更新】https://coronavirusapi.com/ は最近、無料でのデータアクセスを終了し、登録済みの一次対応者のみが利用できる仕様に変更されました。残念ながら、これにより新型コロナウイルス感染症の症例可視化プロジェクトのデモは動作しなくなりましたが、RedisTimeSeriesデータをGrafanaのWorldmapパネルに表示したい場合には、本記事で紹介するヒントは他の多くの実装にも引き続き役立つでしょう。 以前の記事では、新しく登場したGrafana用Redisデータソースの概要と基本的な使い方を解説しました。 Grafana用Redisデータソース
-
サーバーレスRedis(Upstash)でFly.ioアプリをグローバルに実行する方法
Fly.ioは、アプリケーションを世界中に分散配置できる優れたプラットフォームです。アプリケーションがグローバルになれば、それを支えるデータもグローバルであることが求められます。通常のRedisをFly.ioアプリとして実行することも可能ですが、その場合はデータが単一リージョンに配置されてしまうという課題があります。一方、Upstash Redisのグローバルデータベースは世界各地へのレプリケーションに対応しているため、Fly.ioとの相性は抜群です。さらにRESTベースのSDKを採用しているため、ステートレスなランタイム環境でも接続の問題が発生しません。 この記事では、Upstash Red