
Count-Min Sketch:データ推定の芸術と科学
今回は、私の考える世界で最もエキサイティングな2つのトピック、確率的データ構造とRedisモジュールについてお話しします。どちらかをご存知の方なら私の熱意が伝わるはずですが、まだの方もどうぞ読み進めて、世界で最もクールな技術に触れてください。
大規模・低レイテンシデータ処理の課題
大規模かつ低レイテンシなデータ処理は困難です。関わるデータの量と速度が、リアルタイム分析を極めて要求の厳しいものにしています。高性能と汎用性により、Redisはこうした課題解決によく用いられます。サブミリ秒のレイテンシで多様なデータを格納、操作、提供できるため、オンライン計算が必要な場面で理想的なデータコンテナとなります。
しかし全ては相対的なもので、規模が極端になると正確なリアルタイム分析が現実的に不可能になります。複雑な問題は大きくなるほど難しくなりますが、単純な問題も同じ法則に従います。数値の合計のような基本的な操作でも、データが大きすぎたり、速すぎたり、リソースが足りなければ、莫大なタスクになり得ます。リソースは常に有限で高コストなのに対し、データは留まることを知らず増え続けます。
Count-Min Sketchとは
Count-Min Sketch(以下CM Sketch)は、その仕組みと使い方を理解すれば非常に有用な確率的データ構造です。
幸い、CM Sketchのシンプルな特性により、初心者でも比較的容易に理解できます(私の友人の多くはTop-Kのブログ記事についてこれませんでしたが)。

CM Sketchは数年前からRedisモジュールとして提供されており、最近ではRedisBloomモジュール v2.0の一部として書き直されました。CM Sketchの詳細に入る前に、なぜどの確率的データ構造を使うのかを理解することが重要です。速度、スペース、精度のトレードオフにおいて、確率的データ構造はわずかな精度を犠牲にしてスペースを、場合によっては大幅に獲得します。速度への影響はアルゴリズムとデータセットのサイズによって異なります。
- 精度: 定義上、データの一部のみを保持し、格納時の衝突を許容するため精度は低下します。しかしユースケースに応じて最大誤差率を設定可能です。
- メモリスペース: 数十億のイベントが記録されるビッグデータの世界では、部分的なデータのみを格納することで、ストレージ要件とコストを大幅に削減できます。
- 速度: 従来のデータ構造の中には比較的非効率に動作し、応答時間を遅くするものがあります(例:Sorted Setは全要素の順序を維持しますが、上位要素のみが必要な場合もあります)。確率的アルゴリズムは部分的なリストのみを維持するため効率的で、多くの場合クエリにより高速に答えられます。
適切な確率的データ構造を使えば、データセットの情報の一部のみを保持することで精度を少し犠牲にしつつ、大きなメリットを得られます。もちろん銀行口座の残高など、精度低下が許されないケースもあります。しかし映画のレコメンドやWebサイトでの広告表示のように、稀なミスのコストが低く、スペース削減効果が大きいケースには最適です。
基本的にCM Sketchは、データセット内の全アイテムの出現回数を複数のカウンター配列に集約します。クエリ時には全配列中の最小カウントを返すことで、衝突によるカウント増大を最小限に抑えます。出現率やスコアが低いアイテム("mouse flows")はカウントが誤差率未満となるため、実際のカウント情報は失われノイズとして扱われます。一方、出現率やスコアが高いアイテム("elephant flows")については、取得したカウントをそのまま利用できます。CM Sketchのサイズは一定で無限のアイテムに対応できるため、ストレージスペースの大幅な節約が見込めます。
背景として、スケッチはデータ構造とそのアルゴリズムの一種です。データの性質を捉え、定数または亜線形のスペースでデータに関する質問に答えます。CM SketchはGraham CormodeとS. Muthu Muthukrishnanによって2005年の論文「An Improved Data Stream Summary: The Count-Min Sketch and its Applications」で提案されました。
Count-Min Sketch:仕組みと動作
CM Sketchは主なユースケースをサポートするため、複数のカウンター配列を使用します。配列の数を「深さ(depth)」、各配列のカウンター数を「幅(width)」と呼びます。
アイテムを受信すると、ハッシュ関数(要素(単語、文、数値、バイナリ)を、配列内の位置やフィンガープリントとして使える数値に変換する関数)を用いてアイテムの位置を計算し、各配列の該当カウンターをインクリメントします。関連する各カウンターの値は、アイテムの真の値以上になります。問い合わせ時には、同じハッシュ関数で全配列を巡回し、アイテムに関連するカウンターを取得。遭遇した最小値を返します。値が膨らんでいる(か等しい)ことはわかっているためです。
異なるアイテムが同じ位置を受け取る自然な衝突により、多くのアイテムがほとんどのカウンターに寄与していることはわかっています。しかしこの「ノイズ」を、目標とする誤差率の範囲内に収まる限り許容します。
Count-Min Sketchの具体例
数学的に、深さ10、幅2,000の場合、誤差なしの確率は99.9%、誤差率は0.1%になります(これは総インクリメント数に対する割合で、ユニークアイテム数に対するものではありません)。
具体的な数字で見ると、100万ユニークアイテムを追加した場合、平均して各アイテムは500(100万÷2,000)の値を受け取ります。一見不均衡に見えますが、これは100万アイテム中1,000という0.1%の誤差率に十分収まっています。
同様に、10個の「象」がそれぞれ10,000回出現する場合、全セットでの値は10,000以上になります。将来それらをカウントすれば、「象」が目の前にいることがわかります。その他すべての数値(実カウントが1のすべての「ネズミ」)については、CM Sketchが最小カウントのみを考慮するため、すべてのセットで「象」と衝突する可能性は低く、深さを増やせばさらに確率は減少します。
Count-Min Sketchのユースケース
CM Sketchの振る舞いがわかったところで、この小さな怪物で何ができるか見てみましょう。主なユースケースは以下の通りです。
- 2つの数値を照会し、それらのカウントを比較する
- 着信アイテムの割合を設定する(例:1%)。アイテムの最小カウントが総カウントの1%を超える場合にtrueを返す。オンラインゲームのトッププレイヤー判定などに利用可能
- CM Sketchにmin-heapを追加してTop-Kデータ構造を作る。アイテムをインクリメントするたびに、新しい最小カウントがヒープの最小値より大きいかチェックし、それに応じて更新する。RedisBloomのTop-Kモジュールは時間経過で徐々に減衰するが、CM Sketchは決して忘れないため、HeavyKeeperベースのTop-Kとは挙動が異なる
RedisBloomにおけるCM SketchのAPIはシンプルで使いやすいです:
- CM Sketchデータ構造を初期化: INITBYDIM {key} {width} {depth} または CMS.INITBYPROB {key} {error} {probability}
- アイテムのカウンターを増加: CMS.INCRBY {key} {item} {increment}
- アイテムのカウンター中の最小カウントを取得: CMS.QUERY {key} {item}
冒頭のアニメーション例を作成するために使用したコマンドは以下の通りです:
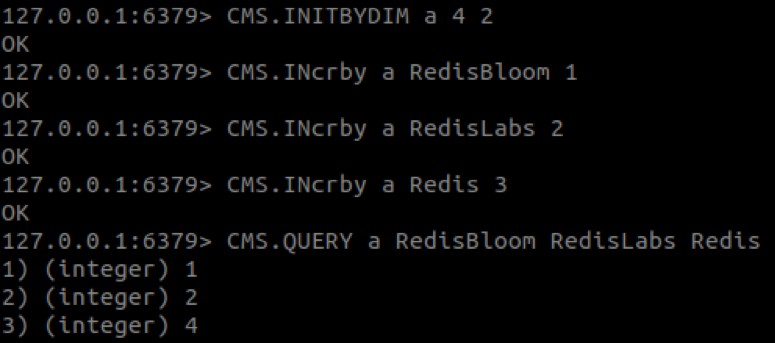
ご覧の通り、「Redis」の値は3ではなく4になっています。CM Sketchではアイテムのカウントが膨らむ傾向があるため、この振る舞いは期待通りです。
スケッチというビジネス
ソフトウェアエンジニアリングはトレードオフの連続です。コスト効率よく課題に対処する一般的なアプローチは、効率性のために精度を犠牲にすることです。このアプローチを体現するのが、RedisのHyperLogLog実装です。セットの基数(要素数)に関するクエリに効率的に答えるために設計されたデータ構造です。HyperLogLogは「スケッチ」と呼ばれるデータ構造ファミリーの一員で、現実世界のスケッチ(略画)が対象を近似して情報を伝えるのと同様に、データの近似を通じて情報を伝えます。
大まかに言えば、スケッチとはデータ構造(とそのアルゴリズム)であり、データそのものを格納せずにデータの性質、つまりデータに関する質問への答えを捉えます。形式的に言えば、スケッチは亜線形の漸近的計算計算量を持つため、計算能力やストレージを節約できるという点で有用です。しかしタダ飯はなく、効率化の代償として回答の精度が犠牲になります。しかし多くのケースでは、誤差を閾値以下に抑えられるなら許容されます。優れたデータスケッチは自らの誤差を率直に認め、実際多くのスケッチは誤差(またはその確率)をパラメータ化しており、ユーザーが定義できるようになっています。
優れたスケッチは効率的で誤差確率が有界ですが、卓越したスケッチは並列計算が可能なものです。並列化可能なスケッチとは、データの各部分で独立に準備でき、それらの部分を意味のある一貫性のある集計に結合できるものです。卓越したスケッチの各ピースは異なる場所や時間で計算できるため、並列性によってスケーリング課題を分割統治法でシンプルに解決できるようになります。
頻出アイテムというよくある問題
前述のHyperLogLogは卓越したスケッチですが、特定の種類の質問にしか答えられません。もう一つの貴重なツールが、G. CormodeとS. Muthukrishnanの論文「An Improved Data Stream Summary: The Count-Min Sketch and its Applications」で説明されているCount-Min Sketch(CMS)です。この独創的な仕組みは、サンプルの頻度に関する答えを提供するために考案されました。これは分析プロセスの大部分で共通する基盤となる構成要素です。
十分な時間とリソースがあれば、サンプルの頻度計算は単純です。各サンプル(観測されたもの)の観測回数(見られた回数)をカウントし、それを総観測数で割ればサンプルの頻度が得られます。しかし高スケール・低レイテンシなデータ処理の文脈では、時間もリソースも決して十分ではありません。データがストリーミングで流れる中、その規模に関わらず瞬時に答えを返す必要があり、サンプリング空間の巨大さゆえに、各サンプルごとにカウンターを持つことは非現実的です。
そこで各サンプルを正確に追跡する代わりに、頻度を推定しようとします。一つの方法は観測をランダムサンプリングし、そのサンプルが全体の性質を概ね反映することを期待することです。しかしこのアプローチの問題は、真のランダム性を確保するのが難しいため、ランダムサンプリングの成功が選択プロセスやデータ自体の性質によって制限される可能性があることです。そこに登場するのがCMSで、最初は卓越したスケッチの真逆のように見える、根本的に異なるアプローチを取ります:CMSは各観測を記録するだけでなく、それぞれを複数のカウンターに記録するのです!
もちろんひねりがあり、それは巧妙かつシンプルです。元の論文(およびその軽量版「Approximating Data with the Count-Min Data Structure」)が素晴らしい説明をしていますが、私も要約してみます。CMSの巧妙さはサンプルの格納方法にあります。各ユニークサンプルを独立して追跡する代わりに、そのハッシュ値を使用します。サンプルのハッシュ値を、定数サイズ(論文ではdでパラメータ化)のカウンター配列へのインデックスとして使用します。複数(パラメータw)の異なるハッシュ関数とそれぞれの配列を用いることで、構造へのクエリ時に見つかるハッシュ衝突を、サンプルに関連する全カウンターの中から最小値を選ぶことで処理します。
例で説明しましょう。シンプルなスケッチを作って内部動作を示します。パラメータを小さくしてシンプルに保ちます。w=3(3つのハッシュ関数h1、h2、h3を使用)、d=4とします。スケッチのカウンター格納には、全12要素を0で初期化した3×4の配列を使います。
サンプルがスケッチに追加される際の動作を見てみましょう。サンプルが一つずつ到着し、最初のサンプルs1のハッシュ値がh1(s1)=1、h2(s1)=2、h3(s1)=3だとします。s1をスケッチに記録するには、各ハッシュ関数の該当インデックスのカウンターを1増やします。以下の表は配列の初期状態と現在の状態を示します:
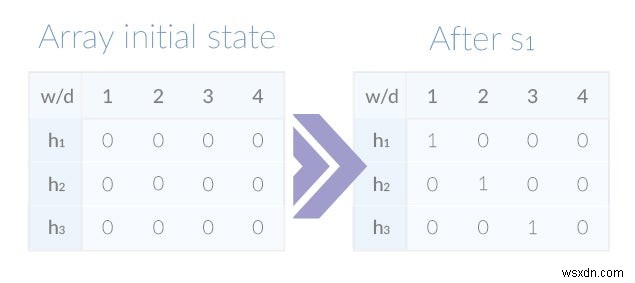
スケッチにはサンプルが1つしかありませんが、すでに効果的にクエリできます。サンプルの観測数は全カウンターの最小値であることを思い出してください。s1の場合:
min(array[1][h1(s1)], array[2][h2(s1)], array[3][h3(s1)]) =

min(array[1][1], array[2][2], array[3][3]) =

min(1,1,1) = 1スケッチはまだ追加されていないサンプルについてのクエリにも答えられます。h1(s2) = 4、h2(s2) = 4、h3(s2) = 4とすると、s2へのクエリは結果0を返します。s2とs3(h1(s3) = 1、h2(s3) = 1、h3(s3) = 1)を追加すると、以下のようになります:
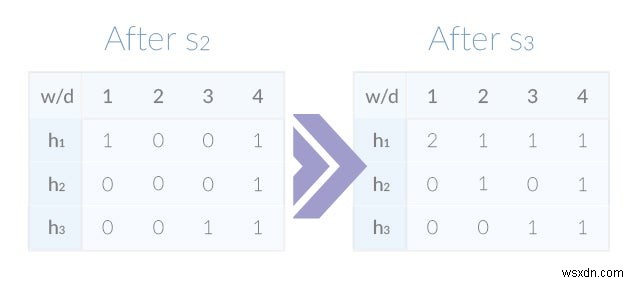
この作為的な例では、ほぼすべてのサンプルのハッシュがユニークなカウンターにマッピングされています。例外はh1(s1)とh1(s3)の衝突だけです。両方のハッシュが同じため、h1の1番目のカウンターは値2を保持します。スケッチは全カウンターの最小値を選ぶため、s1とs3へのクエリは依然として正しい結果1を返します。しかし十分な衝突が発生すると、クエリ結果の精度は徐々に低下します。
CMSの2つのパラメータ(wとd)が、スペース/時間要件、誤差の確率と最大値を決定します。より直感的な初期化方法は、誤差の確率と上限を指定し、そこから必要なwとdの値を導出させることです。並列化は可能です。同じパラメータとハッシュ関数で構築されている限り、任意の数の部分配列を配列の和として自明にマージできるためです。
Count-Min Sketchに関するいくつかの観察
Count-Min Sketchの効率性は、その要件を見れば明らかです。CMSの空間計算量は、w、d、使用するカウンターのビット幅の積です。例えば、誤差率0.01%、確率0.01%のスケッチは、10のハッシュ関数と2,000カウンターの配列で作られます。16ビットカウンターを使用すると、結果のスケッチデータ構造のメモリ要件は40KB程度です(総観測数といくつかのポインタを格納するために、さらに数バイト必要です)。計算面でも同様に優れています。ハッシュ関数の生成と計算が安価なため、読み書きどちらのデータ構造アクセスも定数時間で実行されます。
CMSにはさらに機能があります。論文の著者らは、パーセンタイル推定やヘビーヒッター(頻出アイテム)の特定など、類似の質問への回答にCMSをどう使えるかも示していますが、本稿の範囲外とします。
CMSは確かに卓越したスケッチですが、完璧さを阻む少なくとも2つの問題があります。私の最初の懸念は、CMSがバイアスを持つ可能性があり、観測数の少ないサンプルの頻度を過大評価しうることです。CMSのバイアスはよく知られており、いくつかの改良が提案されています。最新はCount-Min Log Sketch(G. PitelとG. Fouquierによる「Approximately counting with approximate counters」)で、CMSの線形レジスタを対数的なものに置き換えることで相対誤差を減らし、カウンターレジスタのビット幅を増やさずにより大きなカウントを扱えるようにします。
上記の懸念は(データ構造を理解する)誰もが共有するものですが、私の2つ目の懸念はRedisコミュニティ特有のものです。説明するにはRedis Modulesを紹介する必要があります。
Redisモジュール
Redis Modulesは今年のRedisConfでantirezによって発表され、文字通り私たちの世界をひっくり返しました。サーバーにロード可能なダイナミックライブラリに過ぎませんが、RedisユーザーがRedis自体より速く動き、これまで夢見たこともない領域へ踏み出せるようになりました。この投稿はモジュールの紹介や作り方の解説ではありませんが、こちら(およびこちら、このウェビナー)が参考になります。
Count-Min Sketch Redisモジュールを書きたかった理由はいくつかあります。極めて有用だからという以外に、学習体験とモジュールAPIの評価、そして何より新しいデータ構造をRedisにモデリングするのが純粋に楽しかったからです。このモジュールは、スケッチへの観測追加、クエリ、複数スケッチのマージのためのRedisインターフェースを提供します。
モジュールはスケッチのデータをRedis Stringに格納し、DMA(直接メモリアクセス)を使用してキーの内容を内部データ構造にマッピングします。まだ徹底的なパフォーマンスベンチマークは実施していませんが、ローカルでのテスト印象では、コアRedisコマンドと同等のパフォーマンスです。他のモジュール同様、countminsketchはオープンソースです。ぜひ試して、ハックしてみてください。
締めくくり前に、約束通りRedis特有のCMSへの懸念を共有します。この問題は他のスケッチやデータ構造にも当てはまりますが、CMSは使用前にセットアップ/初期化/作成が必要です。CMSパラメータのセットアップのような必須の初期化段階を要求することは、Redisの基本パターンの一つ、つまり「データ構造はオンデマンドで作成できるため、使用前に明示的に宣言する必要がない」というパターンを破ります。モジュールをよりRedisらしくし、このアンチパターンを回避するため、新しいスケッチが暗黙的に要求された場合(存在しないキーでCMS.ADDコマンドを使用した場合など)はデフォルトパラメータ値を使用し、同時に指定パラメータで新しい空のスケッチを作成することも可能にしています。
確率的データ構造、つまりスケッチは、ビッグデータの増大とレイテンシ予算の縮小に、効率的かつ十分な精度で対応できる驚異的なツールです。本稿で触れた2つのスケッチ、そしてBloom FilterやT-digestなどの他のスケッチは、現代のデータ活用者にとって不可欠なツールになりつつあります。モジュールを使えば、ネイティブ速度で動作し、データにローカルアクセスできるカスタムデータ型とコマンドでRedisを拡張できます。可能性は無限大で、不可能なことはありません。
Redisモジュールとその開発方法についてもっと知りたいですか?確率的かどうかに関わらず、議論したりRedisに追加したりしたいデータ構造はありますか?私のTwitterアカウントまたはメールで何でも気軽にご連絡ください。私は高可用性です 🙂
-
DBAとデータアーキテクトの進化:データ革命時代に求められる新スキルセット
企業の顧客、従業員、パートナーが使いやすいシステムを通じてデータにスムーズにアクセスできるとき、その陰には2人のプロフェッショナルの存在があります。それがデータベース管理者(DBA)とデータアーキテクトです。数千人、さらには数百万人規模のユーザーに対して、堅牢に構築されたデータベースを安定かつ安全に稼働させ続けることは重大な責任であり、あらゆる業界の企業が、利用者のニーズに応えるデータネットワークの設計と監視をこの2つの役割に依存しています。ビジネス界におけるデータ需要が急増するにつれ、最新のデータベース技術に対応するために必要なスキルも拡大し続けています。以下のインフォグラフィックでは、これ
-
科学を疑う力――偉大な発見はすべて「問い」から始まる
もしニュートンが「リンゴはなぜ地面に落ちるのだろう?」と自問しなかったら、どうなっていたでしょう。もしコロンブスが、地球は平らではなく丸いということを証明するために闘わなかったら?インターネットが誕生していなかったら?重力という概念が存在しなければ、人類は地上から離れることができず、月はおとぎ話の中だけの存在になっていたはずです。つまり、あらゆる革新的な発見は、必ず「一つの問い」から始まるのです。 「科学者とは、正しい答えを提示する者ではなく、正しい問いを発する者である。」―― クロード・レヴィ=ストロース 適切な問いを立てることこそが、良質な科学の核心です。鋭い問いは、受け入れられてきた常識