
GephiとSigma.jsで作る!プログラミング言語の影響グラフ可視化チュートリアル
はじめに:ネットワーク可視化の世界へようこそ
本記事では、GephiとSigma.jsというオープンソースツールを使って、プログラミング言語の影響グラフを作成する方法を解説します。過去から現在までの250以上のプログラミング言語が、どのように互いに影響を与え合ってきたのかを、インタラクティブなネットワーク図として探索できるようになります。
ネットワークは現代社会のあらゆる場所にある
今日のようなハイパー接続された世界では、ネットワークは現代生活に欠かせない存在となっています。
例えば私の一日の始まりを見てみましょう。まずロンドンの交通網を使って街へ向かい、お気に入りのカフェの支店に入ってChromebookでWi-Fiネットワークに接続し、その後いつも利用しているSNS(ソーシャルネットワーキングサービス)にログインしました。
ここ数十年で最も影響力のある企業の多くが、ネットワークの力によって成功を収めてきたことは周知の事実です。
- Facebook、Twitter、Instagram、LinkedInなどのSNSプラットフォームは、ソーシャルネットワークの「スモールワールド」特性を活かし、ユーザー同士(そして広告主)を効率的につないでいます。
- Googleは、PageRankというネットワークアルゴリズムによって関連性の高い検索結果を返す能力が、検索エンジン市場での初期の支配的地位獲得の一因となりました。
- Amazonは効率的な物流ネットワークにより、一部の大都市で当日配送を実現しています。
さらに、人工知能(AI)や機械学習の分野でもネットワークは極めて重要です。ニューラルネットワークは現在も活発に研究されている領域であり、コンピュータビジョンに不可欠な特徴検出アルゴリズムの多くは、画像の各部分をネットワークとしてモデル化することに依存しています。
量子力学、生化学的経路、生態系や社会経済システムといった幅広い科学現象も、ネットワークモデルを通じて理解することができます。
それほど重要なネットワークについて、どうすればより深く理解できるのでしょうか?
グラフ理論——ネットワークを学ぶ数学
ネットワークの数学的な研究は「グラフ理論」と呼ばれ、数学の中でも比較的取り組みやすい分野の一つです。この記事では、特別な予備知識がなくても読み進められるよう、基礎から丁寧に解説していきます。
使用するのはPython 3.xと、素晴らしいオープンソースソフトウェアであるGephiです。これらを組み合わせて、過去と現在のプログラミング言語が「影響」という糸でどう結ばれているかを可視化します。
そもそもネットワークとは何か?
先ほどの例からヒントが得られます。交通網は目的地が路線で結ばれたものです。ソーシャルネットワークは個人同士が人間関係で結ばれたものです。Googleの検索アルゴリズムは、どのウェブページが他のページへリンクしているかを見て、ページの「ランク」を評価します。
より一般的に言えば、ネットワークとはノード(頂点)とエッジ(辺)、つまり俗にいう「点と線」で記述できるあらゆるシステムのことです。
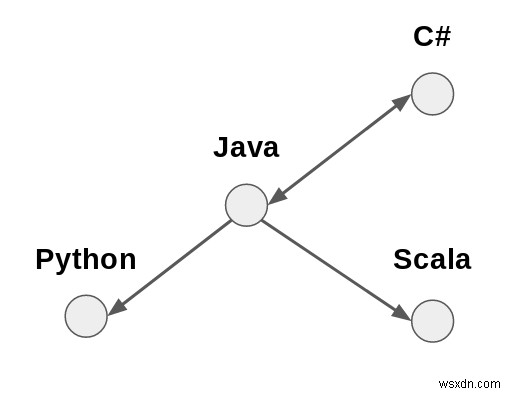
ソーシャルネットワークはこの抽象化が最も分かりやすい例でしょう。コンピュータのファイルシステムもそうです——フォルダとファイルは「親子」関係で結ばれています。
しかしネットワークの真の力は、一見すると抽象化が難しそうな非常に多くのシステムが、実はネットワークとしてモデル化できるという点にあります。
ネットワークの表現方法
紙とペンのスケッチを超えて、ネットワークを数学的に分析・記述するにはどうすればよいでしょうか?点と線の絵を、計算可能な数値へと変換する必要があります。
隣接行列(Adjacency Matrix)
一つの解決策が隣接行列です。「行列」と聞くと少し身構えるかもしれませんが、心配無用です。行列とは、一度に多くの計算を行える数値のグリッドだと考えればよいのです。
      Python Java Scala C#
Python     0    1     0  0
Java       0    0     0  1
Scala      0    1     0  0
C#         0    1     0  0
この行列では、行と列の交点が0または1になり、対応する言語同士がリンクしているかどうかを示します。先ほどの図と照らし合わせて確認してみてください。
多くの場面で隣接行列は優れた表現方法ですが、計算の観点では扱いにくいことがあります。例えばノードがわずか1,000個でも、行列の要素数は1,000²=100万個にもなります。
実際のシステムの多くはスパースネットワーク(疎なネットワーク)です。ほとんどのノードは、全ノードのごく一部としかつながりません。1,000ノードのスパースネットワークを隣接行列としてメモリに格納すると、100万バイトのデータが必要になりますが、その大部分はゼロです。もっと効率的な方法があるはずですね。
エッジリスト(Edge List)
その代替手段となるのがエッジリストです。名前の通り、どのノード同士がリンクしているかを単純に列挙したリストです。
Java, Python
Java, Scala
Java, C#
C#, Java
大規模なネットワークでは、こちらの方がはるかに計算効率が高くなります。もちろん、エッジリストから隣接行列を生成することも(その逆も)可能なので、どちらか一方を選ばなければならないわけではありません。
隣接リスト(Adjacency List)
もう一つの表現方法が隣接リストです。各ノードと、それがリンクするノードを並べて記述します。
Java: Python, Scala, C#
C#: Java
データ収集と接続基準の設計
どんなネットワークモデルや可視化も、構築に使うデータの質以上のものにはなりません。データの正確性と完全性を確保するとともに、ノード間のエッジを推定する根拠(リンケージ基準)を正当化する必要があります。
これは多くの意味で最も重要なステップです。その後のすべての分析や推論は、このリンケージ基準に依存します。
例えば、ソーシャルネットワーク分析では「SNSで相互フォローしているか」で人をつなぐかもしれません。分子生物学では「遺伝子の共発現」に基づいて遺伝子をつなぐでしょう。
また、ノードをつなぐ手法によっては、エッジに重み(weight)を割り当て、「強さ」を測定できる場合があります。オンライン小売の文脈なら、一緒に購入される頻度で商品をつなぎ、よく一緒に買われる商品ほど重みの大きいエッジで結び、偶然以上に一緒に買われない商品はリンクしない、といった具合です。
本チュートリアルでは、よりシンプルなアプローチを採用します。Wikipediaの正確性に頼るのです。
この目的においては十分でしょう。Wikipediaの成功は、何かを正しくやっている証拠です。記事が書かれるオープンソースの協働方式は、一定の客観性を保証してくれます。さらに、比較的一貫したページ構造はWebスクレイピングの練習場として最適ですし、充実したドキュメント付きのWikipedia APIが情報取得をさらに容易にしてくれます。
ステップ1:Gephiのインストール
GephiはLinux、Mac、Windowsで利用できます。公式サイトからダウンロードしてください。
筆者はLubuntuを使用しました。Ubuntu/Debianをお使いの場合は、以下の手順でGephiを起動できます。それ以外の環境でも、インストール手順はお使いのOSで慣れた方法とほぼ同じはずです。
最新版(執筆時点ではv0.9.1)をダウンロードし、ファイルを展開します。
cd Downloads
tar -xvzf gephi-0.9.1-linux.tar.gz
cd gephi-0.9.1/bin./gephi
Java JREのバージョン確認が必要な場合があります。Gephiは新しいバージョンを要求します。筆者の比較的新しいLubuntu環境では、default-jreをインストールするだけで動作しました。
apt install default-jre
./gephi
始める前にあと一歩。グラフをWebへエクスポートするために、Gephi用のSigma.jsプラグインを導入します。
- Gephiのメニューバーから「Tools」→「Plugins」を選択します。
- 「Available Plugins」タブを開き、「SigmaExporter」を選択します(JSON Exporterも入れておくと便利です)。
- 「Install」ボタンを押して案内に従い、完了後にGephiを再起動します。
ステップ2:Pythonスクリプトの作成
このチュートリアルではPython 3.xといくつかの便利なモジュールを使います。pipで以下のコマンドを実行しましょう。
pip3 install wikipedia新しいディレクトリにscript.pyなどの名前でファイルを作成し、お好みのコードエディタで開きます。全体のロジックは以下の通りです。
- 対象とするプログラミング言語のリストを取得する
- リストを順に処理し、各言語のWikipedia記事のHTMLを取得する
- そこから、その言語が影響を与えた言語のリストを抽出する(簡易的なリンケージ基準)
- ついでに、各言語のメタデータも取得する
- 収集したデータをすべてCSVファイルに書き出す
モジュールのインポート
script.pyで、まず作業を楽にするいくつかのモジュールをインポートします。
import csv
import wikipedia
import urllib.request
from bs4 import BeautifulSoup as BS
import re
ノードリストの作成
次に、含めるノードのリストを作ります。ここでwikipediaモジュールが役立ちます。Wikipedia APIへのアクセスが非常に簡単になるからです。
pageTitle = "List of programming languages"
nodes = list(wikipedia.page(pageTitle).links)
print(nodes)
保存して実行すると、「List of programming languages」記事からのすべてのリンクが出力されます。素晴らしい!
ただし、自動収集したデータは必ず目視で確認しましょう。見てみると、実際のプログラミング言語に加えて余分なリンクも混ざっています。例えば「List of markup languages」「Comparison of programming languages」などです。
Gephi側で不要なノードを削除することもできますが、事前にデータを「クリーンアップ」しておけば後々の手間が省けます。
removeList = [
    "List of",
    "Lists of",
    "Timeline",
    "Comparison of",
    "History of",
    "Esoteric programming language"
    ]

nodes = [i for i in nodes if not any(r in i for r in removeList)]
削除したい部分文字列のリストを定義し、それを含む要素をデータから取り除きます。Pythonならたった1行で書けるのが魅力です!
ヘルパー関数の定義
次に、Wikipediaをスクレイピングしてエッジリストを構築するための関数を定義します。
HTMLの取得
最初の関数はBeautifulSoupモジュールを使って、各言語のWikipediaページのHTMLを取得します。
base = "https://en.wikipedia.org/wiki/"

def getSoup(n):
    try:
        with urllib.request.urlopen(base+n) as response:
            soup = BS(response.read(),'html.parser')
            table = soup.find_all("table",class_="infobox vevent")[0]
            return table
     except:
         pass
urllib.requestモジュールで https://en.wikipedia.org/wiki/ + 言語名 のページHTMLを取得し、BeautifulSoupに渡して解析可能なオブジェクトに変換します。
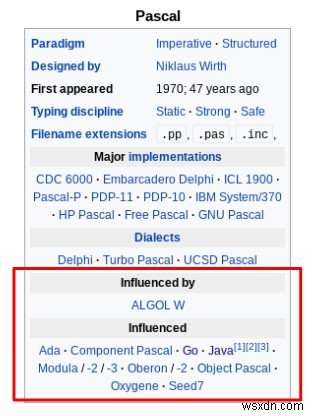
続いてfind_all()メソッドで、注目すべきHTML要素を抽出します。ここでのターゲットは、各プログラミング言語記事の冒頭にある概要テーブルです。どうやって特定するか?
最も簡単なのは、実際に言語のページを開き、ブラウザの開発者ツールで要素を調べることです。概要テーブルは<table>タグで、CSSクラスに"infobox"と"vevent"を持っているため、これらを目印にできます。
- 引数には
"table"と class_="infobox vevent"を指定します
find_all()は条件に一致する全要素のリストを返すので、目的の要素を指定するためにインデックス[0]を付けます。成功すればtableオブジェクトを、失敗すればNoneを返します。
自動データ収集では例外処理が極めて重要です。怠ると、最良の場合でもスクリプトが途中で落ちてやり直し。最悪の場合、矛盾とエラーだらけのデータセットができ上がり、後の作業が悪夢になります。
メタデータの取得
次の関数はtableオブジェクトからメタデータを探します。ここでは、言語が最初に登場した年を検索します。
def getYear(t):
    try:
        t = t.get_text()
        year = t[t.find("appear"):t.find("appear")+30]
        year = re.match(r'.*([1-3][0-9]{3})',year).group(1)
        return int(year)
    except:
return "Could not determine"この短い関数はtableオブジェクトを引数に取り、BeautifulSoupのget_text()で文字列を生成します。次にyearという部分文字列を作り、"appear"という単語が最初に出現する位置から30文字を取り出します。この中に言語の初登場年が含まれているはずです。
年だけを抜き出すには、正規表現(reモジュール)を使い、1〜3の数字で始まり3桁の数字が続くパターンにマッチさせます。
re.match(r'.*([1-3][0-9]{3})',year)成功すればyearを整数で返し、失敗すれば悲しげな「Could not determine」を返します。パラダイム、設計者、型付け規律など、さらなるメタデータを取得してもよいでしょう。
リンクの収集
もう一つ関数を追加します。今度はある言語のtableオブジェクトを渡すと、その言語が影響を与えた他のプログラミング言語のリストを受け取れます。
def getLinks(t):
    try:
        table_rows = t.find_all("tr")
        for i in range(0,len(table_rows)-1):
            try:
                if table_rows[i].get_text() == "\nInfluenced\n":
                    out = []
                    for j in table_rows[i+1].find_all("a"):
                        try:
                            out.append(j['title'])
                        except:
                            continue
                    return out
            except:
                continue
        return
    except:
        return
ネストが深くて圧倒されそうですが、何をしているのか順に見ていきましょう。
この関数は、tableオブジェクトが一貫した構造を持つことを利用します。テーブルの情報は行(HTMLタグは<tr>)に格納されており、そのうちの一つの行には"\nInfluenced\n"というテキストが含まれます。関数の前半は、その行がどこにあるかを特定します。
その行が見つかれば、次の行には現在の言語が影響を与えた各言語へのリンクが含まれていると確信できます。find_all("a")でリンクを探します。引数"a"はHTMLタグ<a>に対応します。
各リンクjについて、その["title"]属性をoutというリストに追加します。["title"]属性に着目する理由は、これがnodesに格納されている言語名と完全に一致するからです。
例えばJavaはnodes内では"Java (programming language)"として格納されているため、データセット全体でこの正確な名前を使う必要があります。
成功すればgetLinks()は言語のリストを返します。残りの部分は、どの段階で問題が起きても対処できるようにする例外処理です。
データ収集の実行
いよいよスクリプトに仕事を任せる準備が整いました。収集したデータは2つのリストオブジェクトに格納します。
edgeList = [["Source,Target"]]
meta = [["Id","Year"]]次に、先ほど定義した関数をnodesの各項目に適用し、結果をedgeListとmetaに格納するループを書きます。
for n in nodes:
    try:
        temp = getSoup(n)
    except:
        continue
    try:
        influenced = getLinks(temp)
        for link in influenced:
            if link in nodes:
                edgeList.append([n+","+link])
                print([n+","+link])
    except:
        continue
    year = getYear(temp)
meta.append([n,year])このループはnodes内の各言語について、Wikipediaページから概要テーブルの取得を試みます。そして、そのテーブルに「影響を受けた言語」として列挙されている言語をすべて取得します。
そのうちnodesリストにも登場する言語については、["source,target"]形式でedgeListに要素を追加します。こうしてGephiに投入するエッジリストが構築されていきます。
デバッグのため、追加される各要素を出力しておくと安心です。念入りに行うなら、except節にもprint文を追加するとよいでしょう。続いて言語名と年を取得し、metaリストに追加します。
CSVへの書き出し
ループ完了後の最終ステップは、edgeListとmetaの内容をCSVファイルに書き出すことです。最初にインポートしたcsvモジュールで簡単に実現できます。
with open("edge_list.csv","w") as f:
    wr = csv.writer(f)
    for e in edgeList:
        wr.writerow(e)

with open("metadata.csv","w") as f2:
    wr = csv.writer(f2)
    for m in meta:
        wr.writerow(m)
完成です!スクリプトを保存し、ターミナルから実行します。
$ python3 script.py
エッジリストが構築されていく様子が、source-targetペアの出力として流れてくるはずです。インターネット接続を安定させて、スクリプトの魔法を見守りましょう。
ステップ3:Gephiでグラフを構築
Gephiのインストールと起動が済んでいれば、新規プロジェクトを作成し、集めたデータで有向グラフを構築できます。さまざまなプログラミング言語が互いにどう影響し合ったかが見えてきます!
- Gephiで新規プロジェクトを作成し、「Data Laboratory」ビューに切り替えます。スプレッドシート風のインターフェースでデータを操作できます。
- 「Import spreadsheet」をクリックし、Pythonスクリプトが生成した
edge_list.csvを選択します。区切り文字としてカンマを使う設定になっていることを確認してください。 - List typeで「Edge List」を選びます。
- 「Next」をクリックし、Source列とTarget列の両方が文字列としてインポートされることを確認します。
これでData Labにノードのリストが反映されます。続いてmetadata.csvをインポートします。今度はList typeで必ず「Nodes list」を選んでください。
「Preview」タブに切り替えて、ネットワークの見た目を確認してみましょう。
あれ……ちょっと……モノクロで、ごちゃごちゃしてますね。まるで皿いっぱいのスパゲッティ。直しましょう。
見た目を整える
プレゼンテーションの改善方法は無数にあり、ここからは創造性の見せ所です。ネットワーク可視化で考慮すべき要素は本質的に3つあります。
- 配置(Positioning) ネットワークのレイアウトパターンを生成するアルゴリズムがいくつもあります。人気のある選択肢はFruchterman-Reingoldアルゴリズムで、Gephiでも利用可能です。
- サイズ(Sizing) グラフ内のノードの大きさで、興味深い特性を表現できます。多くの場合これは中心性(centrality)指標です。中心性の測り方は多岐にわたりますが、いずれもネットワーク全体とのつながりの強さという観点で、そのノードの「重要性」を反映します。
- 色分け(Coloring) 色でノードの特性を示すこともできます。多くの場合、色はコミュニティ構造の表示に使われます。コミュニティ構造とは大まかに「グラフの他の部分よりも互いに密につながったノードのグループ」です。ソーシャルネットワークなら、友人関係・家族・職業グループなどが明らかになります。コミュニティ構造を検出するアルゴリズムは複数あり、GephiにはLouvain法が組み込まれています。
これらの変更には統計量の計算が必要です。「Overview」ウィンドウに切り替えると右側にパネルがあり、「Statistics」タブが見つかるはずです。開くといろいろなオプションが並んでいます。
Gephiには豊富な統計機能が組み込まれており、それぞれ「Run」をクリックすると、ネットワークに関する洞察を明らかにするレポートが生成されます。知っておくと便利なものを紹介します。
- 平均次数(Average degree) 平均的な言語は約4つの言語とつながっています。レポートには次数分布グラフも表示され、大多数の言語はつながりが非常に少なく、ごく一部が多数のつながりを持つことが分かります。これはスケールフリーネットワークの特徴で、その生成メカニズムについては多くの研究が行われています。
- 直径(Diameter) このネットワークの直径は12です。つまり任意の2言語間の最大のつながりの広がりを表します。平均経路長は4弱で、平均的に任意の2言語は4本のエッジで隔てられています。これらの数値はネットワークの「大きさ」の指標となります。
- モジュラリティ(Modularity) ネットワークがどれだけ「区分化」されているかを示すスコアです。ここでは約0.53と比較的高く、ネットワーク内に明確なモジュールが存在することを示唆します。これも根底にあるシステムの興味深い性質です。言語ははっきりとした「影響グループ」に分かれる傾向があるのです。
さて、ネットワークの外観を変更するには左側のパネルへ移動します。
「Layout」タブでレイアウトアルゴリズムを選択できます。「Run」を押すとグラフがリアルタイムで動き出します!どのアルゴリズムが最適か、試してみてください。
Layoutタブの上にある「Appearance」タブでは、ノードとエッジの色・サイズ・ラベルのさまざまな設定を試せます。属性(Gephiに計算させた統計値を含む)に基づいて設定できます。
提案としては:
- Modularity属性でノードを色分けする——コミュニティへの所属に応じて色が付きます。
- Degreeでノードのサイズを変える——つながりの多いノードほど大きく表示されます。
とはいえ、自分で実験して、一番気に入るレイアウトを見つけてください。
グラフの見た目に満足したら、いよいよ最終ステップ——Webへのエクスポートです!
ステップ4:Sigma.jsでWeb公開
これでGephi上で探索できるネットワーク可視化が完成しました。スクリーンショットを撮ったり、SVG・PDF・PNG形式で保存したりすることもできます。
しかし、先ほどSigma.jsプラグインをインストールしたなら、ぜひHTMLへエクスポートしてみましょう。オンラインでホストしたり、GitHubにアップロードして共有したりできる、インタラクティブな可視化が手に入ります。
手順は、Gephiのメニューバーから「Export > Sigma.js template…」を選択するだけです。
必要事項を入力します。エクスポート先のディレクトリ指定を忘れずに。タイトル、凡例、説明、ホバー時の挙動など、細部は自由に変更できます。準備ができたら「OK」をクリック。
エクスポート先のディレクトリに移動すると、Sigma.jsが生成したすべてのファイルを含むフォルダがあります。
お好みのブラウザでindex.htmlを開いてください。じゃじゃーん!あなたのネットワークの完成です!CSSとJavaScriptを少し知っていれば、生成された各種ファイルを掘り下げて、出力を思い通りに調整することもできます。
まとめ
- 多くのシステムはネットワークとしてモデル化・可視化できます。グラフ理論は、ネットワークの構造や特性を理解するための道具を提供する数学の一分野です。
- PythonでWikipediaからデータをスクレイピングし、プログラミング言語の影響グラフを構築しました。リンケージ基準は「ある言語が別の言語の設計に影響を与えたと列挙されているか」でした。
- GephiとSigma.jsは、ネットワークの分析と可視化を可能にするオープンソースツールです。画像・PDF・Web形式でのエクスポートにも対応しています。
最後までお読みいただきありがとうございました。コメントや質問をお待ちしています!グラフ理論をさらに学ぶには、Albert-László Barabási氏のインタラクティブなオンライン書籍が素晴らしいリソースです。
本チュートリアルの完全なコードはgistで公開されています。
-
Rubyでのプログラミング言語の構築:インタープリター、パート2
Githubのフルソース Stoffleプログラミング言語の完全な実装は、GitHubで入手できます。バグを見つけたり質問がある場合は、遠慮なく問題を開いてください。 このブログ投稿では、Rubyで完全に構築されたおもちゃのプログラミング言語であるStoffleのインタープリターを引き続き実装します。以前の投稿で通訳を始めました。このプロジェクトの詳細については、このシリーズの最初の部分をご覧ください。 前回の投稿では、Stoffleのより単純な機能(変数、条件、単項および二項演算子、データ型、コンソールへの出力)を実装する方法について説明しました。今度は、袖をまくり上げて、関数定義、
-
Rubyで新しいプログラミング言語を作る:インタプリタ編
GitHubで完全なソースコードを公開中 Stoffleプログラミング言語の完全な実装はGitHubで公開しています。バグを見つけたり、疑問点がある場合は、ぜひIssueを立ててください。 この記事では、Rubyだけで作られたおもちゃのプログラミング言語「Stoffle」のインタプリタ実装を始めます。このプロジェクトについては、シリーズ第1回目の記事で詳しく紹介しているので、まだ読んでいない方はそちらもチェックしてみてください。 今回構築するのは、いわゆる「ツリーを辿るインタプリタ(tree-walk interpreter)」と呼ばれるものです。前回の記事では、フラットなトークンの